2.1 INSERT 的四种姿势:单行、多行、搬运与冲突
2.1 INSERT 的四种姿势:单行、多行、搬运与冲突
本节摘要:往表里写数据远不止"INSERT INTO 表 VALUES 一行"这一种形态。单行插入是起点,多值批量是一条语句写百行的效率武器,INSERT ... SELECT 让查询结果直接落表,UPSERT 则化解"存在就更新、不存在就插入"的并发难题。选对姿势,数据入库的速度与正确性都会上一个台阶。
一、把数据放进表里的四种方式
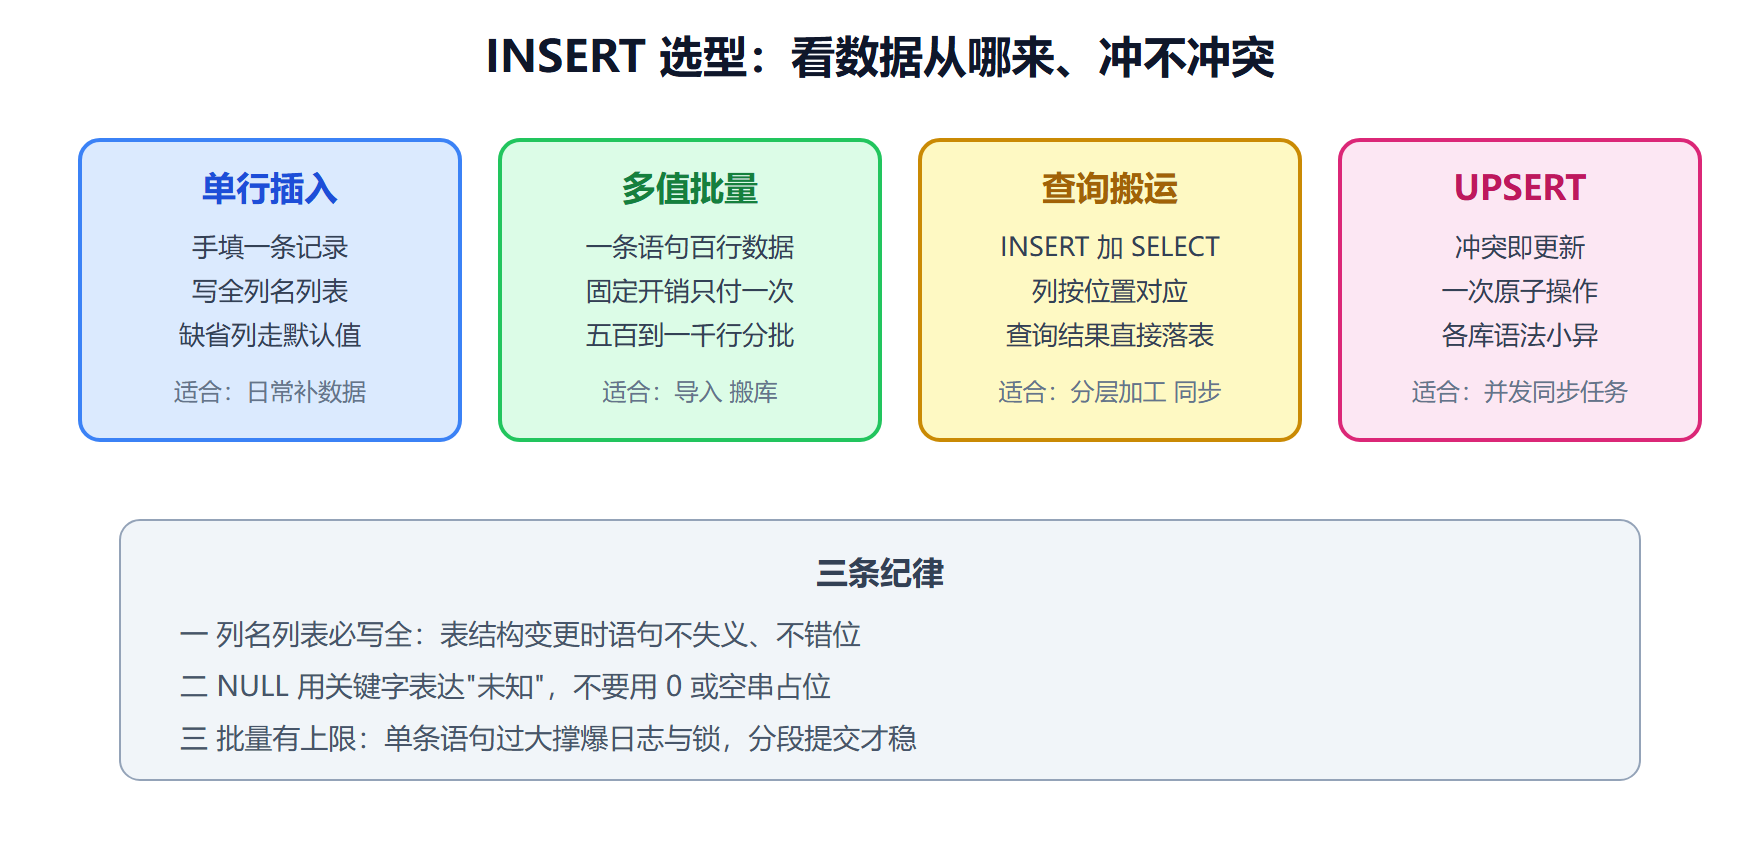
按使用频率排座次,INSERT 的四种姿势分别是:单行插入(最常用也最简单)、多值批量(导入数据的效率担当)、查询搬运(INSERT ... SELECT,数据管道的基石)、冲突处理(UPSERT,同步任务离不开)。本节依次演练,全程在 books 与 categories 表上实操。
姿势一:单行插入,务必写全列名列表
-- 标准单行插入:列名列表与值一一对应 INSERT INTO categories (id, name, parent_id) VALUES (1, '计算机', NULL); -- 顶层分类没有上级,parent_id 为 NULL INSERT INTO categories (id, name, parent_id) VALUES (2, '数据库', 1); -- 二级分类,挂在"计算机"之下
Query OK, 1 row affected (0.01 sec) Query OK, 1 row affected (0.00 sec)
很多人偷懒省略列名列表,写成 INSERT INTO categories VALUES (...)。这在表结构一变的那一刻就成为隐患:将来 books 加了 author 列,所有省略列名的 INSERT 立刻报错或更糟——错位插入。列名列表是插入语句与表结构之间的契约,写全它,语句的含义不随表结构漂移。
再看 NULL 的正确入库方式:parent_id 直接写 NULL 关键字,不是数字 0,也不是字符串 'NULL'。"没有上级"是未知/不存在,用 NULL 表达;如果用 0 占位,第 8 章的递归查询就得处处特判 id 为 0 的行。
姿势二:多值批量,一条语句顶一百句
-- 一条语句插入多行:每组值用逗号分隔 INSERT INTO books (title, category_id, price, stock, published_at) VALUES ('数据库系统概念', 2, 89.00, 12, '2019-03-01'), ('SQL必知必会', 2, 49.00, 35, '2020-06-15'), ('算法导论', 3, 128.00, 8, '2012-01-01'), ('计算机网络', 3, 79.00, 21, '2014-08-01');
Query OK, 4 rows affected (0.02 sec) Records: 4 Duplicates: 0 Warnings: 0
注意这次没写 id 列——自增主键会自动分配 1、2、3、4,回执里的 Records: 4 确认四行全部落表。批量插入比循环执行四条单行 INSERT 快得多:每条语句都有解析、网络往返、事务提交的固定开销,合并成一条后开销只付一次。批量导入几万行时,这个差距从"毫秒级"拉大到"分钟级"。
量级感参考:逐行插入一万行约需一万次往返,批量写成每条一千行只需十次;代价是单条语句太大也会撑爆日志与锁持有时间,实践中常按五百到一千行一段分批。
姿势三:INSERT ... SELECT,查询结果的落表通道
书店要做一张"高价书观察表",专门盯价格超过 80 元的书。手工抄写既慢又容易漏,正确姿势是让查询自己把结果搬过去:
-- 先建目标表 CREATE TABLE pricey_books ( id INT UNSIGNED PRIMARY KEY, title VARCHAR(120), price DECIMAL(10,2) ); -- 查询结果直接落表:WHERE 负责筛选,SELECT 负责投影 INSERT INTO pricey_books (id, title, price) SELECT id, title, price FROM books WHERE price > 80;
Query OK, 2 rows affected (0.03 sec) SELECT * FROM pricey_books; +----+-----------------------+----------+ | id | title | price | +----+-----------------------+----------+ | 1 | 数据库系统概念 | 89.00 | | 3 | 算法导论 | 128.00 | +----+-----------------------+----------+
INSERT 与 SELECT 的列按位置对应,不按名字对应——SELECT 出来的第二列进了 title,与它叫什么无关。数据仓库的每一层(明细层、汇总层、集市层)之间,靠的都是这条通道,第 8 章讲 CTE 时你会再次用到"查询的结果当表用"这个思想。
姿势四:UPSERT,冲突时不必先查再插
同步任务里最尴尬的场面:想插入一条记录,它却已经存在,于是主键冲突报错。朴素的解法是"先 SELECT 查存在性,再决定 INSERT 或 UPDATE"——两步之间一旦有并发插入,判断就失效。UPSERT 把两步合成一条原子语句:
-- MySQL 语法:主键或唯一键冲突时,转为执行更新 INSERT INTO books (id, title, category_id, price, stock, published_at) VALUES (2, 'SQL必知必会', 2, 52.00, 30, '2020-06-15') ON DUPLICATE KEY UPDATE price = VALUES(price), -- 冲突时把价格刷成新值 stock = VALUES(stock); -- 库存也刷新
Query OK, 2 rows affected (0.01 sec) -- 回显 2 rows:一行被更新时 MySQL 记为"删除旧行+插入新行"两个动作
id=2 的书已在表中,这条语句没有报错,而是把价格从 49.00 改成了 52.00、库存从 35 改成 30。PostgreSQL 的对应语法是 ON CONFLICT (id) DO UPDATE SET ...,SQLite 用 ON CONFLICT DO UPDATE,思想完全一致:把"存在性判断 + 写入"交给数据库在一次原子操作里完成。
图 2-1 INSERT 四姿势选型卡
二、插入被拒绝的三种时刻
知道为什么失败,比知道怎么成功更能体现熟练度。三种高频报错值得逐个见过:
-- 场景一:主键冲突 INSERT INTO categories (id, name, parent_id) VALUES (1, '文学', NULL); -- ERROR 1062 (23000): Duplicate entry '1' for key 'categories.PRIMARY' -- 场景二:非空列缺值 INSERT INTO categories (id, parent_id) VALUES (9, NULL); -- ERROR 1364 (HY000): Field 'name' doesn't have a default value -- 场景三:外键约束挡下脏数据 INSERT INTO books (title, category_id, price, stock) VALUES ('幽灵书', 99, 19.00, 5); -- ERROR 1452 (23000): Cannot add or update a child row: a foreign key -- constraint fails (category_id 99 在 categories 中不存在)
三次插入全部失败,表中原有数据分毫未动
三种报错对应第 1 章讲的三层防线:主键护唯一、NOT NULL 护完整、外键护关联。被数据库拒绝不丢人,丢的是把非法数据写进去的那一刻。
💡 关键直觉:把 INSERT 读成"把一行新事实提交给数据库审核"。列名列表是申请单,约束是审核标准,回执是审核结果。带着这个画面,报错信息就不再是天书,而是审核意见。
本节要点回顾
- 单行插入写全列名列表:语句含义不随表结构漂移,这是最便宜的安全带;
- 多值批量合并固定开销:百行数据一条语句,导入场景快一个量级,分段五百到一千行较稳;
- INSERT ... SELECT 是数据管道:列按位置对应,查询结果直接成表,数仓分层的基本功;
- UPSERT 化解并发冲突:MySQL 用 ON DUPLICATE KEY UPDATE,PostgreSQL 用 ON CONFLICT,思想同为原子化"判断 + 写入";
- 三种高频报错即三层防线:主键唯一、NOT NULL 完整、外键关联,被拒即被保护。
数据进来了,下一步是改和删。下一节的安全纪律,请当作比语法更重要的内容来读。