7.1 OVER 开窗与分区:聚合的第二种形态
7.1 OVER 开窗与分区:聚合的第二种形态
本节摘要:在聚合函数后面加 OVER(...),它就从"折叠器"变成"开窗器"——在窗口内计算汇总值,再把结果贴回每一行,行数不变。PARTITION BY 把全表窗切成一个个组内窗,窗内 ORDER BY 给行排定先后。窗口函数在逻辑上执行于 SELECT 阶段附近,因此不能写进 WHERE,筛选用派生表套一层。本节建立窗口函数的完整心智模型。
一、GROUP BY 留下的遗憾
第 4 章的报表需求在本章开场再挂一次:"每本书的价格,旁边配上它所属分类的平均价。"GROUP BY 的解法与它的别扭:
-- 旧解法:表查两遍再拼接(第6章派生表写法的简化版) SELECT b.title, b.price, cat.avg_price FROM books b JOIN (SELECT category_id, ROUND(AVG(price),2) AS avg_price FROM books GROUP BY category_id) cat ON cat.category_id = b.category_id;
-- 窗口函数解法:一次扫描 行数不变 SELECT title, category_id, price, ROUND(AVG(price) OVER (PARTITION BY category_id), 2) AS 分类均价 FROM books;
+-----------------------+-------------+----------+--------------+ | title | category_id | price | 分类均价 | +-----------------------+-------------+----------+--------------+ | SQL必知必会 | 2 | 52.00 | 70.50 | | 数据库系统概念 | 2 | 89.00 | 70.50 | | 算法导论 | 3 | 128.00 | 82.33 | | 计算机网络 | 3 | 79.00 | 82.33 | | 操作系统导论 | 3 | 20.00 | 82.33 | +-----------------------+-------------+----------+--------------+
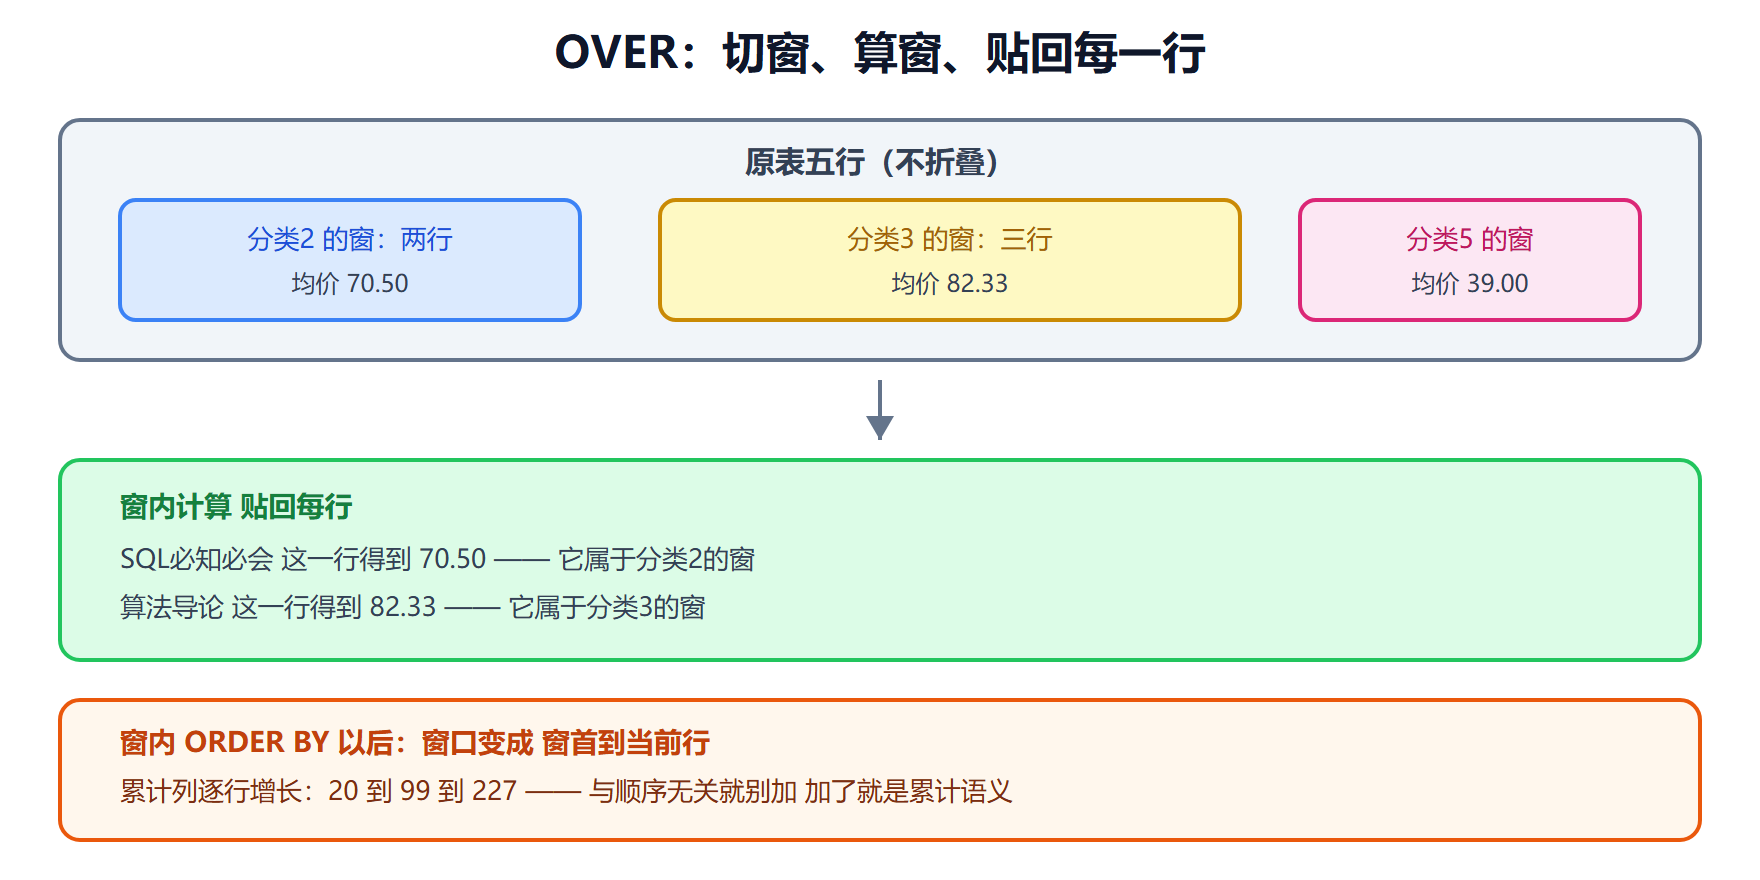
输出五行——与原表行数一致,没有一行被折叠;每一行都带着自己分区的均价。读懂 OVER 的读法是关键:AVG(price) OVER (PARTITION BY category_id) 拆成两半——AVG(price) 说"算什么"(沿用第 4 章的全部聚合函数),OVER (...) 说"在哪个范围内算"。PARTITION BY category_id 的含义是:按分类把表切成几个互不重叠的"窗",每行在自己的窗内参与计算,窗与窗之间互不打扰。分类 2 的窗里只有两本书,均价 70.50;分类 3 的窗里三本,均价 82.33。
GROUP BY 与窗口函数的对照从此可以一张表说尽:
| 维度 | GROUP BY | 窗口函数 OVER |
|---|---|---|
| 输出行数 | 每组一行,行被折叠 | 与原表相同,行全保留 |
| SELECT 列限制 | 只能分组列加聚合 | 明细列与窗口值同屏 |
| 语义 | "每组给个结论" | "每行配个参照" |
| 典型场景 | 汇总报表 | 明细加参照、组内比较 |
空括号 OVER() 也是一种窗——全表窗:AVG(price) OVER() 对每行都给出全表均价。分区是刀,切或不切由业务决定。
窗内 ORDER BY:窗口的另一半
只写 PARTITION BY 时,窗是"一筐无序的行",适合 AVG、SUM 这类与顺序无关的聚合。加上 ORDER BY 后,窗口获得"从窗首到当前行"的动态边界,聚合结果逐行累积——这是窗口函数最精妙也最容易被误解的机制:
-- 窗内 ORDER BY:按价格升序的组内累计 SELECT title, category_id, price, SUM(price) OVER (PARTITION BY category_id ORDER BY price) AS 组内累计 FROM books WHERE category_id = 3;
+-----------------------+-------------+----------+--------------+ | title | category_id | price | 组内累计 | +-----------------------+-------------+----------+--------------+ | 操作系统导论 | 3 | 20.00 | 20.00 | | 计算机网络 | 3 | 79.00 | 99.00 | | 算法导论 | 3 | 128.00 | 227.00 | +-----------------------+-------------+----------+--------------+
第一行累计 20,第二行累计 20+79=99,第三行 227——ORDER BY 让窗口从"全窗"变成"窗首到当前行"的滑动范围。同分并列时这个范围会扩到并列的所有行(RANGE 语义),想要严格的"前 N 行"用 ROWS BETWEEN 显式声明,7.3 节展开。此刻先记住判断口诀:与顺序无关的聚合(均值、总量)不用窗内 ORDER BY;与"到此为止"有关的计算(累计、移动)必须用它。
图 7-1 开窗机制:切窗与贴值
执行位置与那条著名的限制
窗口函数算出的值贴在行上,那能不能拿它过滤?经典尝试与经典报错:
-- 反例:WHERE 里用窗口函数 SELECT title, price, RANK() OVER (ORDER BY price DESC) AS price_rank FROM books WHERE price_rank <= 3;
ERROR 1054 (42S22): Unknown column 'price_rank' in 'where clause'
与第 1 章"WHERE 里用 SELECT 别名"的报错同源:逻辑执行顺序里,WHERE 在 SELECT 之前,窗口函数随 SELECT 阶段求值——值还没算出来,WHERE 自然看不见。正确姿势是套一层派生表(或第 8 章的 CTE),让窗口值先物化成普通列,再在外层过滤:
-- 正解:派生表里先算排名 外层再筛 SELECT title, price, price_rank FROM ( SELECT title, price, RANK() OVER (ORDER BY price DESC) AS price_rank FROM books ) ranked WHERE price_rank <= 3;
+-----------------------+----------+------------+ | title | price | price_rank | +-----------------------+----------+------------+ | 算法导论 | 128.00 | 1 | | 数据库系统概念 | 89.00 | 2 | | 计算机网络 | 79.00 | 3 | +-----------------------+----------+------------+
同理可推:窗口函数不能进 GROUP BY、不能套聚合函数(AVG(RANK() OVER ...) 不行)。它站的位置是"明细行俱在、普通聚合之外"——这句定位也解释了它与 GROUP BY 同句时的规则:GROUP BY 先折叠,窗口函数在折叠后的行上开窗。若要"先开窗后聚合",还是套一层。
⚠️ 常见坑:把 PARTITION BY 与 GROUP BY 写进同一条查询,期望两者各自为政——输出行数先被 GROUP BY 折叠成每组一行,窗口函数在折叠后的少量行上开窗,结果与直觉大相径庭。两种"组"思维尽量分层:先在一个查询层级里开窗,聚合放到外层。
💡 关键直觉:窗口函数读作"旁白"。每一行自己的台词(明细列)照念,旁边多一句画外音(窗内汇总)——旁白不删台词,这正是它与 GROUP BY"只留结论"的根本区别。
本节要点回顾
- OVER 让聚合不折叠:输出行数等于原表,汇总值贴回每一行;
- PARTITION BY 切窗:组内窗互不打扰,空 OVER() 是全表窗;
- 窗内 ORDER BY 定义动态边界:窗首到当前行,用于累计类计算;与顺序无关的聚合别乱加;
- 执行位置决定限制:窗口值随 SELECT 阶段产生,进不了 WHERE,筛选用派生表或 CTE 套层;
- 与 GROUP BY 分层共存:先折叠后开窗还是先开窗后聚合,套层说清,别塞进一句;
- 旧解法(查两遍再拼)全部可被开窗替代:第 6 章的相关子查询同类场景同样如此。