2.2 元素:骨架的关节
2.2 元素:骨架的关节
元素是 XML 文档的基本构建单元,由开始标签、内容、结束标签构成,内容可以是文本、子元素、两者的混合,也可以为空。整份文档就是一棵由元素咬合而成的树。上一节看清了出厂标签,本节解剖关节本身:内容有哪几种形态、嵌套怎么设计、深层结构何时是负担。
元素内容的四种形态
<product sku="P-9"> <name>机械键盘</name> <!-- 形态一:纯文本 --> <specs> <layout>87键</layout> <!-- 形态二:纯子元素 --> <switch>红轴</switch> </specs> <desc>支持 <b>宏编程</b> 的入门款</desc> <!-- 形态三:混合内容 --> <reviewed/> <!-- 形态四:空元素,自闭合 --> </product>
四种形态各有用途,但同一层级的语义要稳定:<specs> 里若有时放文本、有时放子元素,下游解析代码就得两头防。混合内容(形态三)主要出现在文档型 XML——正文段落里嵌强调标签;数据型 XML 应尽量用纯子元素或纯文本,机器好处理。所谓"语义稳定",展开说就是同一元素在不同文档实例里的内容形态应当一致——校验器可以在契约里强制这一点(第 3 章的 mixed 标记),但最好的防线还是设计时就别给同一元素安排双重人格。
空元素不是"忘了写内容"。<reviewed/> 表达的是布尔语义"已复核",类似数据库里的标志位。它和缺失是两回事:<reviewed/> 是显式的"是",没有这个元素则状态未知——设计接口时这个差别会被放大。
嵌套深度:一次订单结构的设计复盘
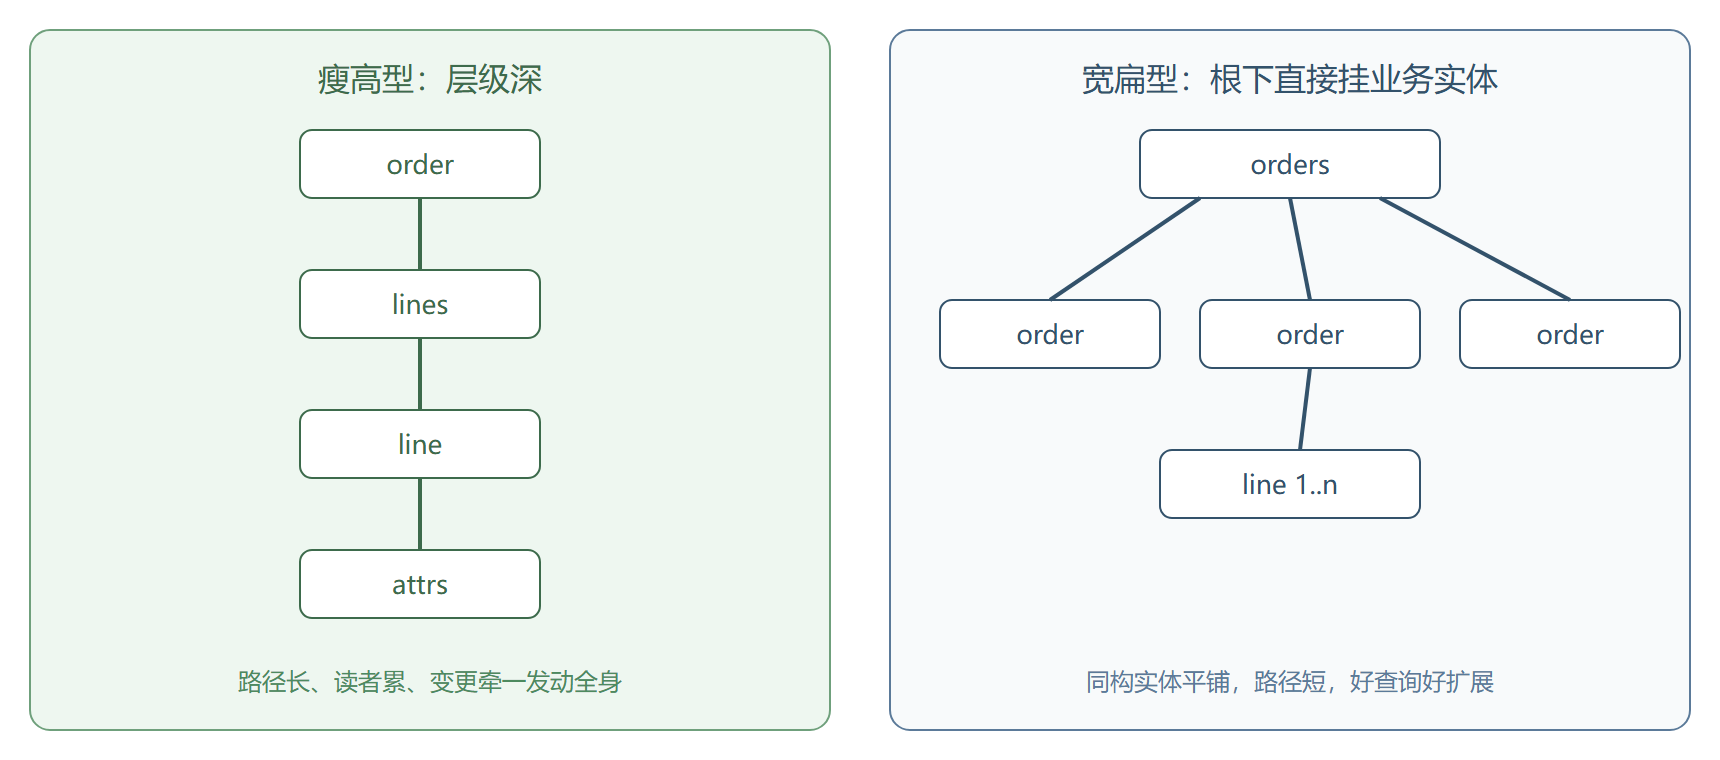
背景:电商中台要设计订单下发的 XML 结构,初版照抄了关系型数据库的表结构,订单挂在第 6 层。操作:初版长这样——
<platform> <tenant t="T01"> <channel c="APP"> <orderGroup g="G7"> <order id="O1001"> <lines> <line sku="A">2</line> </lines> </order> </orderGroup> </channel> </tenant> </platform>
结果:下游写 XPath 要数六层斜杠,人工核对报文时滚动条拉不满。解读:中间的 tenant、channel、orderGroup 是组织维度,不是订单数据的组成部分,混进结构里让"树"替"组织架构图"背了锅。重构版:
<order id="O1001" tenant="T01" channel="APP" group="G7"> <line sku="A" qty="2"/> </order> <!-- 组织维度降级为根元素属性;查询路径缩短到两层 -->
变式讨论:如果 group 本身有复杂属性(分组有效期、负责人),降级成属性就不够用,可保留 <group> 一层——判断标准是"它有没有自己的数据",而不是"它在公司架构里的级别"。
经验值:数据交换用 XML 深度控制在 4 到 6 层为宜;更深通常说明某些层级该降级为属性,或文档该拆分。
"该拆分"再展开一句。深层嵌套的另一种成因是一份文档装了太多互不相干的事:订单、物流、发票、审批流全塞一棵树。拆分的判断标准是生命周期——这些数据是不是同时产生、同时消费、同时变更?物流轨迹每天追加而订单头一周不变,硬绑在一起就让每次追加都背着整棵树传输。按生命周期拆成"订单主档 + 各阶段增补文档",每份各自浅层、用订单号关联,是比无限嵌套更健康的组织方式。这种"文档边界即变更边界"的思路,在后续章节的转换与查询里还会反复用到:拆得好的文档,XSLT 模板更简单、XPath 更短、校验契约也更窄。
元素树的两种典型形状
命名习惯与工程约定
元素名是给十年后的维护者看的。三条约定值得写进团队规范:全小写加连字符(ship-to)或全小写驼峰(shipTo)二选一并全库统一;单数复数表语义——<order> 是单个实体、<orders> 是集合容器;杜绝缩写暗语,<cust> 这种名字三个月后连作者自己都要猜。
💡 判断嵌套是否合理的土办法:把 XPath 说给同事听。要念到喘气的路径,就该降层了。
混合内容的取舍
数据型与文档型的分野值得单独强调,因为它是"元素怎么组织"背后的总纲。数据型文档(订单、配置、报文)里每个元素的角色要可预期:程序读到 price 时知道是数字、读到 lines 时知道里面是一组 line。一旦混入混合内容,程序就必须处理"文本与子元素交错"的任意排列,复杂度陡增。
文档型文档则相反:一段正文里哪里出现强调、哪里出现脚注引用,事先不可预期,混合内容正是为这种自由而生。判断自己该用哪种,问一个问题和 2.3 节一样朴素:我的读者主要是程序还是人。程序读,数据型、结构严整;人读,文档型、正文为主结构为辅。多数工程场景是前者,这也是为什么本书案例几乎都长成"纯子元素"的样子——不是混合内容不重要,而是它的主场在出版业,6.3 节会看到它成规模的样子。
另外提一个团队协作的经验:结构设计定稿前,先写三五份真实规模的样例文档再定稿,别拿两三条假数据的设计稿直接发布。假数据撑不起的层级(重复字段、多包装箱、多地址)只有真实样例会逼出来,而结构发布后再改,成本要乘以所有接入方的数量。这个"先喂饱样例再冻结结构"的习惯,是从无数接口返工里换来的便宜教训。
本节要点回顾
- 四种内容形态:文本、子元素、混合、空;数据型 XML 慎用混合内容;
- 空元素是显式语义,与"元素缺失"含义不同;
- 深度 4 到 6 层为宜,更深时考虑降级为属性或拆分文档;
- 组织维度别混进数据结构,该做属性别做层级;
- 命名三约定:风格统一、单复数表语义、不缩写。
最后排错一条。解析器报"mismatched tag"时,报错行号常指向结束标签而非真正出错处:<lines> 被误写成自闭合 <lines/> 时,错误要到几行之后的 </lines> 才暴露。排查方法是沿报错行向上找最近一个"开始标签名字与报错标签相同"的位置,八成就是案发点。另一个高频坑是大小写:XML 元素名区分大小写,<Order> 与 <order> 是两个元素,校验器会报"元素未声明",初学者却常以为是数据问题。
关节能承重,关节上还能挂铭牌——属性怎么用、什么时候不该用,下一节给出决策表。