5.1 解析:DOM、SAX与StAX三条路线
5.1 解析:DOM、SAX 与 StAX 三条路线
解析是 XML 加工的第一道工序:把文本变成程序可操作的结构。三条主流路线——DOM 全量建树、SAX 事件推送、StAX 游标拉取——在内存、访问模式、代码量上各有取舍。本节用同一个任务(抽取所有库存低于阈值的书)把三条路线各写一遍,选型标准在对照中自然浮现。
DOM:把树搬进内存
DOM(Document Object Model)解析器读完整份文档,在内存里建出一棵节点树,程序可随机访问任意节点、也能修改后写回。
// 任务:抽取库存低于 10 的书名(DOM 写法) DocumentBuilderFactory f = DocumentBuilderFactory.newInstance(); Document doc = f.newDocumentBuilder().parse(orderFile); // parse 返回后整棵树已在内存,可反复遍历 NodeList books = doc.getElementsByTagName("book"); for (int i = 0; i < books.getLength(); i++) { Element book = (Element) books.item(i); int stock = Integer.parseInt( book.getElementsByTagName("stock").item(0).getTextContent()); if (stock < 10) { System.out.println(book.getAttribute("sku") + " " + book.getElementsByTagName("title").item(0).getTextContent()); } } // 输出: // 9787115428028 JavaScript DOM编程艺术
DOM 的优点在这段代码里可见:按名取节点、随时回头、还能改树(增删节点后写回)。代价是内存——树状结构的膨胀系数通常是原文的数倍,百兆级文档可能吃掉数 GB 内存。
SAX:解析器推事件,程序只管接
SAX(Simple API for XML)不建树。解析器顺序扫过文档,每到一处就回调程序注册的事件处理器。程序像站在传送带旁,货一件件经过,看不过来就丢。
// 同一任务的 SAX 写法(骨架) boolean inStock = false; int stockVal = 0; public void startElement(String uri, String local, String qName, Attributes a) { if (qName.equals("stock")) inStock = true; // 进入 stock 元素 } public void characters(char[] ch, int start, int length) { if (inStock) stockVal = Integer.parseInt(new String(ch, start, length).trim()); } public void endElement(String uri, String local, String qName) { if (qName.equals("stock")) inStock = false; // 离开 stock if (qName.equals("book") && stockVal < 10) { System.out.println("低库存书已记录"); } } // 同样输出:9787115428028 JavaScript DOM编程艺术(实现细节略)
事件回调把状态管理责任压给程序员(inStock 这类标志位就是代价),换来的是常数级内存——文件多大都能扫,扫完即弃。SAX 天生只读;要回头取另一个字段,只能再扫一遍。
StAX:程序拉游标
StAX(Streaming API for XML)综合两者:程序主动拉动游标,要一段读一段,想停就停。
// 同一任务的 StAX 写法(骨架) XMLInputFactory inf = XMLInputFactory.newInstance(); XMLStreamReader r = inf.createXMLStreamReader(new FileReader(orderFile)); while (r.hasNext()) { int ev = r.next(); if (ev == XMLStreamConstants.START_ELEMENT && r.getLocalName().equals("book")) { // 逐事件推进:读到 stock 记下数值,读到 title 记下文本 } } // 逻辑与 SAX 相近,但推进节奏由本方 while 循环控制
拉取模型(pull)对推送模型(push)的优势:程序控制流程,可以在任意事件处停止、跳过、或交给别的组件——过滤型任务("找到第一条就收工")用 StAX 最顺手,且不用维护一堆回调。
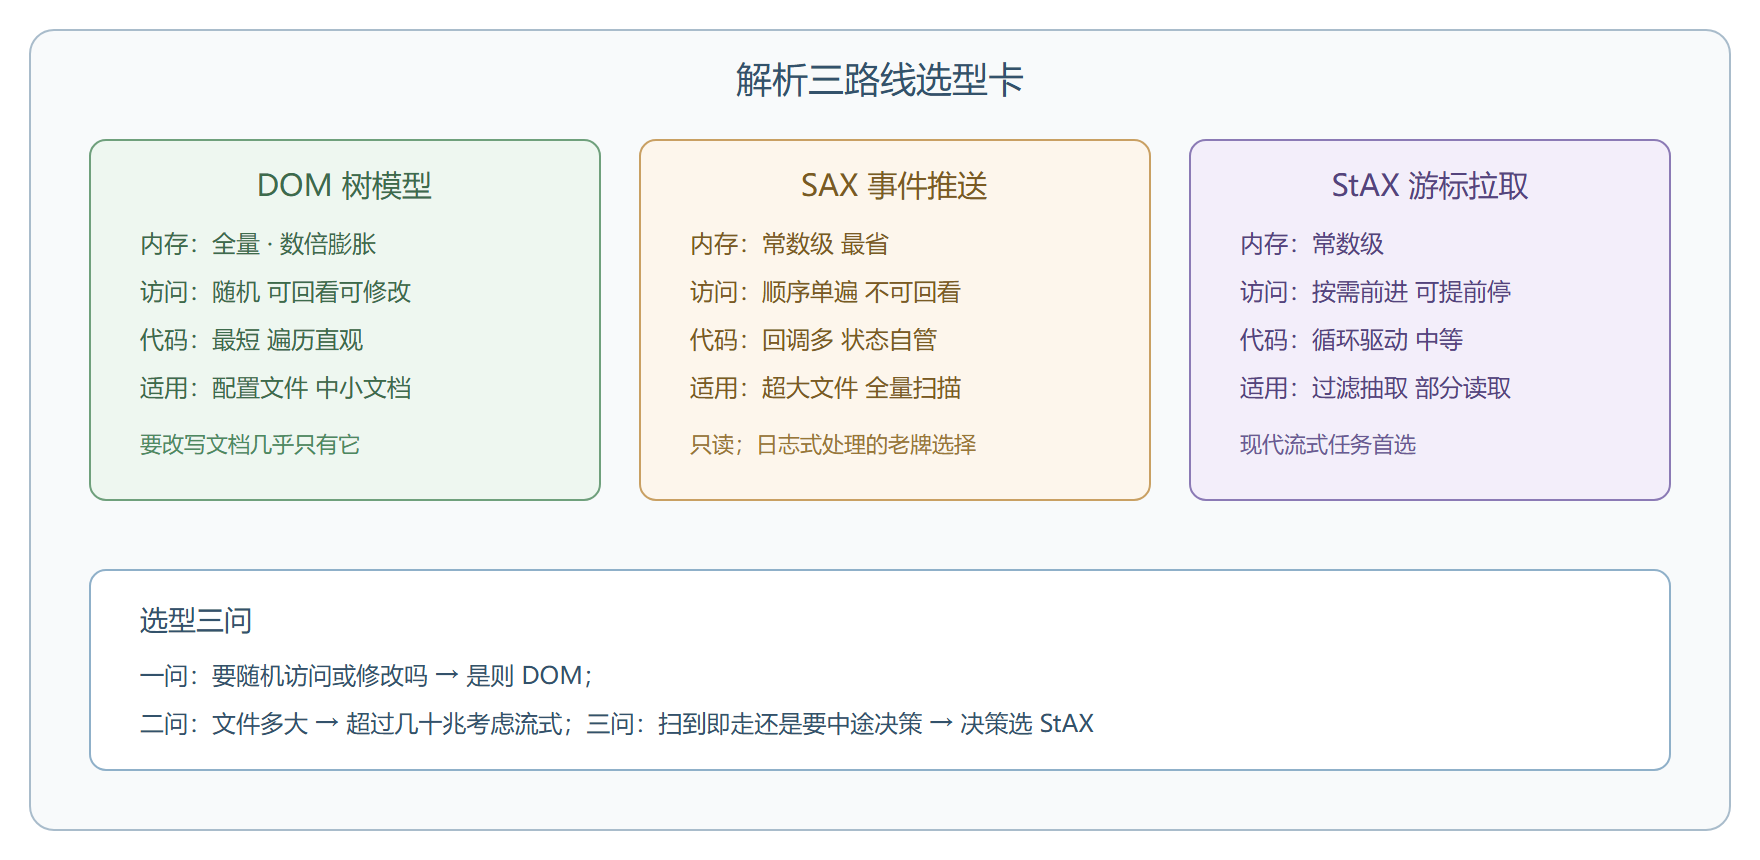
三路线选型对照
复盘:一次内存事故的换轨
背景:报表系统用 DOM 解析每日全量订单(约 400MB),凌晨任务频繁 OOM。操作:分析访问模式——只顺序抽取三个字段、不回看不改写,属典型过滤型任务;将 DOM 换成 StAX 流式读取。结果:内存占用从数 GB 降到几十 MB,耗时也降(省去建树)。解读:事故根源不是"DOM 不好",是访问模式与路线错配——要随机访问的任务换流式同样会痛(自己模拟树结构,代码翻倍)。变式:若抽取逻辑后来要求"取每本书时回看订单头",纯 StAX 会别扭,可引入"头部 DOM + 明细流式"的两段式混合方案。
⚠️ 流式解析别忘了安全配置:外部实体默认开启的话,6.1 节讲的 XXE 注入在解析这一步就进门了。建树之前先拧阀门。
本节要点回顾
- DOM 全量建树:随机访问、可修改、内存代价高;
- SAX 事件推送:常数内存、只读单遍、回调状态自管;
- StAX 游标拉取:程序控节奏、可提前停、过滤任务首选;
- 选型三问:访问模式、文件规模、是否中途决策;
- 混合方案常见于"头部需随机、明细可流式"的真实报文。
文本进了内存、成了树,下一道工序是变形——XSLT 用一份声明式的样式表整树转换。