6.2 XML数据库:海量文档的归档
6.2 XML 数据库:海量文档的归档
存储 XML 有两条主路:关系库拆表( shredded )——把元素拆进行列,或整段存进 XML 类型列;原生 XML 数据库——文档整存整取,用 XQuery 检索。承 5.3 的 XQuery,本节给出选型决策框架,并复盘一次书目库的两种存法对比。
关系库的两副面孔
第一副:拆表。固定结构、字段要参与 SQL 关联统计时,把 book 拆成书目表的行。拆表还有一个不显眼的前提值得点破:字段语义必须全局唯一且稳定——同一字段在所有文档里都叫同一个名字、同一个含义。行业报文(6.3 节)恰好满足这条,所以早期 EDI 类系统大量拆表;而互联网公司自家接口字段名随产品经理心情漂移,拆表就天天迁移。判断自己站在哪一边,看看过去一年字段改名的次数就有答案。拆表的形状如下:
create table book ( sku char(13) primary key, title varchar(200), stock integer, price decimal(10,2) ); -- 元素变列、每本书一行,XPath 的谓词翻译成 where 子句
代价在"结构漂移":上游新增一个嵌套的 price 子结构(2.3 节的旧案),表结构就要迁移;XML 的层级信息在拆表时丢失,想还原原文档得再拼装。
第二副:XML 类型列。主流关系库都有原生 XML 类型(带 XQuery 支持),文档整段入库、仍可按路径查:
create table doc_store ( id bigint primary key, body xml not null -- 文档整体入库 ); -- SQL 与 XQuery 混合查询: select id from doc_store where xmlexists('$d/inventory/book[stock < 10]' passing body as "d"); -- xmlexists:关系库里调用 XQuery 判断是否存在命中节点
这条路保留了文档完整性,还能建 XML 索引;代价是查询写法复杂、跨文档统计仍要 SQL 配合。
原生 XML 数据库
原生库(如开源的 BaseX、eXist-db)把"文档"当一等公民:整存整取、自动索引、查询语言就是 5.3 节的 XQuery:
for $b in collection("inventory")//book where $b/stock < 10 order by $b/stock return $b/title (: collection 跨所有入库文档检索,与单文档查询语法一致 :)
它换来的一致体验是:存储形状=查询形状=交换形状,没有拆装损耗。适合结构多变、以文档为单位的集合:法规全文、病历、出版档案、检修记录。
复盘:书目库的两代存法
背景:图书中台管理千万级书目,第一代用拆表存储。操作与结果:头两年平稳——书目结构稳定,SQL 统计飞快。第三年引入多形态商品(电子书带版权信息、套装带子书目),表结构三个月一迁移,每迁移一次下游 ETL 跟着重跑。第二代改造:核心可统计字段(sku、title、stock)仍拆表保 SQL 性能,完整原文档另存 XML 列、异构扩展字段全部留在文档里。结果:结构漂移不再触发表迁移,统计走表、明细走 XQuery,两全。解读:选型不是二选一的站队,而是按访问模式分层——统计密集的字段下沉到表,文档形态的留档在 XML。变式:若业务以全文检索为主(法规、病历),直接上原生库加全文索引,比关系库混合方案省一半复杂度。
| 决策维度 | 拆表 | XML 列 | 原生库 |
|---|---|---|---|
| 结构稳定性 | 高(不迁移才划算) | 中高 | 任意 |
| 查询主角 | SQL 统计 | SQL + XQuery 混合 | XQuery/全文 |
| 文档还原 | 需拼装 | 原样 | 原样 |
| 运维生态 | 最成熟 | 随关系库 | 独立运维 |
💡 选型一句话:字段要进报表,进表;文档是资产,进档;两者都要,分层放。
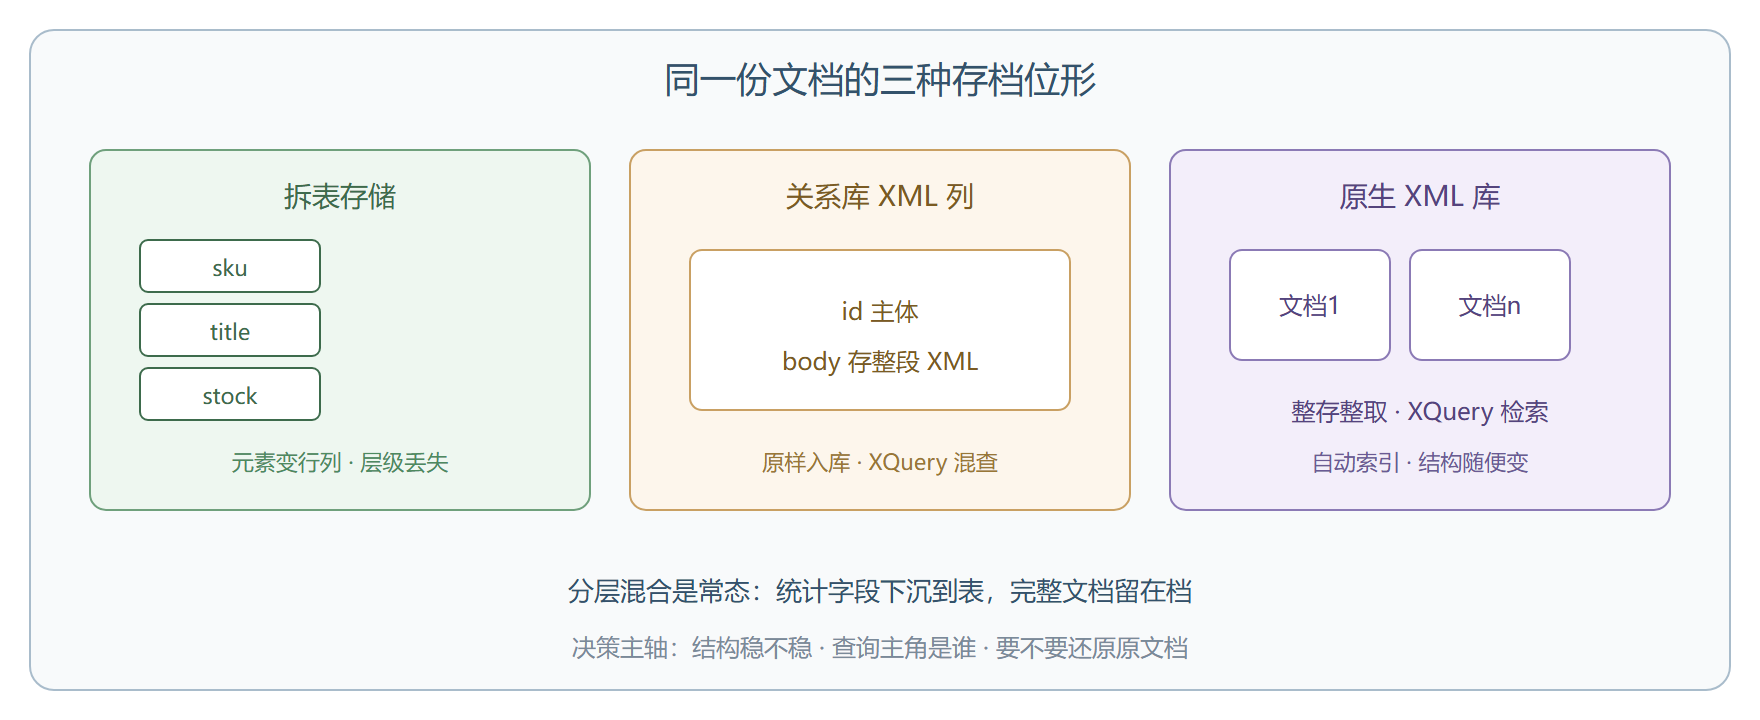
三种存档位形对照
迁移路线:从错误存法换轨
存量系统发现存法错了怎么换?直接给一条低风险路线。第一步,先加不先拆:在现有表结构旁新增 XML 列或文档表,双写一个周期——新数据两边都有,老数据不动。第二步,按需回填:只对真正用到新查询能力的存量数据回填完整文档,其余保持旧结构,避免一次全量迁移的长停机。第三步,统计验证后切读:新旧两条查询路径各跑一段时间对账,数字一致再把读流量切到新路径,旧结构留作回滚兜底。三步走完,迁移的风险被摊薄成三次可回退的小变更。
这条路线的要点不在步骤本身,而在心态:存储选型错误是慢刀子,它不像宕机那样逼你立刻处理,而是以"每次加字段都要迁移表"的方式持续放血。识别信号有两条——表结构迁移频率升到季度级、下游为拼回原文档写了越来越多的胶水代码——命中其一就该重新过一遍本节的决策表。趁早换轨的代价,永远小于忍到数据量再翻两倍。
最后补一个容量与性能的量级感,帮助建立判断底气。主流关系库的 XML 列在配好索引后,单表千万级文档、按路径过滤的查询通常在百毫秒量级返回;原生库面向千万级文档集合做 XQuery 全量检索同样从容,还自带全文索引。也就是说,"XML 查询慢"多数时候不是格式的问题,而是索引缺失或存储位形错配的问题。先修索引、再修位形、最后才考虑换引擎——这个顺序能挡掉八成 premature 的架构折腾,也给真正需要换轨的场景攒下干净的判断依据。
- 关系库两副面孔:拆表丢结构、换统计速度;XML 列保完整、查询混合;
- 原生库以文档为一等公民,XQuery 整存整取,适合结构多变集合;
- 分层混合是常态:统计字段下沉、完整文档留档;
- 决策主轴:结构是否稳定、查询主角是谁、要不要还原原文档。
还有一个常被问到的问题:XML 列里的文档更新代价如何?与直觉相反,多数引擎对 XML 列的更新是整段重写——哪怕只改一个元素,存储层面也是替换整个文档值。这决定了两种用法的天壤之别:读多写少的档案场景(合同、病历、法规快照)几乎无感;高频局部更新的场景(秒级变更的库存、状态机)会把重写成本放大成性能瓶颈。判据一句话:更新粒度若是"字段级高频",下沉到表;若是"文档级偶发",整存无妨。把这个维度并进决策表,选型就闭合了。
特种车间的最后一站走出机房——看看 XML 在各行业现场的生存形态。