1.4 数组与字符串的连续内存
1.4 数组与字符串的连续内存
本节摘要:数组是同类型元素在内存里的紧密排列,"连续"二字给它带来缓存友好的速度,也带来越界即未定义行为的危险。本节讲透数组名退化、C 风格字符串的结尾符约定、
std::string的短字符串优化,以及为什么现代 C++ 用std::vector和std::string取代裸数组——不是因为裸数组慢,而是因为裸数组的生命周期太容易管错。
你将学会
阅读完本节,你应当能够:
- 解释数组名在大多数表达式中退化为首元素指针的现象;
- 手工推算二维数组与字符缓冲区的大小;
- 说出 C 字符串与
std::string在内存组织上的本质区别; - 描述短字符串优化如何让短字符串完全避开堆分配。
一、连续排列的红利与代价
int scores[4] = {90, 85, 77, 96};
这一行在栈帧里划出 16 字节,四个 int 首尾相接。连续排列的红利是访问速度:第 i 个元素的地址就是"首地址 + i × 4",一次乘法加法就能定位;更重要的是缓存——CPU 按缓存行(常为 64 字节)成块搬运内存,遍历连续数组时一次装载服务多个元素,而链表那种"节点散落堆中"的结构每跳一步都可能是一次内存访问。这也是第 4 章 STL 容器选型的核心依据之一。
代价同样来自连续:没有任何边界护栏。scores[4] 编译器不拦、运行时不查(operator[] 不做边界检查),你读到了邻居变量的内存——未定义行为。想要检查时用 at()(越界抛 std::out_of_range)或直接用带边界意识的容器:
std::array<int, 4> safe{90, 85, 77, 96}; safe.at(4); // 抛异常 立刻暴露问题 safe[4]; // 仍未定义行为 性能换安全的取舍点
二、数组名退化:C 时代最著名的"变形"
数组名不是指针,但几乎在任何表达式中都会退化为首元素指针:
int a[4] = {1, 2, 3, 4}; sizeof(a); // 16:不退化的三种场合之一 求整组大小 sizeof(a) / sizeof(a[0]); // 4 经典的元素个数算法 int* p = a; // 退化为 &a[0] *p; // 1
退化只发生在数组名作为表达式值使用时;sizeof、取地址 &a(得到的是"指向整组的指针")和绑定到数组的引用不退化。退化后指针丢失了长度信息——这正是"数组传参即变指针"的根源:
void process(int arr[4]); // 形参里的 4 被编译器无视! // 完全等价于 void process(int* arr);
所以 C 风格接口只能靠额外参数传长度。C++17 起有了更体面的替代——std::span,一个"指针 + 长度"的视图,数组与 vector 都能无拷贝地传给它:
#include <span> void process(std::span<int> arr) { for (int& x : arr) x *= 2; // 长度信息完整保留 } int main() { int a[4] = {1, 2, 3, 4}; process(a); // 自动退化成带长度的视图 }
二维数组是"数组的数组":int m[2][3] 在内存里仍是 6 个连续的 int,按行存放。m[1][2] 的地址是首地址加 (1×3 + 2)×4——行主序的地址算术,与 CPU、缓存预取配合出奇地好,也是图像处理、矩阵运算偏爱行主序遍历的原因(外层循环走行,内层走列,顺着缓存走)。
三、C 字符串:一个约定撑起半个世界
C 风格字符串没有元数据,只有一条约定:以字节 0('\0')结尾。"hello" 在内存里是 6 个字节:h、e、l、l、o、0。这条约定决定了 C 字符串函数的全部行为——strlen 要从头数到 0 才知道长度(O(n)),忘记写 0 程序就读过界:
char buf[5]; // strcpy(buf, "hello"); // 6字节塞进5字节 缓冲区溢出 经典安全漏洞 snprintf(buf, sizeof(buf), "hello"); // 截断到 hell\0 安全
字符串字面量存放在只读存储区,通过指针改它是段错误:
char* s = "hello"; // 危险写法 现代编译器警告 s[0] = 'H'; // 未定义行为 常见崩溃 const char* t = "hello"; // 正确姿态:承认其只读身份
C++ 里还有一个小而常考的区别:'a' 是 char,本质是整数 97;"a" 是数组,含 'a' 与 '\0' 两个字节。两者在内存里的形态完全不同。
四、std::string:对象头加堆缓冲
std::string 的内存组织是"句柄 + 缓冲"模式的第一课:
图:std::string 的短字符串优化两种形态
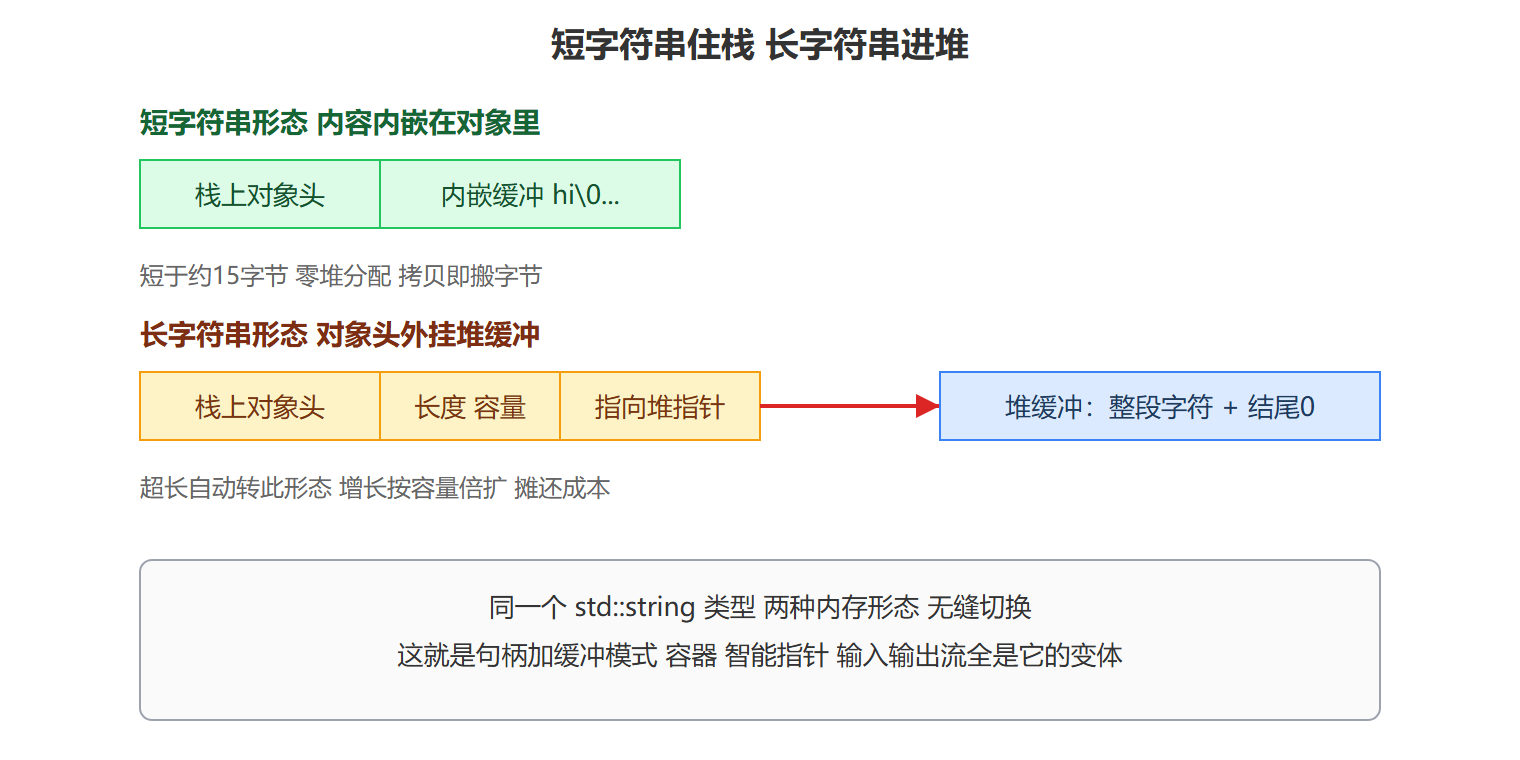
短字符串优化(SSO)解释了一个反直觉现象:构造短字符串比构造长字符串便宜一个数量级,因为前者根本不碰堆。也解释了为什么移动一个长 std::string 极快(只交接堆指针)、移动短字符串反而要搬十几个字节——第 3 章移动语义会回到这一点。
日常操作中还有几个值得记账的行为:
std::string s = "hello"; s + " world"; // 产生新串 可能堆分配 s += "!"; // 容量够则原地 不再分配 s.reserve(1000); // 预留 一次到位 避免反复扩容
拼接、追加、扩容都涉及"容量倍增摊还"策略,与 std::vector 完全一致,第 4 章统一展开。原始字符串与转义在这里补一句:路径写法 R"(C:\Users\dev)" 免去双反斜杠,在 Windows 环境尤其省心。
⚠️ 常见坑:
std::string返回c_str()得到的指针有效期只到下一次修改该字符串;拿它长期保存等于埋雷。另外循环内s = s + x每轮构造临时串,改s += x是零成本优化。
本节要点回顾
- 连续即速度也即风险:边界从不自动检查,
at()换安全,span保长度。 - 数组名退化:传参丢长度是 C 接口的历史包袱,C++ 用
std::span修复。 - C 字符串三宗罪:结尾符约定脆弱、字面量只读、长度要现场数——新代码一律
std::string或string_view。 - SSO 双形态:短串全住栈、长串才上堆;同一个类型两种内存形态自由切换。
- 句柄加缓冲:
std::string是这一模式的启蒙样板,第 3、4 章反复重逢。
下一节把"地址"本身变成可操作的值:指针,C++ 力量与危险的双重源头。