4.1 STL容器的内存全景
4.1 STL 容器的内存全景
本节摘要:vector 对象本体只有三个指针——起点、终点、容量边界,元素成片住在堆上;扩容按倍数增长摊还成本,代价是迭代器全体失效。本节画出各容器的内存形态,给出选型决策依据与迭代器失效红黑榜,把第 1、3 章的连续内存与移动语义知识收进实战。
学习目标
阅读完本节,你应当能够:
- 画出 vector 的三指针结构并解释 size 与 capacity 之别;
- 手算 reserve 策略下的扩容次数;
- 按访问模式完成容器选型;
- 背出常用操作的迭代器失效规则。
一、vector:三个指针管一片农场
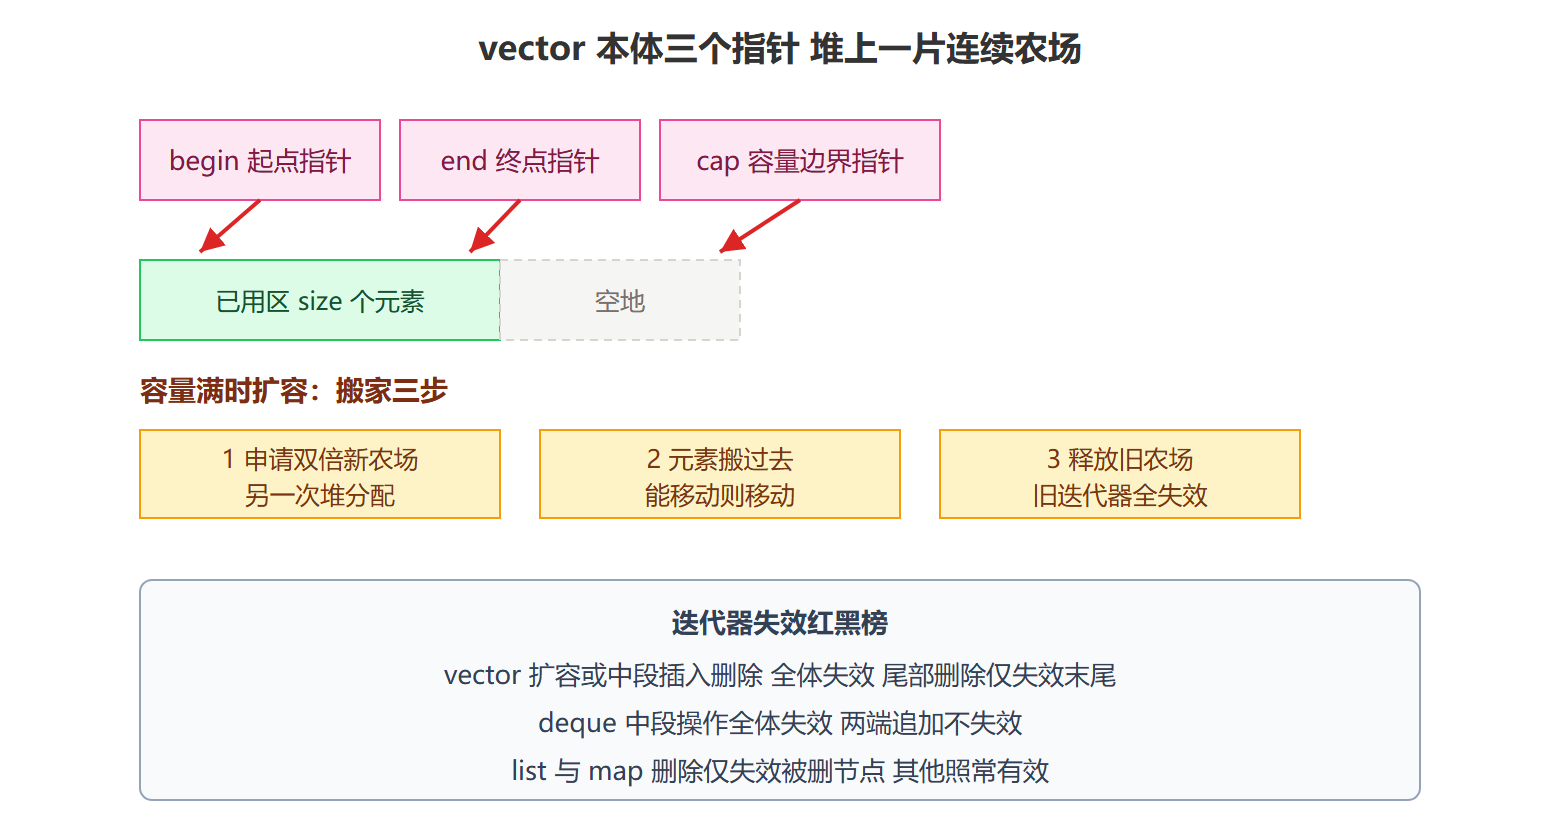
std::vector<int> 的对象本体(栈上或作为成员)只有三个指针,约 24 字节;真正的元素住在堆上一块连续农场里:
#include <vector> #include <iostream> int main() { std::vector<int> v; for (int i = 0; i < 10; ++i) { v.push_back(i); std::cout << v.size() << '/' << v.capacity() << '\n'; } } // 典型输出:size 逐个增长 capacity 按 1 2 4 8 16 台阶跳
size 是已种下的株数,capacity 是栅栏内的地。push_back 还有空地时 O(1);地满则触发扩容:申请一块翻倍的新地、把旧元素全部搬过去(有 noexcept 移动构造就走移动,3.4 节的伏笔在此兑现)、释放旧地。倍增策略的精妙在摊还分析:n 次 push_back 总搬运量不超过 2n,单次摊还 O(1)。
图:vector 的三指针结构与一次扩容
reserve 是最便宜的优化:已知要装 n 个元素就 v.reserve(n),一步到位免去 log 次搬家与 realloc。反过来,shrink_to_fit 或拷贝构造可以归还多余空地(拷贝构造的新 vector 容量恰好等于 size)。
二、容器选型:内存形态决定性能
各容器的内存形态差异极大,选型本质是"访问模式与内存形态的匹配":
| 容器 | 内存形态 | 随机访问 | 中段插入 | 迭代器稳定性 |
|---|---|---|---|---|
| vector | 连续一块 | O(1) 极快 | O(n) 搬移 | 扩容即全灭 |
| deque | 分段连续 | O(1) | 两端 O(1) | 中段操作失效 |
| list | 节点散布堆中 | 无 | 已知位置 O(1) | 稳定 |
| map | 红黑树节点 | 对数 | 对数 加节点分配 | 稳定 |
| unordered_map | 桶加链表 | 均摊 O(1) | 均摊 O(1) | rehash 时失效 |
经验法则:默认 vector。它的连续内存对缓存极度友好,实测中"vector 的 O(n) 搬移"常常跑赢"list 的 O(1) 链接",数据量在十万级以内几乎不必犹豫。list 只在"频繁在已持有迭代器处增删且不可搬移"时才值得;map 需要有序遍历或范围查询时用,纯查表用 unordered_map。另一个组合技巧:vector<pair> 手工维护有序性,常比 map 又快又省——节点容器每个元素一次堆分配的税,量大了很可观。
string 也是容器(1.4 节已看它的 SSO 双形态),vector 的三指针、扩容、reserve 结论全部适用。
三、算法与迭代器:容器的一万种用法
容器本体的接口很薄,真正的生产力在 <algorithm> 与迭代器。迭代器是"泛化指针"——指针的全部操作(解引用、递增、比较)抽象成类型要求,于是算法写一遍就能服务所有容器:
#include <algorithm> #include <numeric> #include <vector> std::vector<int> v{3, 1, 4, 1, 5, 9}; std::sort(v.begin(), v.end()); // 排序 auto it = std::find(v.begin(), v.end(), 4); // 查找 int total = std::accumulate(v.begin(), v.end(), 0); // 求和 int evens = std::count_if(v.begin(), v.end(), [](int x) { return x % 2 == 0; }); // 3.7 节的Lambda
remove 是最反直觉的入门题:它不删除元素(容器大小不变),只是把保留值前移,返回新逻辑终点;真删除要配合 erase:
v.erase(std::remove(v.begin(), v.end(), 1), v.end()); // erase-remove 惯用法 // C++20 起有 std::erase_if(v, pred) 一步到位
为什么这么设计?因为算法拿到的只有迭代器,动不了容器本体——容器大小是容器自己的事。这个"算法只操作区间"的边界,正是标准库几十年稳定的秘诀。
emplace_back 对 push_back 是又一次移动语义的兑现:v.emplace_back(args...) 在容器内存里原地构造,连临时对象都省了:
std::vector<std::string> names; names.push_back(std::string(100, 'x')); // 构造临时串 移动进容器 names.emplace_back(100, 'x'); // 直接在容器里构造 前一步免了
选型之外:把内存账算细
真正做性能敏感的系统时,光背选型表不够,要把每个容器的内存账摊开算。以一个装着十万元素的场景做对比:vector 的开销是四字节乘十万,一整块连续堆内存,外加本体二十来个字节;list 则是每个节点一次堆分配,节点除数据外还要带前后两个指针,同样的十万元素要吃下三倍内存,而且散布在堆的四面八方,遍历时缓存命中惨不忍睹。unordered_map 的账更复杂:每个元素住在独立节点里,桶数组本身又是一块按负载因子预留的堆内存,扩容时全体节点重新挂桶。这些账目在压测报告里就变成明显的时间差——同一段遍历逻辑,vector 与 list 在百万级数据上拉开十倍差距并不稀奇。
另一个常被忽视的维度是元素大小与搬移成本。vector 扩容要搬动全部元素:元素是平凡类型(int、double)时就是一次内存搬运,极快;元素是含堆资源的类型(string、嵌套 vector)时就要靠移动构造逐个过户——3.4 节强调 noexcept 移动构造的伏笔在此兑现,不标 noexcept 的移动构造会让 vector 在扩容时退回逐个深拷贝,性能悄悄掉一个量级且很难从外部察觉。所以给资源类补移动构造时,noexcept 不是可选项而是性能开关。
💡 关键直觉:容器选型的底层是三问——数据怎么被访问(随机还是顺序)、怎么被增删(两端还是中段)、元素搬移贵不贵(平凡还是资源型)。三问答完,表格不必背,答案自然浮出。
⚠️ 常见坑:循环里边遍历边 erase(it 失效后继续用);对 vector 做逐个 push_back 却忘了 reserve 的高频路径;拿 operator[] 当 find 用(unordered_map 的 [] 会插入默认值!查存在性用 count 或 find)。
本节要点回顾
- vector 三指针:本体 24 字节,元素连续住堆;size 与 capacity 分离,reserve 免搬家。
- 扩容即全体失效:迭代器、指针、引用统统作废;list/map 只作废被删节点。
- 默认 vector:缓存友好常常打赢理论复杂度;节点容器按真需求升级。
- 算法配迭代器:erase-remove 惯用法解释了"算法动不了容器"的边界设计。
- emplace 系列原地构造:与移动语义配合把中间损耗压到零。
下一节看数据的进出通道:IO 流的缓冲链条。