4.3 并发与数据竞争
4.3 并发与数据竞争
本节摘要:多线程共享内存是 C++ 内存模型最惊险的考场——两个线程同时读写同一对象且无同步,不是"偶尔算错"而是未定义行为。本节从数据竞争的现场讲起,过一遍线程的启动与汇合、互斥与锁守卫、原子操作,最后给出把"共享什么、怎么护"写进设计的工作清单。
学习目标
阅读完本节,你应当能够:
- 识别代码中的数据竞争并说明为何它是未定义行为;
- 用 std::thread、join、锁守卫写出正确的基本并发程序;
- 解释原子变量为何既轻量又足够;
- 说出虚假唤醒与条件变量的配合关系。
一、先看一场安静的崩坏
#include <thread> #include <vector> #include <iostream> int counter = 0; // 全局共享 void bump() { for (int i = 0; i < 100000; ++i) ++counter; // 读 改 写 三步不是原子的 } int main() { std::thread t1(bump), t2(bump); t1.join(); t2.join(); std::cout << counter << '\n'; // 期望 200000 实际常小于它 每次都不同 }
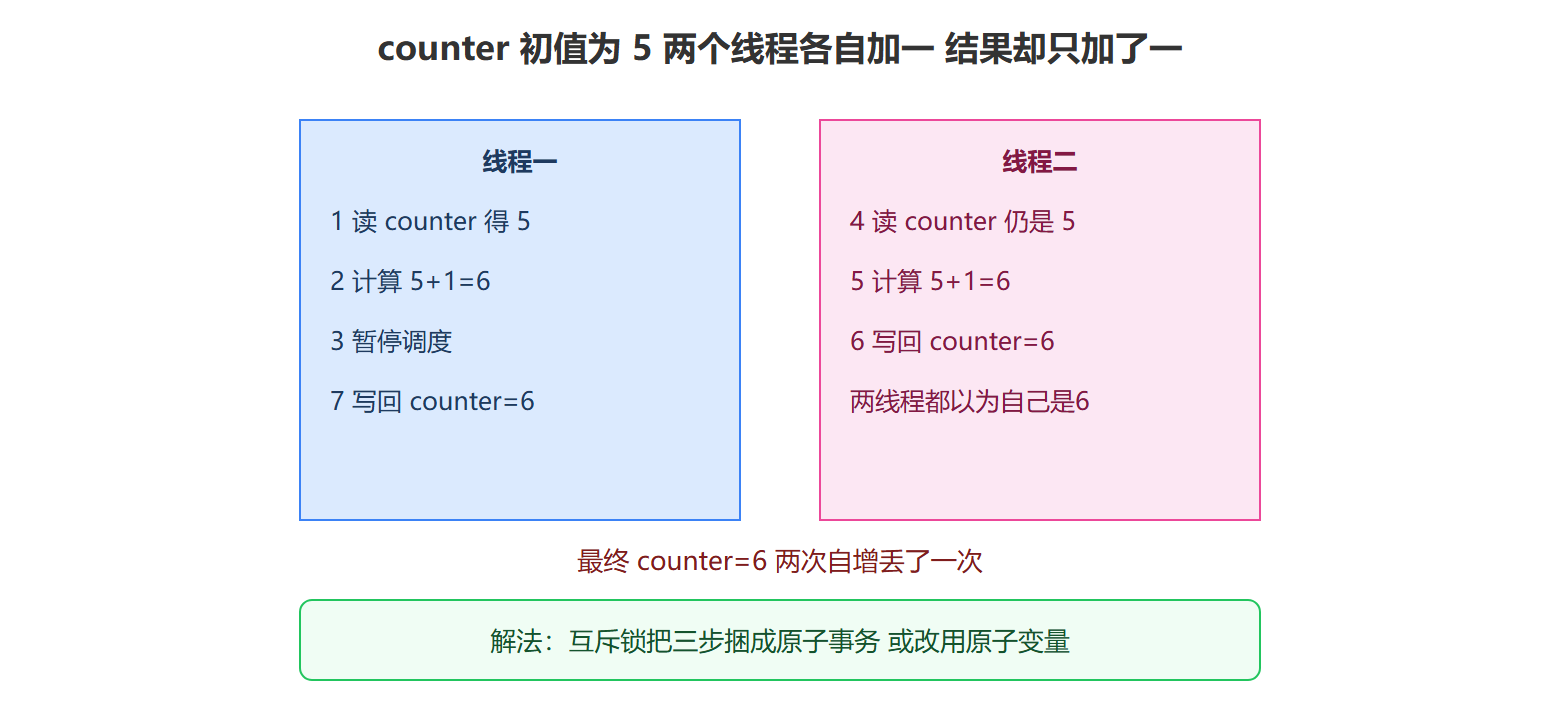
++counter 是三步:读旧值、加一、写回。两线程交错执行时,同读旧值、各自加一、先后写回——两次自增只涨了一。输出每次不同、偶尔还"看起来正确",这正是数据竞争的可怕之处:标准明确规定,无同步的并发读写同一对象是未定义行为,编译器有权假设它不发生并做出颠覆直觉的优化(比如把变量缓存在寄存器里永不重读)。
图:两线程竞争一个计数器的一次交错
二、线程的生命周期与两条铁律
#include <thread> #include <mutex> #include <iostream> std::mutex g_mtx; void safe_work(int id) { std::lock_guard<std::mutex> lock(g_mtx); // RAII:构造加锁 析构解锁 std::cout << "线程 " << id << " 工作中\n"; } // 作用域结束自动解锁 int main() { std::thread t1(safe_work, 1); // 构造即启动 参数按值拷贝进线程 std::thread t2(safe_work, 2); t1.join(); // 等它结束 t2.join(); // 铁律:join 或 detach 必居其一 }
两条铁律:构造的线程对象必须 join(等它收工)或 detach(放养),析构前二选一,否则 terminate;detach 之前确保线程访问的数据活得比线程久——detach 出的线程在 main 结束后还在跑,引用了栈上局部变量就是悬垂(1.3 与 3.7 节的规则跨线程重演)。
lock_guard 是锁守卫的标准形态(3.2 节 RAII 的并发版):任意出口自动解锁,异常也能放行。多把锁按固定顺序获取防死锁,或直接用 std::scoped_lock(mtx1, mtx2) 一次锁多把(内部用死锁避免算法)。传参时注意:std::thread 构造按值拷贝参数,要传引用得显式 std::ref(x),要转移所有权用 std::move——所有权规则在并发接口上一字不改地适用。
三、原子变量:轻量级的正解
计数器这类"单变量的读改写",用互斥锁是高射炮打蚊子——锁的开销在纳秒到百纳秒级,还有争用排队。原子变量把三步捆成硬件级不可分割的操作:
#include <atomic> std::atomic<int> counter{0}; void bump() { for (int i = 0; i < 100000; ++i) counter.fetch_add(1, std::memory_order_relaxed); // 原子加一 } // 两个线程跑完 恒为 200000
memory_order_relaxed 只保证这次加一是原子的,不承诺与其他操作的顺序——计数统计够用了;需要"先写标志、后读数据"的发布关系就得用默认的顺序一致序(memory_order_seq_cst)或显式 acquire/release。内存序是专家领域,默认序性能损失有限,先写对再优化。经验分层:单变量统计用 relaxed 原子;标志位发布用 acquire/release;复杂共享状态老老实实 mutex。
std::atomic<bool> 的 compare_exchange(CAS)还是无锁数据结构与自旋逻辑的地基,标准库的 std::shared_ptr 引用计数(3.3 节控制块里的计数)正是靠原子操作实现多线程安全的。
四、条件变量:等通知的正确姿势
生产者消费者的"等到有活再干",用条件变量:
#include <condition_variable> #include <queue> #include <optional> std::mutex m; std::condition_variable cv; std::queue<int> jobs; void worker() { std::unique_lock<std::mutex> lock(m); // 可解锁再加锁的锁 cv.wait(lock, [] { return !jobs.empty(); });// 循环检查防虚假唤醒 int job = jobs.front(); jobs.pop(); lock.unlock(); process(job); } void submit(int x) { { std::lock_guard<std::mutex> lock(m); jobs.push(x); } // 先解锁再通知 效率更高 cv.notify_one(); }
wait(lock, 谓词) 内部是"解锁、睡等、被唤醒后加锁、验谓词、不满足继续睡"的循环——虚假唤醒(操作系统可能无故唤醒)决定了必须用谓词循环检查,不能裸 wait。unique_lock 比 lock_guard 灵活(支持中途解锁,wait 需要),代价是稍大稍慢;只做作用域加锁时仍首选 lock_guard。
排错工具箱压轴:ThreadSanitizer(-fsanitize=thread)能在运行时直接点名数据竞争的两处代码,与 ASan(3.1 节)并称并发双雄。多线程 bug 复现率低,上线前跑 TSan 的测试是性价比最高的防线。
💡 关键直觉:并发的内存模型规则可以浓缩成一句——共享且可变的数据,必须有同步;不共享或不可变,天然免竞争。设计并发程序的第一问不是"加哪把锁",而是"能不能让每个线程只碰自己的数据":线程私有栈(每个线程一个队列、最后归并)常常比共享结构加锁又快又简单。
本节要点回顾
- 数据竞争是未定义行为:不是概率 bug,编译器优化可让它彻底失控;TSan 上线前必跑。
- 线程二选一铁律:join 或 detach;detach 的线程不得引用短命数据。
- 锁守卫是 RAII:lock_guard 管作用域,unique_lock 管 wait,scoped_lock 管多锁防死锁。
- 原子变量的分层:统计 relaxed、发布 acquire/release、复杂共享用 mutex,内存序先写对再调优。
- 条件变量配谓词:虚假唤醒决定了循环检查;先解锁再 notify。
最后一节收拾工程化的两件工具:命名空间与编译预处理,把源文件装配成程序的四个阶段讲完整。