2.1 路径操作与参数声明:两种路由范式对比
2.1 路径操作与参数声明:FastAPI 与 Flask 路由范式对比
路径操作是 FastAPI 对"路由 + HTTP 动词 + 参数声明"三位一体的称呼:装饰器声明方法与路径,函数签名声明参数的名字、类型、默认值与约束,两者合起来构成接口的完整契约。本节把这种范式与 Flask 的路由写法逐项对照,覆盖路径参数、查询参数、枚举约束、参数元数据与多参数组合的工程实践。
本节能力目标
阅读完本节,你应当能够:
- 用 HTTP 动词装饰器声明接口,并解释它与 Flask 通用装饰器的差别;
- 在签名中区分路径参数与查询参数,说出框架的判定规则;
- 用 Enum 约束路径参数取值,用 Query 或 Path 添加范围与元数据;
- 处理"多参数 + 固定顺序"的接口设计问题;
- 识别 Flask 迁移过来时最容易踩的三个参数陷阱。
一、从装饰器说起:表面相似,语义不同
Flask 用一个通用装饰器配合 methods 参数:
@app.route("/items/<item_id>", methods=["GET"]) def get_item(item_id): ...
FastAPI 把方法做进装饰器名:
@app.get("/items/{item_id}") def get_item(item_id: int): ...
差别看似只是写法,实则改变了两个行为。其一,同一路径不同方法的注册:Flask 里 GET 与 POST 要么挤在同一个视图函数里用分支处理,要么写两个装饰器叠一个函数,FastAPI 则是两个独立函数各自声明,app.get 与 app.post 互不干扰。接口多了以后,"一个函数一个动作"的组织方式显著降低阅读负担。其二,路径冲突的暴露方式:FastAPI 按注册顺序匹配路由,同一路径的 {item_id} 与固定段(如 /items/me 与 /items/{item_id})谁先注册谁先生效,这一点和 Flask 相同,但 FastAPI 的文档页会把两个接口并列展示,冲突更容易在 review 时被发现——声明式的好处再次体现:注册什么,文档就展示什么。
二、框架怎么知道参数从哪里来
FastAPI 判定参数来源的规则很简单,值得一次讲透:
- 名字出现在路径模板里(
{item_id})→ 路径参数; - 类型是 Pydantic 模型 → 请求体;
- 其余(int、str、float、bool 及它们的 Optional 形态)→ 查询参数。
规则三条,但组合起来覆盖了绝大多数日常接口。对照 Flask:所有来源都从 request 对象上取——request.view_args、request.args、request.get_json——来源由你调用哪个方法决定,类型与合法性由你判断。两种范式没有能力差距,差距在约束的存放位置:FastAPI 把"参数叫什么、什么类型、什么范围"放进签名这个单一事实源,IDE 能补全、静态检查能看懂、文档能生成;Flask 的这些信息散在函数体里,只有运行到那一行才生效。
给一个对照样例,查询参数带约束:
from fastapi import FastAPI, Query app = FastAPI() @app.get("/products") def list_products( category: str | None = None, skip: int = 0, limit: int = Query(10, ge=1, le=100, description="每页数量"), ): return {"category": category, "skip": skip, "limit": limit}
Flask 版本的等价逻辑需要四行取值加两行校验,而且约束信息(limit 上限 100)不会出现在任何自动生成的产物里。description 参数会直接流进 OpenAPI 文档的参数说明——元数据与约束写在定义处,文档消费它,而不是文档另写一份。
三、枚举约束:把合法值集合写进类型
路径或查询参数的取值经常是一个有限集合:排序方向只有 asc 与 desc,环境只有 dev、staging、prod。FastAPI 的标准做法是 Enum:
from enum import Enum class SortOrder(str, Enum): asc = "asc" desc = "desc" @app.get("/orders") def list_orders(order: SortOrder = SortOrder.asc): return {"order": order.value}
传入 order=sideways 时返回 422,错误信息里列出合法值;文档页面上该参数会渲染成下拉框。对比手写方案——if order not in ("asc", "desc"): abort(400)——枚举方案把合法值集合变成了可复用的类型,多个接口共享同一个 Enum,新增取值时改一处。继承 str, Enum 是关键细节:不继承 str 时序列化与文档展示会出现 Enum 对象的 repr,这是新手高频坑。
四、多参数接口:顺序、分组与 Annotated
实际接口常常同时有路径参数、查询参数与请求体。直接看组合样例:
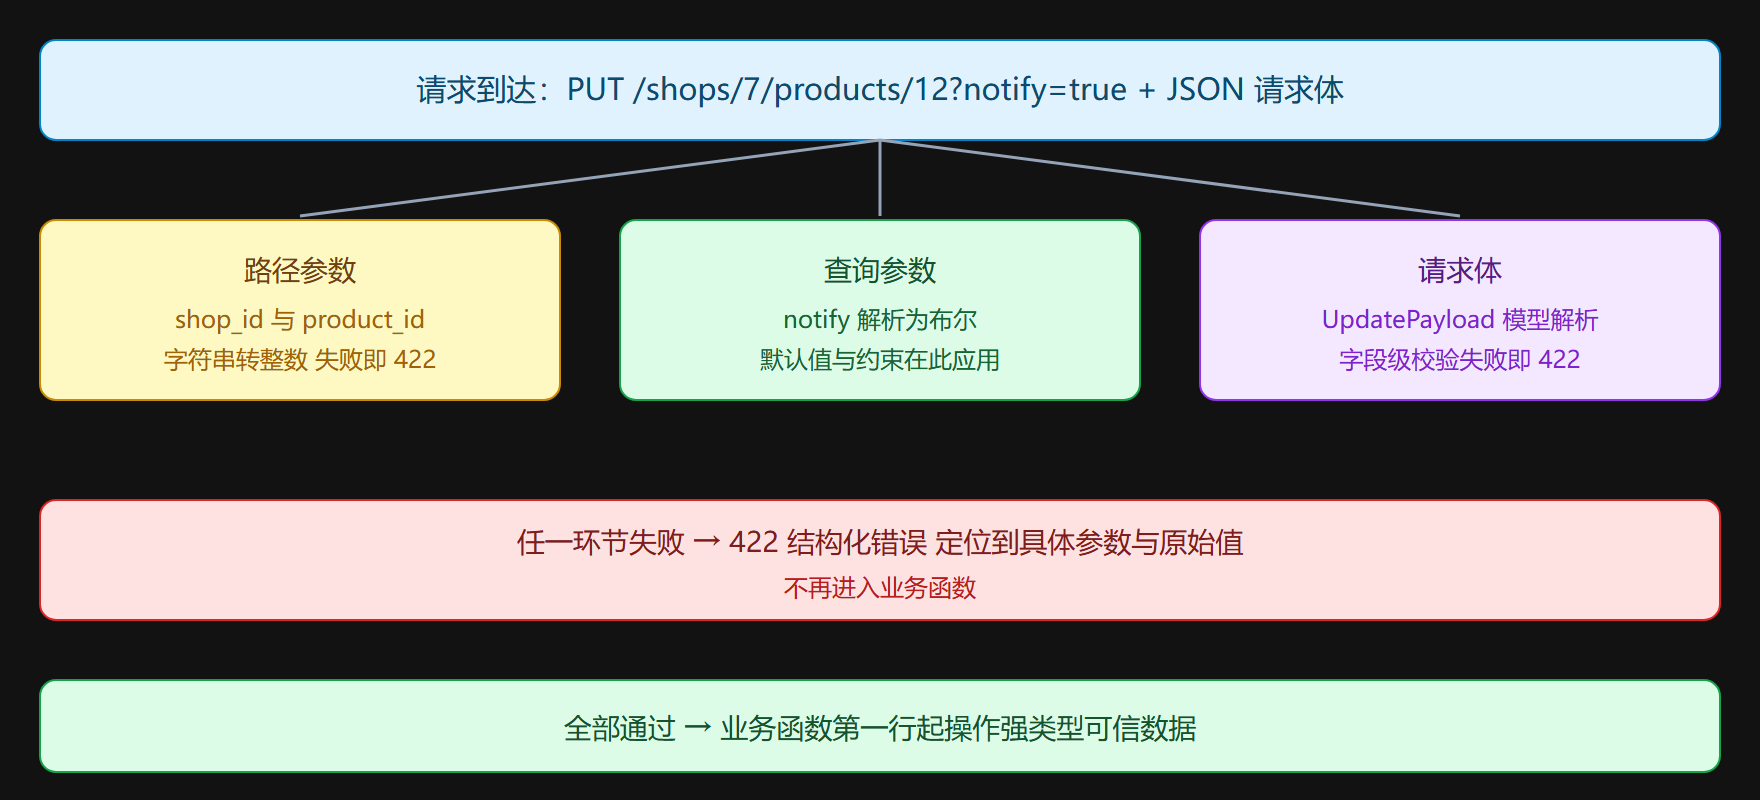
from typing import Annotated from pydantic import BaseModel class UpdatePayload(BaseModel): title: str tags: list[str] = [] @app.put("/shops/{shop_id}/products/{product_id}") def update_product( shop_id: int, product_id: int, payload: UpdatePayload, notify: bool = False, ): ...
四个参数三种来源,框架按前述规则自动分拣。这里推荐一个现代写法升级:把 Query、Path 这类元数据放到 Annotated 里:
def list_orders( limit: Annotated[int, Query(ge=1, le=100)] = 10, ): ...
Annotated 写法把类型与元数据绑在一起、默认值留在原位,避免老写法里 Query(10, ...) 同时承担默认值与约束的含糊,也是官方现在主推的风格。它还有一个实际收益:依赖注入的 Depends 同样可以放进 Annotated,第 3 章会沿用这套写法。
⚠️ 常见坑:
Optional[str]与str | None只声明"可以是空",不等于"可以不传"。是否必填由有没有默认值决定,q: str | None = None才是"可不传、传了可为空"。写成q: str | None而不给默认值,仍然必填。这两个概念在旧教程里经常混写,迁移存量代码时逐个核对。
五、Flask 迁移的三个典型陷阱
第一,静默回落消失。Flask 的 request.args.get("page", 1, type=int) 在传入非数字时静默用默认值 1;FastAPI 直接 422。迁移后如果监控里 422 突增,先怀疑上游一直在传脏数据,而不是框架有问题。
第二,斜杠行为差异。Flask 默认 strict_slashes 行为下 /items/ 会重定向到 /items(或反之),FastAPI 把带斜杠与不带视为两个不同路径,访问错的那一个得到 404。迁移时用路由表核对存量客户端的调用习惯,必要时在应用层面统一配置重定向中间件。
第三,查询参数的列表语义。FastAPI 里 tags: list[str] = Query([]) 天然支持 ?tags=a&tags=b 的重复键解析;Flask 需要 request.args.getlist("tags")。能力对等,但客户端若一直用逗号分隔的 ?tags=a,b 习惯,切到 FastAPI 后要改为重复键或自己 split——这类"客户端习惯迁移"是文档之外最容易漏的部分。
图示:一次请求的参数解析路径
六、设计取舍:参数该放路径、查询还是请求体
同一份信息常有多个可放的位置,选错了返工成本不低。经验法则:标识放路径,筛选分页放查询,命令数据放请求体。资源唯一标识(店铺 id、商品 id)进路径,REST 语义清晰且可被缓存层区分;过滤、排序、分页是"对集合的操作参数",放查询串,URL 自身携带语义;创建与更新承载的数据体量大、结构深,放请求体,避免 URL 长度与编码问题。灰色地带是布尔开关——?notify=true 简单直接,但如果开关将来会带子参数(通知谁、通知渠道),一开始就设计成请求体里的嵌套对象更留余地。字段位置的选择也是一种契约设计,定稿前多想一步,比上线后用兼容层补救便宜得多。
七、三个进阶参数场景
**场景一:日期与时间参数。**查询按日期过滤是高频需求,签名直接用 date 或 datetime 类型即可:start: date = Query(...)。FastAPI 会按 ISO 格式解析,传入非法日期返回 422 并指出期望格式。对照 Flask 手写 datetime.strptime 加 try/except 的写法,这里连格式文档都不用写——OpenAPI 里自动标注格式。时区是要留心的细节:datetime 解析接受带时区的 ISO 串,建议团队约定统一传 UTC 加显式时区,避免"服务器本地时区"这类隐性依赖。
**场景二:可选的复杂筛选。**列表接口的筛选条件经常是一组可选项(分类、价格区间、是否促销)。与其堆十个查询参数,不如引入一个 GET 请求体或保持参数平铺——业界实践分化,REST 纯度派坚持平铺查询参数,务实派接受 GET body(部分客户端与代理对 GET body 支持不佳,这是平铺更稳的技术原因)。平铺时的推荐形态:
class ProductFilter(BaseModel): category: str | None = None min_price: float | None = Field(default=None, ge=0) max_price: float | None = None on_sale: bool | None = None @app.get("/products") def list_products( page: int = Query(ge=1, default=1), filter_q: ProductFilter = Depends(), ): ...
用 Pydantic 模型加空的 Depends 把筛选参数收拢成一组——这是"查询参数也要建模"的进阶写法,参数多了以后可读性远胜二十个散参数,而且筛选逻辑可以直接复用模型的字段定义。这个技巧也常被用来实现"多接口共享同一套分页参数",是第 3 章类依赖的变奏。
**场景三:路径参数的校验边界。**Path 元数据同样支持约束:item_id: int = Path(ge=1) 限制 id 不小于 1。数值范围、长度、正则(pattern 参数)都能上。一个真实教训:没有下界约束的 id 参数会接收 0 与负数,如果数据库把 0 当有效主键查不到、又没报错,接口就悄悄返回了错误语义的空结果——显式 ge=1 把这类输入挡在 422,比排查"为什么这个接口偶尔返回空列表"便宜太多。
八、与文档的双向奔赴
本章反复出现"签名里的信息流进文档"这句话,这里把它说完整:参数的 name、类型、默认值、约束(ge、le、pattern)、Enum 取值、description,全部出现在 OpenAPI 的参数定义里;前端因此能在文档页看到每个参数的合法域,联调前就能发现"传错类型"这类低级问题。反向也成立——review 一个接口设计时,看它的文档页比看代码快:参数齐全性、约束合理性、命名一致性,在文档视图里一目了然。把"打开 docs 页"变成设计评审的标准动作,是签名驱动开发的完整闭环。
常见问题速答
**问题:路径参数想接受多种类型怎么办?**比如某个遗留接口的 id 有时是数字有时是字符串。答案是先问该不该——混合类型几乎总是历史包袱,正确动作是拆成两个接口或用 str 接收后自己转换并显式声明规则。用联合类型标注让框架自动尝试多种解析在技术上可行,但文档会变得难以描述,前端的类型定义也无从下手,兼容的代价转移到了每个消费方。
**问题:查询参数太多,URL 超长怎么办?**筛选条件极多的搜索接口(几十个可选参数)确实会遇到 URL 长度限制。两个出路:精简参数(多数可选筛选其实没人用,访问日志统计一下就知道);确实复杂的搜索改成 POST 加请求体——REST 纯度上有争议,但工程上普遍接受搜索即命令的解释,专业搜索类 API 多是这种形态。
问题:参数校验规则与业务规则重叠时放哪?签名能表达的(类型、范围、枚举、格式)进签名,哪怕它同时也是业务规则;需要查库或跨字段才能判定的(邮箱是否已注册)留给业务层。判据是校验所需的信息是否都在请求内——签名校验只看请求本身,需要外部状态的校验必然在业务层。两层校验的报错格式不同(422 与业务错误码),前端按状态码分流即可。
本节要点回顾
- 三位一体:方法装饰器、路径模板、签名参数共同构成接口契约,文档从中生成而非另写。
- 来源判定三规则:名字在路径里是路径参数,Pydantic 模型是请求体,其余简单类型是查询参数。
- 枚举约束:继承
str, Enum的枚举把合法值集合变成类型,多接口共享、文档渲染为下拉框。 - Annotated 写法:元数据与类型绑定、默认值留原位,是官方主推的现代签名风格,依赖注入同样适用。
- 必填与可空:默认值决定必填,
| None决定可空,两个概念正交,混写是迁移期高频 bug 来源。 - 三个迁移陷阱:静默回落消失、斜杠行为差异、列表参数的键重复语义。
参数的声明解决了"标量怎么进来",下一节处理更难的输入面:结构化的请求体,以及 Pydantic 模型如何替代手写字典校验。
- 声明的复利:参数写在签名里的一次投入,换来编辑器补全、静态检查、文档生成、测试断言四处收益——这是全册反复出现的投入产出结构。
记住这个顺序:先想清楚每个参数的身份与归宿,再动笔写签名,最后让文档替你复核一遍设计。