2.3 数据验证与Pydantic:v1与v2关键差异
2.3 数据验证与 Pydantic:v1 与 v2 的关键差异
Pydantic v2 用 Rust 重写的校验内核替换了 v1 的纯 Python 实现,API 表面也随之大改:校验器装饰器更名、序列化方法重组、错误结构从字典改为对象列表、Config 类变成 ConfigDict。FastAPI 从 0.100 起双轨支持两个大版本,存量代码与新版教程并存是这个时期最大的混乱来源。本节逐项对比两个版本的差异,给出迁移检查清单与双版本共存的判断标准。
本节能力目标
阅读完本节,你应当能够:
- 判断手上项目跑的是 Pydantic v1 还是 v2,以及 FastAPI 版本是否两者兼容;
- 把
@validator与@root_validator迁移为 v2 的等价写法; - 说出序列化 API(dict、json、parse_obj)在 v2 中的新名字;
- 解释 v2 性能提升的来源与"哪些场景感受不到";
- 用检查清单评估存量项目迁移的工作量与风险。
先判断你在哪个世界
三个快速判据。第一,看依赖清单里 pydantic 的主版本号,1.x 还是 2.x。第二,看代码里有没有 from pydantic import validator——v2 里这个名字被 field_validator 取代(validator 在 v2 中是兼容别名,运行时打弃用警告)。第三,看 FastAPI 版本:0.100 之前只支持 v1,0.100 起支持 v2(同期保持对 v1 的兼容),这是判断"能否无痛升级"的分水岭。
混乱的根源在于时间差:大量中文教程与开源示例写于 v1 时代,而新建项目默认装 v2。照着旧教程在新环境里写 @validator,代码能跑但每次启动刷一屏弃用警告;更糟的是旧写法里 cls、values 参数的语义在 v2 兼容层里有细微变化,边界行为可能与教程描述不符。读任何 FastAPI 或 Pydantic 资料,第一件事是确认它的 Pydantic 版本假设——这是本节存在的理由。
校验器:同一件事的两代写法
单字段校验器,v1 写法:
from pydantic import BaseModel, validator class Account(BaseModel): name: str @validator("name") def name_not_blank(cls, v): if not v.strip(): raise ValueError("姓名不能是空白") return v.strip()
v2 写法:
from pydantic import BaseModel, field_validator class Account(BaseModel): name: str @field_validator("name") @classmethod def name_not_blank(cls, v): if not v.strip(): raise ValueError("姓名不能是空白") return v.strip()
变化有三处:装饰器更名、必须叠加 @classmethod、校验函数签名从"值在前"的宽松形态固定为 cls 加值。多字段联合校验的变化更大——v1 的 root_validator 变成 v2 的 model_validator,且区分"校验前"(拿原始字典)与"校验后"(拿已构造的字段值)两种模式:
from pydantic import BaseModel, model_validator class Signup(BaseModel): password: str confirm: str @model_validator(mode="after") def passwords_match(self): if self.password != self.confirm: raise ValueError("两次密码不一致") return self
语义差异要留意:v1 的 validator 默认 each_item=False 且允许通过 values 参数访问"已校验的前序字段"——这是一个隐式依赖字段声明顺序的机制;v2 明确不鼓励这种用法,跨字段规则统一走 model_validator,字段级校验器保持纯净。迁移时凡是 v1 校验器里用了 values 参数的,都要重新审视:它到底想做单字段规则还是跨字段规则,前者去掉 values 就能迁移,后者改写成 model_validator 更正统。
序列化与解析 API 的更名表
v2 把一批方法统一改名,迁移时按下表对照替换:
| v1 写法 | v2 写法 | 用途 |
|---|---|---|
Model.dict() |
model_dump() |
转字典 |
Model.json() |
model_dump_json() |
转 JSON 字符串 |
Model.parse_obj(data) |
model_validate(data) |
从字典构造并校验 |
Model.parse_raw(s) |
model_validate_json(s) |
从 JSON 字符串构造 |
Config 内部类 |
model_config = ConfigDict(...) |
模型配置 |
.copy() |
.model_copy() |
复制实例 |
命名从"挂在类上的散装方法"变成"model_ 前缀的统一家族",好处是 IDE 里打 model_ 就能看到全部模型级操作。配置的迁移尤其常见:v1 的 class Config: orm_mode = True 在 v2 里是 model_config = ConfigDict(from_attributes=True)——名字从 orm_mode 改为 from_attributes 是语义纠偏,它表示"允许从任意对象按属性取值构造",并非只服务于 ORM(第 6 章数据库集成一节会用到它)。
错误结构的演进
v1 的 ValidationError.errors() 返回嵌套字典,列表下标以字典键 __all__ 等特殊形式出现;v2 改为扁平列表,loc 统一是 (字段名, 下标, 子字段) 的元组序列,并新增 type、input、url 三个字段。对 FastAPI 用户的影响是间接的——框架已经把错误格式化成响应——但直接使用 except ValidationError 做自定义错误处理的代码要核对字段访问方式。v2 错误里的 url 指向官方错误码文档,排错时相当好用。
性能:提升来自哪里,何时感受不到
v2 的核心卖点是校验性能数倍到数十倍提升,来源是 pydantic-core 用 Rust 实现了类型解析与校验热路径,Python 层只在进入自定义校验器时被调用。但要在心里校准预期:纯模型构造与解析的场景受益最大(批量导入、消息消费、大请求体),而典型 Web 请求的耗时大头在网络与数据库——一个 200 字节的请求体校验从 0.3 毫秒降到 0.05 毫秒,对总响应时间的影响不可感知。性能提升的真实意义在于让 Pydantic 能进入它以前不敢进的场景:日志结构化管道、流式数据清洗、高频消息反序列化。选 v2 的首要理由是生态方向与长期维护,性能是顺带的红利。
反方向的注意点也存在:v2 的某些行为比 v1 严格。字符串自动转数字在 v1 的宽松模式下被允许("123" 能进 int 字段),v2 默认拒绝非严格匹配;v1 里一些隐式拷贝行为在 v2 改为引用共享。迁移后的测试若出现意料外的 422,优先排查这类严格化点。
图示:v1 到 v2 的迁移全景
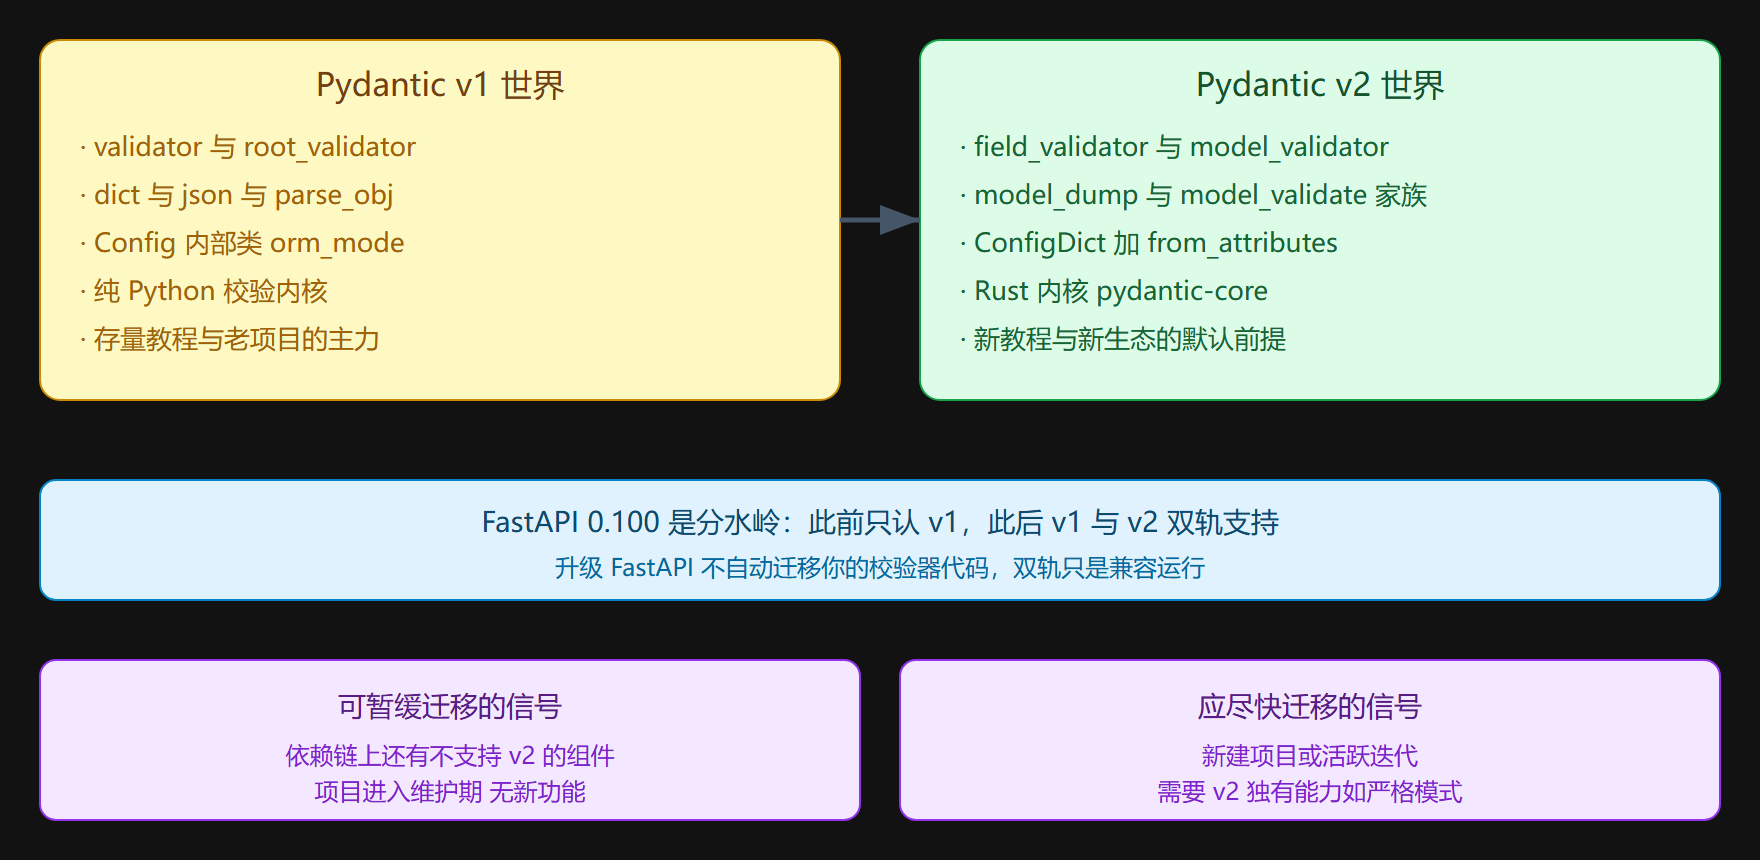
迁移检查清单
按顺序核对,多数项目半天到两天能完成主体迁移:
- 锁定 FastAPI 版本到 0.100 以上,升级 pydantic 到 2.x;
- 全局搜索
@validator、@root_validator、.dict()、.parse_obj、orm_mode五个关键词,逐处替换为 v2 写法; - 核对使用了
values参数的校验器,判定单字段还是跨字段规则并分流; - 检查直接消费
ValidationError.errors()的代码,适配新的扁平结构与 type 字段; - 跑全量测试,重点盯 422 突增的用例——大概率命中 v2 严格化点(字符串不再自动转数字等);
- 清理依赖里残留的
pydantic.v1兼容导入,避免半迁移状态长期化。
v2 也提供了 from pydantic import v1 的兼容入口,允许同一代码库里新旧并存——但只建议作为迁移的过渡手段,长期共存等于同时维护两套心智模型,得不偿失。
v2 的新能力:迁移之外值得用上的三件事
迁移是守成,v2 还带来了 v1 做不到或做不好的表达,至少三件值得主动用上。
**严格模式(strict mode)。**v1 的解析是"能转就转"的宽松哲学,字符串数字互转在边界处制造过无数惊喜。v2 支持按字段或按模型声明严格性:严格模式下 "123" 不会进入 int 字段,直接报错。对外 API 建议默认非严格(对客户端友好),对内服务间调用建议严格(上游应该传对类型,宽松只会延迟问题暴露到更深处)——一台机器两种口径,v1 做不到。
**TypedDict 与 TypeAdapter。**不是所有结构都值得建一个完整模型类——轻量场景(一个只有两个键的配置结构)用 TypedDict 加 TypeAdapter 同样获得校验能力,省掉类的仪式。TypeAdapter 还能校验模型类之外的类型(裸 list、字典的字典),补上了 v1 时代"顶层不是模型就没法校验"的缺口。
**computed_field(计算字段)。**v1 里"输出时算一个字段"要靠自定义序列化方法或 property 加排除组合拳,v2 的 computed_field 装饰器把派生字段变成模型的一等公民—— fullName 由 firstName 与 lastName 计算、金额由单价数量推导,声明在模型里、出现在文档里、参与输出校验,三样全占。
双版本共存的现实场景与收尾判断
哪些项目会真的处于双版本共存态?三类:依赖链拖累(某个内部库还停在 v1,全量升级要协调多个仓库);平台限制(固化环境里 Python 版本或系统库版本卡住了 pydantic-core 的安装);维护期项目(不接新需求,升级风险大于收益)。这三类的共同点是"共存是被迫的过渡",解法是给共存设一个明确的退出期限——按依赖链的升级排期、按环境改造的里程碑,把"暂时"钉死成日期。没有期限的双版本共存,最终会变成只有一个人懂的祖传代码。
收尾判断的信号也值得写下:迁移完成的标志不是"没有报错",而是三条全部满足——全仓库搜不到 v1 的五个关键词、测试全绿且 422 用例数与迁移前持平(突然变多或变少都值得追查)、依赖树里没有残留的 v1 兼容包。第三条常被忽略:某些第三方包会拖着一根 v1 的暗线,版本树里看一眼 pydantic 的依赖来源,干净了才算真正到站。
常见问题速答
**问题:FastAPI 会强制我升级 Pydantic 吗?**不会主动强制,但会跟随生态。FastAPI 在 0.100 之后长期维持双版本支持,旧的 v1 代码可以继续跑——压力来自别处:新版本的第三方库(数据库工具、配置库)逐渐只测 v2,安全修复的优先级也向 v2 倾斜。被动等待的结局是某次依赖升级时被迫仓促迁移,主动排期的结局是从容两步走。
**问题:迁移后行为完全一致吗?**大部分一致,少数边界收紧。最值得测的三处:字符串到数字的自动转换(v2 默认拒绝)、空字符串进数字字段的边界(v1 部分场景接受)、时区相关字段的解析细节。迁移检查清单的最后一步保持 422 用例数持平,就是为捕捉这些差异设计的。
**问题:新项目直接学 v2 会看不懂旧资料吗?**会有一段阵痛但值得。读旧资料时把更名表放在手边,遇到旧校验器装饰器心里翻译成新写法、遇到旧转字典方法翻译成 model_dump,翻译几次就形成自动映射。反过来先学 v1 再迁移的路线成本更高——你要学两套写法还要背差异清单。
本节要点回顾
- 版本判断:依赖版本号、校验器导入名、FastAPI 是否达到 0.100,三个判据快速定位所处世界。
- 校验器迁移:
validator到field_validator加classmethod,跨字段规则从root_validator与 values 参数迁移到model_validator。 - API 更名表:model_ 前缀家族(dump、validate、copy)与 ConfigDict 配置是 v2 的统一表面。
- 性能校准:Rust 内核红利在批量解析场景最大,典型 Web 请求里几乎不可感知;选 v2 的核心理由是生态方向。
- 严格化点:字符串不再自动转数字等行为收紧,是迁移后 422 突增的头号嫌疑。
- 迁移策略:清单六步走,兼容入口只作过渡,拒绝长期双轨。
输入侧的地基打完,第 3 章转向执行侧:同样的接口声明,同步与异步两种执行模型在框架里如何分野,依赖注入又如何把横切关注点收拢进签名。
延伸与边界
版本迁移话题的边界在"你的依赖链可控范围":自己的代码、自己的模型随时可迁;依赖的第三方包要等它的维护者。评估迁移时机时先画依赖地图——哪些包已经支持 v2、哪些还在观望、哪些已停更。停更的包是最早的迁移信号:它拖住的不只是 Pydantic 版本,还有 Python 版本、安全补丁整条链。版本管理本质是依赖链的健 康管理,Pydantic 这场迁移只是你第一次系统地做这件事,同样的方法将来会用在 Python 大版本、数据库驱动、消息协议的每一次跃迁上。
- 版本即生态位:知道自己在 v1 还是 v2 世界,等于知道哪些教程可信、哪些写法会报错、哪些升级排在路上——版本意识是框架知识的时间坐标。
把更名表贴在团队的知识库里,迁移期的每个疑问它都能三十秒给答案,省下的争论远不止半点。
最后提醒一句:迁移完成后删掉所有兼容导入的那一天,值得在团队群里庆祝一下——那标志着知识债的清偿完毕,两套心智模型正式归一。