5.2 后台任务:BackgroundTasks与Celery取舍
5.2 后台任务:BackgroundTasks 与 Celery 的取舍对比
后台任务的本质问题是"响应返回之后,谁替你把剩下的活干完":FastAPI 内置的 BackgroundTasks 把函数推迟到响应发送后在本进程执行,零部署成本但不保证可靠;Celery 用独立 worker 进程加消息队列承接任务,可靠可扩展但引入整套基础设施。本节给出选择判据、两者的时序细节与常见误用。
学习目标
阅读完本节,你应当能够:
- 用三个判据(耗时、可靠性、结果追踪)决定任务放哪层;
- 正确使用 BackgroundTasks 并说明其执行时机与异常去向;
- 描述 Celery 架构的组件分工与部署形态;
- 识别"该用队列却用了进程内后台"的三种翻车形态;
- 在 FastAPI 中接入 Celery 任务并设计回调通知。
先看内置方案有多简单
发邮件、写审计日志、清理缓存——这类"用户不必等结果"的活,BackgroundTasks 一行挂载:
from fastapi import BackgroundTasks def send_welcome_email(uid: int): user = load_user(uid) smtp.send(to=user.email, template="welcome") @app.post("/users", status_code=201) def create_user(payload: CreateUser, tasks: BackgroundTasks): uid = save_user(payload) tasks.add_task(send_welcome_email, uid) return {"id": uid}
add_task 收函数加参数,路由返回并完成响应发送后,框架在同一个事件循环或线程池里执行它。用户拿到 201 的速度不受邮件发送影响;任务函数可以是同步也可以是 async,框架按第 3 章的分派规则处理。
执行时序的一个细节:任务是"响应发送后"而非"响应构建后"执行——StreamingResponse 场景下,任务是等流全部送完之后才开始的。如果你在测试里断言"接口返回后邮件已发出",偶发失败的原因就在这:任务还在队列里没轮到执行,测试需要主动等待或轮询任务完成信号。
异常去向要明确:任务抛出的异常不会影响已发出的响应,只会出现在服务端日志里。用户成功了、邮件失败了,用户不知道——这就是可靠性的边界。对营销邮件这无所谓,对"订单确认函""密码重置邮件"这类用户强依赖的动作,静默失败就是事故。
三判据:什么时候必须上队列
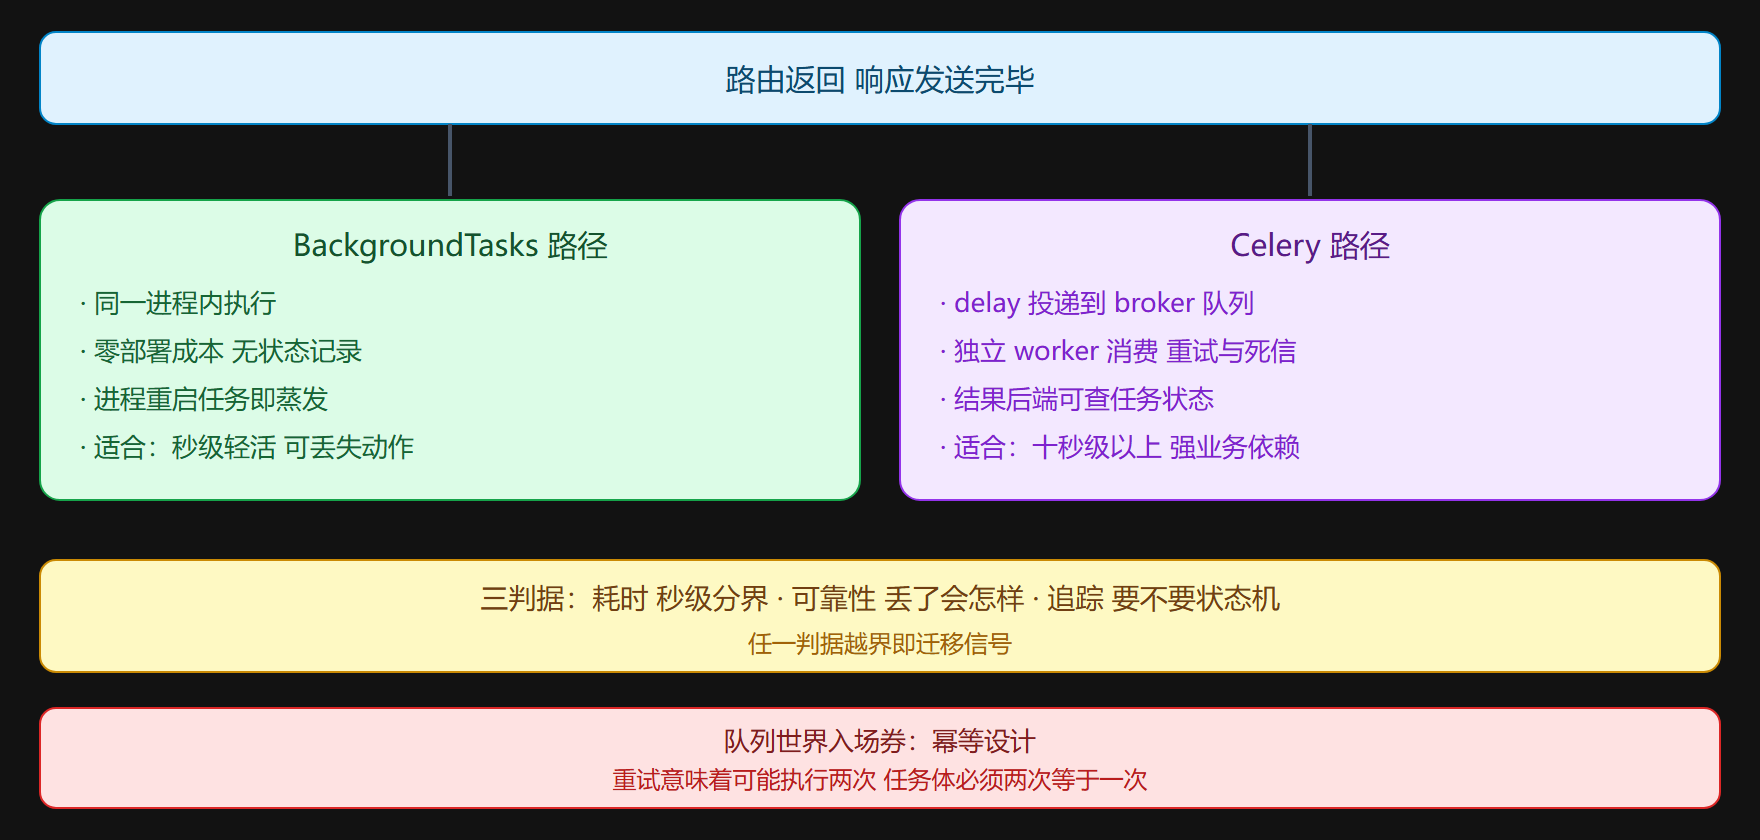
耗时判据。BackgroundTasks 占用的是服务进程的资源。一个 30 秒的报表生成任务挂在 async 环境里,会占住线程池一个线程(同步任务函数)或需要小心拆分 await 点(async 任务函数);批量请求一来,正常请求的处理容量被后台任务蚕食。经验界线:秒级以内的轻活进程内做,十秒级以上的活独立进程做。
可靠性判据。进程内任务活在服务进程的寿命里:部署重启、崩溃、超时被杀,未执行完的任务直接蒸发,且没有任何记录说明"曾有任务、执行到哪"。消息队列的任务躺在 broker 里,worker 重启后继续消费;broker 持久化配置得当,连 broker 重启都能扛。判据是业务问题:"这个任务丢了会怎样"——丢了只是晚点补发,进程内够;丢了要客诉要赔付,必须队列。
结果追踪判据。BackgroundTasks 没有任务状态的概念(没有"排队中、执行中、成功、失败"),没有重试,没有死信。Celery 有完整的状态机与结果后端,任务失败自动重试、多次失败进死信队列待人工处理。需要向用户展示"任务进度"的功能(导出任务列表页那种)直接依赖这套状态机。
三种翻车形态对照:部署窗口丢任务(可靠性)、高峰期接口变慢(耗时)、用户问"我的报告呢"而系统无从查起(追踪)——任一形态出现,就是迁移到队列的信号。
Celery 架构:组件与部署
Celery 的标准架构四件套:生产者(你的 FastAPI 进程,调用 delay 把消息丢进队列)、broker(Redis 或 RabbitMQ,任务的暂存地)、worker(独立进程池,消费任务并执行)、结果后端(可选,Redis 或数据库,存任务状态与返回值)。
from celery import Celery celery_app = Celery("tasks", broker="redis://redis:6379/0", backend="redis://redis:6379/1") @celery_app.task(bind=True, max_retries=3) def generate_report(self, uid: int, range_days: int): try: rows = query_aggregate(uid, range_days) upload(build_xlsx(rows)) except TransientError as exc: raise self.retry(exc=exc, countdown=30) @app.post("/reports") def create_report(payload: ReportReq, user=Depends(get_current_user)): task = generate_report.delay(user.id, payload.range_days) return {"task_id": task.id, "status": "queued"}
FastAPI 侧只做"接单":校验参数、丢任务、把 task_id 还给客户端。客户端轮询任务状态接口(查结果后端)或订阅通知。Web 进程与 worker 进程彻底解耦——部署、扩容、重启互不影响,这是架构上的根本差异,而不只是"换个执行器"。
Flask 生态的对应物就是 Celery 本身(或轻量的 rq),迁移时任务定义与 worker 部署几乎原样保留,变的只是"谁调用 delay"——从 Flask 视图变成 FastAPI 路由。真正的成本在基础设施:Redis 或 RabbitMQ 的运维、监控(花队列长度、worker 存活)、任务幂等设计。幂等是队列世界的入场券:重试机制意味着同一任务可能执行两次,任务体必须设计成"执行两次等于执行一次"(用唯一键约束、带版本号的更新、或先检查后执行的幂等写法)。
中间地带:进程内方案的补强
不必一步到位上 Celery 的场景,BackgroundTasks 也能做得比默认更稳:把任务的关键动作用数据库表落地(先写"待发送"记录,任务执行后更新状态),失败的任务靠定时扫描补偿——相当于用几十行代码实现了微型队列的可靠性。这个方案的实质是把可靠性从基础设施转移到数据层,适合已有数据库、暂不想加 Redis 的中小项目。它的极限也明显:没有并发控制(多进程重复消费)、没有优先级、补偿扫描有延迟——业务涨到需要这些特性的那天,就是迁 Celery 的那天。
另两个易混机制在此划清边界:asyncio.create_task 是"当前事件循环内的并发协作",生命周期与请求无关、与进程共存亡,适合长连接内的推拉配合,不是后台任务系统;Starlette 的 repeat 周期任务同理。判断口诀:跟请求走的是 BackgroundTasks,跟进程走的是 asyncio 任务,跟业务走(要可靠要追踪)的是队列。
实战样本:通知系统的两段演化
用一个常见需求的两次演化展示判据的落地。需求:用户下单后发确认邮件、商家端发通知、凌晨跑对账。
第一版,订单路由里两处 add_task 承接邮件与商家通知,对账用系统定时器触发独立脚本。运行三个月出过两次问题:部署窗口撞上发送任务,几封邮件丢失(商家客诉);对账脚本与 Web 进程抢数据库连接,凌晨偶发超时。两次问题分别对应可靠性判据(丢任务无记录可查)与资源隔离判据(对账的重查询影响在线服务)。
第二版,通知类任务落库加补偿扫描——订单事务里先写通知记录(状态待发),后台任务发送成功后更新状态,另有一个每五分钟的扫描补发超时未发的记录。部署丢任务的问题随之消失:记录在数据库里,进程重启后扫描自然补发。对账整体迁出 Web 进程:改为 Celery 任务,独立 worker 连只读副本,在线服务彻底无感。
两版之间没有对错,只有时机:第一版是五人以下团队的正确选择——当天上线、零新增基础设施;第二版是业务量与团队变化后的正确选择。值得学的是两次升级各自响应的判据——可靠性要记录与补偿、隔离要独立进程与资源——判据在前,技术选型只是判据的翻译。下次面对"要不要上队列"的争论,把两个判据摆上桌,讨论立刻从偏好之争变成工程计算。
图示:两条任务路径的对照
常见问题速答
**问题:BackgroundTasks 能做重试吗?**没有内建重试——失败只进日志。要重试就得自己写循环或落库补偿(正文的中间地带方案),写到第三层条件时就该承认:你需要的是队列。把重试逻辑的复杂度当作迁移时机的温度计,比任务耗时更准。
**问题:任务队列的消息中间件选 Redis 还是 RabbitMQ?**多数团队该选 Redis:已有运维经验、性能足够、文档最多。RabbitMQ 的优势在路由灵活性与消息可靠性语义(确认、死信的路由级支持),复杂分发场景才值得为它多养一套组件。与本章主题一致的判断方式:先问消息丢了会怎样、路由需求有多复杂,再选零件。
**问题:任务里要用数据库会话,怎么拿?**Celery 工作进程与网页进程是两个世界,不能复用网页端的依赖注入——任务函数里自己创建会话(用同一套会话工厂),生命周期覆盖任务执行。这也是跟业务走的资源在任务进程自建的通例:依赖注入的会话生命周期绑定 HTTP 请求,任务世界有自己的生命周期管理方式。
**问题:怎么防止任务堆积?**三道闸:入口限流(网关层或代理配置)、队列长度告警(中间件的堆积量监控,超阈值先告警再扩工作进程)、消费端背压(工作进程并发数与数据库容量的联动,本质又是容量三算)。任务系统的容量问题与第 7 章部署的容量问题同构——都是生产速率、消费速率、资源上限的三角平衡。
本节要点回顾
- 执行时机:BackgroundTasks 在响应发送完毕后执行,测试断言要处理这个时序差。
- 三判据:秒级耗时界线、"丢了会怎样"的可靠性追问、状态追踪需求,任一越界上队列。
- 架构差异:Celery 的生产者、broker、worker、结果后端四件套让 Web 与任务进程彻底解耦,代价是基础设施运维。
- 幂等纪律:重试机制的必然推论是任务可能重复执行,幂等是设计约束不是优化项。
- 中间地带:数据库表加补偿扫描能用几十行代码买到部分可靠性,是中小项目的合理停留点。
- 三机制口诀:跟请求走用 BackgroundTasks,跟进程走用 asyncio 任务,跟业务走用队列。
延伸与边界
任务体系的边界在"本机与集群":BackgroundTasks 是单进程视角的机制,多 worker 部署下每个 worker 各自执行自己接到的任务,彼此不可见——这通常没问题(任务是独立原子),但想全局协调(同一任务全集群只跑一次)就超出了它的能力,那是分布式锁与队列的领地。延伸方向是任务的编排:单任务之上还有工作流(任务 A 成功后触发 B、失败走 C),Celery 的链式组合、回调签名覆盖了部分需求,更复杂的编排该看专门的工作流引擎——但先问业务是否真需要编排,多数"看起来需要"的场景用两个独立任务加状态字段就够。
最后补一条与第 7 章的连接:任务进程的容量规划与 Web 进程同构(worker 数、并发数、下游容量三算),部署形态也同构(容器化、健康检查、优雅停机)——学过第 7.1 节后回头配置 Celery 的 worker 参数,会发现是同一套思考的第二次应用。
- 异步之上有可靠:把慢活挪出请求只是第一步,让它可查、可重试、可补偿才是完整的后台体系——判据先行,工具随后。
把三判据写成一页决策纸贴在任务系统的设计文档里,每次新任务的评审先过这张纸。
另外记住:两种方案不是替代关系而是接力关系,多数服务的一生会先后用到它们,且交接点上两者并存运行一段时日。