6.1 数据库集成:SQLAlchemy同步与异步对比
6.1 数据库集成:SQLAlchemy 同步与异步对比
FastAPI 没有内置 ORM,数据库集成的标准答案是 SQLAlchemy 加依赖注入:引擎与连接池在应用启动时创建,会话由带 yield 的依赖按请求分发,事务边界就是请求边界。同步与异步两种引擎形态对应第 3 章的两种执行模型,选错形态会同时损失吞吐与稳定性。本节给出两套完整写法与取舍判据。
学习目标
阅读完本节,你应当能够:
- 搭出同步引擎加 def 路由的会话架构并解释线程池协同;
- 搭出异步引擎加 async 路由的等价架构;
- 说明会话依赖里提交与回滚的事务时序;
- 配置连接池参数并解释每个参数的容量含义;
- 论证 ORM 模型与接口模型分开维护的理由。
同步形态:线程池里的老朋友
SQLAlchemy 2.x 的同步架构三件套(声明基座、引擎、会话工厂):
from sqlalchemy import create_engine from sqlalchemy.orm import DeclarativeBase, sessionmaker engine = create_engine( "postgresql+psycopg2://user:pass@db:5432/app", pool_size=10, max_overflow=5, pool_pre_ping=True, ) SessionLocal = sessionmaker(bind=engine, expire_on_commit=False) class Base(DeclarativeBase): pass
会话按请求分发,靠第 3 章的依赖模式:
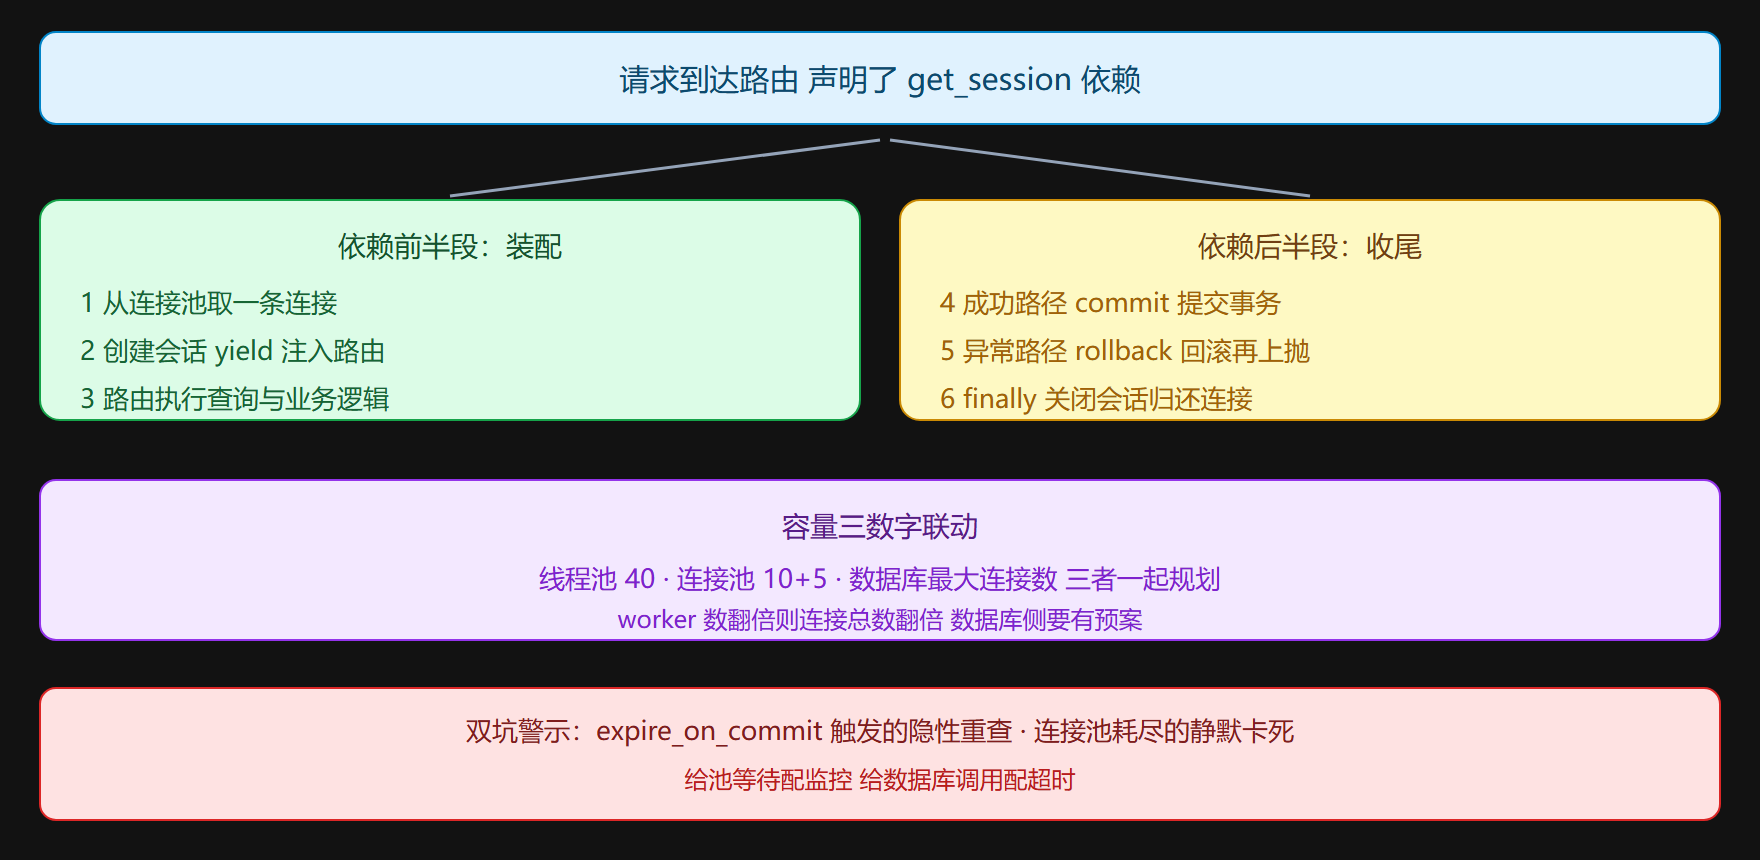
def get_session(): session = SessionLocal() try: yield session session.commit() except Exception: session.rollback() raise finally: session.close()
这段依赖是事务边界的全部秘密:路由成功返回则提交(yield 后的 commit 在响应流程中执行),路由抛异常则回滚再由异常处理器接管(第 4 章讲过的时序)。一个请求一个事务的语义不需要任何装饰器或中间件,由依赖的 yield 结构自然成立。路由侧用 def:
@app.get("/users/{uid}", response_model=UserOut) def get_user(uid: int, session=Depends(get_session)): return session.get(User, uid)
def 路由被派发到线程池,同步的 psycopg2 在线程里阻塞——阻塞的是线程不是事件循环,第 3 章的安全网照常工作。容量算术要连起来看:线程池默认 40,连接池 10 加溢出 5——第 41 个并发请求等线程,第 16 个拿到线程的请求等连接。三个数字(线程数、连接数、数据库实际承载)要一起规划,任何一处过小都会成为假瓶颈。
异步形态:事件循环里的对应物
from sqlalchemy.ext.asyncio import create_async_engine, async_sessionmaker, AsyncSession async_engine = create_async_engine( "postgresql+asyncpg://user:pass@db:5432/app", pool_size=10, max_overflow=5, pool_pre_ping=True, ) AsyncSessionLocal = async_sessionmaker(async_engine, expire_on_commit=False) async def get_session(): session = AsyncSessionLocal() try: yield session await session.commit() except Exception: await session.rollback() raise finally: await session.close()
路由侧换成 async def,查询语句加 await:
@app.get("/users/{uid}", response_model=UserOut) async def get_user(uid: int, session=AsyncSession = Depends(get_session)): return await session.get(User, uid)
结构完全同构,差异在驱动(asyncpg 替代 psycopg2)与等待方式。性能特征回到第 3 章的结论:异步形态下单个查询等待时事件循环继续服务其他请求,千级并发挂起成为可能——前提是路由里没有别的阻塞调用把循环卡住。
选型判据沿用第 3 章的迁移路线:存量同步代码库先跑同步形态(改动最小、行为等价),热点接口与新建服务直接异步形态。混用是大坑:同一个应用里 def 路由用同步会话、async 路由用异步会话是可行的(两套依赖分别命名),但同一个路由里混用同步会话与 async def——事件循环被数据库调用卡死,属于第 3 章反模式的标准案例。宁可整路由同步,不要半路异步。
连接池参数的工程含义
pool_size 是常驻连接数,max_overflow 是峰值允许的临时扩容,两者之和是应用对数据库的连接上限;pool_pre_ping 每次取连接前发 ping,剔除被数据库或防火墙悄悄断掉的死连接——生产环境必开,代价是每次取连接多一次往返。pool_recycle 定期重建连接,对付有连接寿命限制的中间件(MySQL 的 wait_timeout 场景)。
容量规划的三个事实要对齐:数据库侧的最大连接数(PostgreSQL 默认 100)要大于全部应用实例的连接总和;连接池配置只在进程级别生效——4 个 uvicorn worker 就是 4 份独立的池;Kubernetes 环境里 Pod 数量翻倍时连接总数跟着翻,数据库侧要有预案(代理层如 PgBouncer 做连接复用是规模化后的标配)。第 7 章部署的 worker 数量决策会直接引用这里的数字。
双轨模型:ORM 模型与接口模型
ORM 模型描述存储结构,接口模型(第 2 章)描述对外契约,两者分开是纪律而不是冗余:
class User(Base): # ORM 模型:表结构 __tablename__ = "users" id: Mapped[int] = mapped_column(primary_key=True) name: Mapped[str] email: Mapped[str] password_hash: Mapped[str] # 敏感字段只在这里 class UserOut(BaseModel): # 接口模型:对外形状 id: int name: str email: str
password_hash 存在于存储层、不存在于契约层——response_model 的过滤防线(第 4 章)加上模型分轨,敏感字段要"泄漏"需要同时突破两道关卡。两个模型之间的转换发生在路由或服务层,from_attributes(v2 的配置,v1 叫 orm_mode)让 Pydantic 能直接从 ORM 实例构造接口模型。
SQLModel 试图把双轨合一:一个类同时是 SQLAlchemy 模型与 Pydantic 模型。收益是少写一半类、少一次转换;代价是两个关注点重新耦合——表结构的演进直接影响接口契约,敏感字段排除又回到手动排除列表的老路。我的判断:原型与小型项目用 SQLModel 提速合理;接口契约需要独立演进的成熟项目,双轨的"冗余"是隔离层不是负担。FastAPI 作者同时维护两个项目,官方立场也是按项目阶段选择,而非替代关系。
⚠️ 常见坑两则:expire_on_commit 不设 False 的话,提交后访问属性会触发一次新的查询——在响应序列化阶段访问已过期属性,异步形态下会直接报"缺 await"的错,报错信息完全不指向真实原因,排查极耗时。第二,连接池耗尽的现象是请求 hang 住无超时——表现为莫名卡死而非报错,监控里给池等待加上指标或至少给数据库调用加超时,才能让这类问题以 500 的面目暴露而不是以卡死的面目隐藏。
图示:一次请求中的数据流与事务边界
迁移与生态附注
从 Flask 加 Flask-SQLAlchemy 迁移:模型定义基本原样(SQLAlchemy 1.4 到 2.x 的类型写法升级是另一件事),变化在会话获取方式——从 db.session 的请求钩子托管换成依赖注入托管,事务边界语义不变。Alembic 迁移工具与框架无关,迁移文件与流程原样保留,这是"FastAPI 不绑 ORM"的红利:存储层的资产可以整体平移。
事务边界进阶:一个请求多个提交的场景
"一个请求一个事务"是默认语义,但有些场景需要打破它——最典型的是"写日志不能随业务回滚"。审计日志、消息已发送记录这类动作,业务失败也必须留下痕迹。解法是第二个会话来源:
def get_audit_session(): session = SessionLocal() try: yield session session.commit() finally: session.close() @app.post("/transfers") def transfer(payload: TransferReq, session=Depends(get_session), audit=Depends(get_audit_session)): audit.add(AuditLog(action="transfer_attempt", detail=payload.model_dump())) audit.commit() # 先落审计:无论后续成败,痕迹已在 execute_transfer(session, payload) # 业务事务:失败整体回滚
两个依赖、两个会话、两个独立事务——审计在业务事务提交前先行落库,业务回滚不影响审计记录。对照在 Flask 里实现同样语义(手动开第二个连接加事务,或钩子里补救),依赖版本的事务边界全部显式声明在签名里,review 时一眼看清"这个接口有两个持久化通道"。
这个模式的边界也要知道:跨两个会话没有分布式事务,审计成功、业务提交失败的瞬间存在不一致窗口(审计说尝试过、业务说没发生)——对审计语义这恰好是正确的(记录的是尝试),但若换成"必须同生共死"的双写需求,正确解法是单事务加 Outbox 模式(业务表与待发表同事务写入,发送由后台任务保证),那是第 5 章任务队列与本章事务知识的组合应用。
常见问题速答
**问题:关联查询的 N 加一问题怎么发现和治?**症状:列表接口查一次、每行又触发一次关联查询,慢且查库次数暴涨。发现靠开发期的 SQL 回显日志或监控的查询计数。治疗是预加载(按外键一次取回关联集合)——注意异步引擎下惰性加载会直接报错(触发同步 IO),这反而逼你显式声明加载策略,是异步形态的意外红利。
**问题:多个数据库(读写分离、跨库)怎么接?**多套引擎加会话工厂,再写两个会话依赖变体,路由按需声明。读写分离的读库会话、写库会话分别挂载即可;真正的跨库原子操作要用两阶段提交或补偿模式,复杂度陡增,先确认业务真需要再上。
**问题:连接池的数字到底怎么定?**起点公式:池大小约等于单请求平均耗时乘目标每秒请求数再除以 worker 数,向上取整加余量——本质是并发中的平均等待数。再受两个硬约束:数据库最大连接数、单连接内存。上线后按池等待指标回调,没有一次算对的池,只有被观测修正过的池。
**问题:SQLite 能用于生产吗?**低并发单机场景(内部工具、边缘设备)可以,并发写是它的硬伤(写锁全库)。把它当开发与测试的默认库、小工具的生产库、并发服务的禁区来定位,三层用法就都清楚了。
本节要点回顾
- 标准架构:引擎与池在启动期创建,会话由 yield 依赖按请求分发,请求边界即事务边界(成功提交、异常回滚)。
- 两种形态同构:同步配 def 路由进线程池、异步配 async 路由上事件循环;同一路由内禁止混用两套会话。
- 容量联动:线程数、连接池、数据库最大连接三个数字一起规划,worker 扩容放大连接总量。
- pre_ping 必开:死连接剔除的代价远小于偶发的"连接已关闭"报错。
- 双轨模型:ORM 模型管存储、接口模型管契约,敏感字段靠分轨加 response_model 双重隔离;SQLModel 合一适合原型,成熟项目保双轨。
- 两个隐形坑:expire_on_commit 的隐性重查、池耗尽的静默卡死——监控与超时是解药。
延伸与边界
数据库集成的边界与延伸。边界一:本节的架构以关系型为轴,文档库(MongoDB 的 motor 驱动)与缓存(Redis 的异步客户端)接入方式不同但结构同构——引擎或客户端进程级创建、按请求的会话或连接由依赖分发、容量三算照旧,把本节的依赖骨架平移即可。边界二:事务边界的讨论止步于单库——跨服务的事务一致性(Saga、消息最终一致)是架构层课题,触发条件是"一个业务动作写多个存储",出现时先考虑能否收敛为单库加任务队列。
延伸方向两个:读写分离的路由化(依赖里按语句类型选主从库,注意"写后立读"的一致性陷阱——刚写完从主库、转头读从库可能读到旧值,需要会话级的路由粘性);查询性能的工程化(慢查询日志加执行计划审查进入例行事程,与第 7 章的容量观测合流)。数据库集成的学习曲线在 ORM 语法之外,真正的深水区永远是容量与一致性这两条。
补一条连接池实战的收尾经验:上线首周把池等待的观测打开(哪怕只是日志),你会看到教科书上没有的真实曲线——早高峰的排队尖刺、某个定时任务的规律性抬升、某次营销活动的溢出。这些曲线是容量参数调优的唯一可靠依据,而大多数团队的池参数从设置那天起再没动过,不是不需要调,是没有数据可依。观测先行一天,调优就有据可查——这条经验同样适用于第 7 章的一切容量话题。
- 会话即边界:事务的成败系于会话的生命周期管理——依赖的 yield 结构把边界钉在请求上,这是全链路中最值得默写的一段。