3.1 数组、切片与map:从内存到实践
3.1 数组、切片与 map:从内存到实践
本节摘要:数组是定长的值类型,切片是携带指针、长度、容量三元组的引用视图,map 是哈希实现的无序键值表。本节从内存布局讲清三者行为差异,覆盖 append 的扩容规则、切片共享底层数组的坑、map 的零值不可用与并发写致命错误,最后给出手工实现链表与二叉搜索树的要点。
上手前先明确
阅读完本节,你应当能够:
- 画出切片头三元组并解释 len 与 cap 的分工;
- 预测 append、切片再切片后原数据是否共享;
- 安全地删除切片元素与拷贝切片;
- 避开 map 的三大坑:零值、无序、并发写;
- 用结构体切片与 map 组合建模业务数据。
一、数组:被低估的值类型
var arr [5]int = [5]int{1, 2, 3, 4, 5} b := arr // 完整拷贝,5个int全复制一份 b[0] = 99 // arr不受影响
数组长度是类型的一部分:[3]int 与 [5]int 是两个不同类型,不能互相赋值。数组赋值与传参都是整块拷贝,这个"重"决定了日常代码几乎不直接用数组,而是用切片。数组的真正舞台是底层数据结构的存储单元(哈希桶、栈缓冲)与定长协议字段。
二、切片:三元组驱动的视图
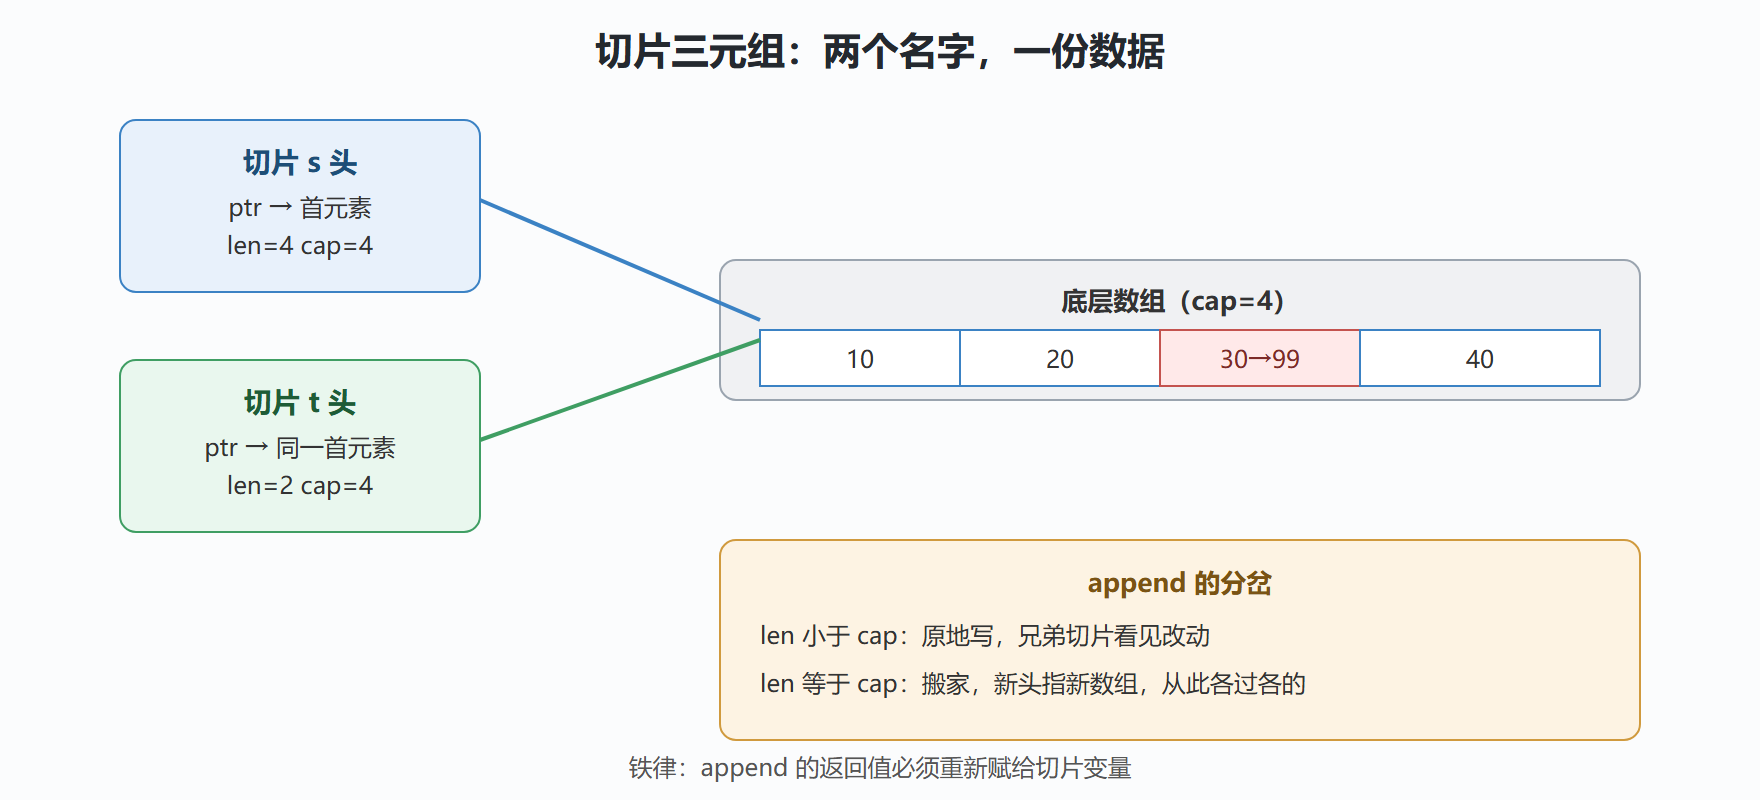
切片头是三个字:指向底层数组的指针、长度 len、容量 cap。理解了三元组,所有"灵异现象"都会消失:
s := []int{10, 20, 30, 40} t := s[:2] // 与s共享底层数组 t = append(t, 99) // len=2 < cap=4,原地写:s[2]变成99!
append 的规则一句话:cap 够用就原地写,不够就搬家。搬家时分配新数组、拷贝旧数据、返回新头——此时新旧切片分道扬镳,老切片还指着旧数组。所以"append 会不会影响原切片"的答案永远是"看 cap",而工程上正确的态度是"不依赖它":把 append 的返回值重新赋给同一变量是铁律。
s = append(s, 50) // 唯一正确写法
删除第 i 个元素的惯用法是两头拼接:
s = append(s[:i], s[i+1:]...)
拷贝用内建的 copy 函数,拷的是内容不是头。扩容策略经历版本演化,小容量翻倍、大容量按约 1.25 倍渐进增长,精确倍率是实现细节,不应写进业务假设——需要精确控制就自己 make 指定容量,预分配还能消灭反复搬家的性能损耗。
图:切片三元组与共享底层数组
三、map:哈希桶与三个禁区
m := map[string]int{"Alice": 30, "Bob": 25} m["Charlie"] = 35 age, ok := m["Bob"] // 双值取法,ok区分"零值"与"不存在"
map 内部是哈希桶数组,扩容时渐进式搬迁。由此推出三条铁律:
零值不可用。var m map[string]int 声明后 m 是 nil,向 nil map 写入直接 panic(读则安全返回零值)。必须 make 或字面量初始化。
无序。遍历顺序刻意随机化,连跑两次同一程序顺序都不同。要有序输出先把键收进切片排序。
并发写致命。多个 goroutine 同时写同一个 map 会触发运行时的致命错误(不可 recover 的崩溃),这是故意的"快速失败"设计。并发场景要么加锁(第 5 章 Mutex),要么用通道串行化写入,标准库还提供了并发安全的分片 map 实现(sync 包的 Map 类型)。
| 操作 | nil map | 正常 map |
|---|---|---|
| 读 | 返回零值,ok 为假 | 正常 |
| 写 | panic | 正常 |
| len | 0 | 正常 |
| 遍历 | 空循环 | 顺序随机 |
四、手工数据结构:链表与二叉搜索树
标准库的 container 包提供了现成的双链表与堆,但面试与底层理解都要求手写。单链表的节点定义与插入:
type Node struct { Val int Next *Node } func pushFront(head *Node, v int) *Node { return &Node{Val: v, Next: head} }
要点是"指针字段建链、返回新头"。二叉搜索树维持"左小右大"不变量,插入沿比较路径下行:
type TreeNode struct { Val int Left, Right *TreeNode } func insert(root *TreeNode, v int) *TreeNode { if root == nil { return &TreeNode{Val: v} } if v < root.Val { root.Left = insert(root.Left, v) } else { root.Right = insert(root.Right, v) } return root }
中序遍历有序输出,这是它叫"搜索树"的原因。堆则用于优先队列,标准库的 heap 接口要求实现五个方法,手工实现时用数组存完全二叉树、下标算父子关系。
五、性能与选型
| 结构 | 随机访问 | 插入删除 | 内存特征 | 适用 |
|---|---|---|---|---|
| 数组 | O(1) | 差(整体挪) | 连续紧凑 | 定长、协议、缓存友好 |
| 切片 | O(1) | 尾部均摊 O(1) | 头轻底层数组 | 通用序列 |
| map | 按键 O(1) 均摊 | O(1) 均摊 | 桶加溢出链 | 关联查找 |
| 链表 | O(n) | 已知位置 O(1) | 节点分散 | 频繁中段增删 |
| 二叉搜索树 | O(log n) 平衡时 | O(log n) | 节点分散 | 有序维护与范围查询 |
💡 关键直觉:90% 的业务代码只需要"切片加 map"组合——切片保序装列表,map 建索引做查找。其余结构等性能证明需要时再上。
六、容器决策与生命周期图
几个高频问答收尾。怎么判断两个切片相等? 不能直接 ==(会报编译错),逐元素比或用标准库的相等判断函数;map 同理。nil 切片和空切片有区别吗? 行为几乎一致(len 零、append 都可用),区别只在是否指向底层数组,JSON 编码时 nil 输出 null、空切片输出方括号——对外 API 要留意。map 的键能用什么类型? 可比较类型都行(数值、字符串、数组、结构体、接口),切片 map 函数不行——它们没有相等定义。大 map 怎么省内存? 值用指针(桶里只存指针)、预估规模 make 预分配、或拆分片降低单锁竞争。
本章回顾
- 数组是值类型,长度属于类型,赋值即整拷贝。
- 切片三元组:指针、len、cap;行为预测全部由此推导。
- append 二分岔:cap 内原地写共享可见,cap 满搬家分家。
- 删除惯用法:两头拼接;拷贝用 copy 拷内容。
- map 三坑:nil 写崩溃、遍历无序、并发写致命错误。
- 预分配容量:能预估规模时 make 指定,省搬家开销。
- 手工结构:链表靠指针字段,搜索树靠左小右大不变量。
下一节讲"指向"本身:指针。