2.4 执行计划与性能优化:慢查询的病理切片
2.4 执行计划与性能优化:慢查询的病理切片
本节摘要:性能巡检的标准流程是读 explain 计划、对齐 Spark UI 的 Stage 指标、定位病灶再动手。本节拆解计划中值得盯的五类信号,给出数据倾斜的两级治理方案(加盐打散与广播绕行),并附参数速查表。
先会读,再会谈优化
物理计划是一棵倒挂的算子树,数据从叶(Scan)流向根(输出)。巡检五个信号:
- Exchange 节点:每个 Exchange 一次 Shuffle。数一数 Exchange 数量,就知道数据被搬运几趟。
- Join 策略:
BroadcastHashJoin无 Shuffle;SortMergeJoin需要两边排序加 Shuffle。大表边出现 Broadcast 是统计信息误导,常是灾难。 - Scan 层的 PushedFilters 与 ReadSchema:过滤和列裁剪有没有真正抵达数据源。
- 分区数:Exchange 后默认分区数由 Shuffle 并行度参数控制,小数据量配大分区数等于满天星星般的空任务。
- 排序堆积:多个相邻 Sort 往往能通过窗口对齐或 Join 顺序调整消掉。
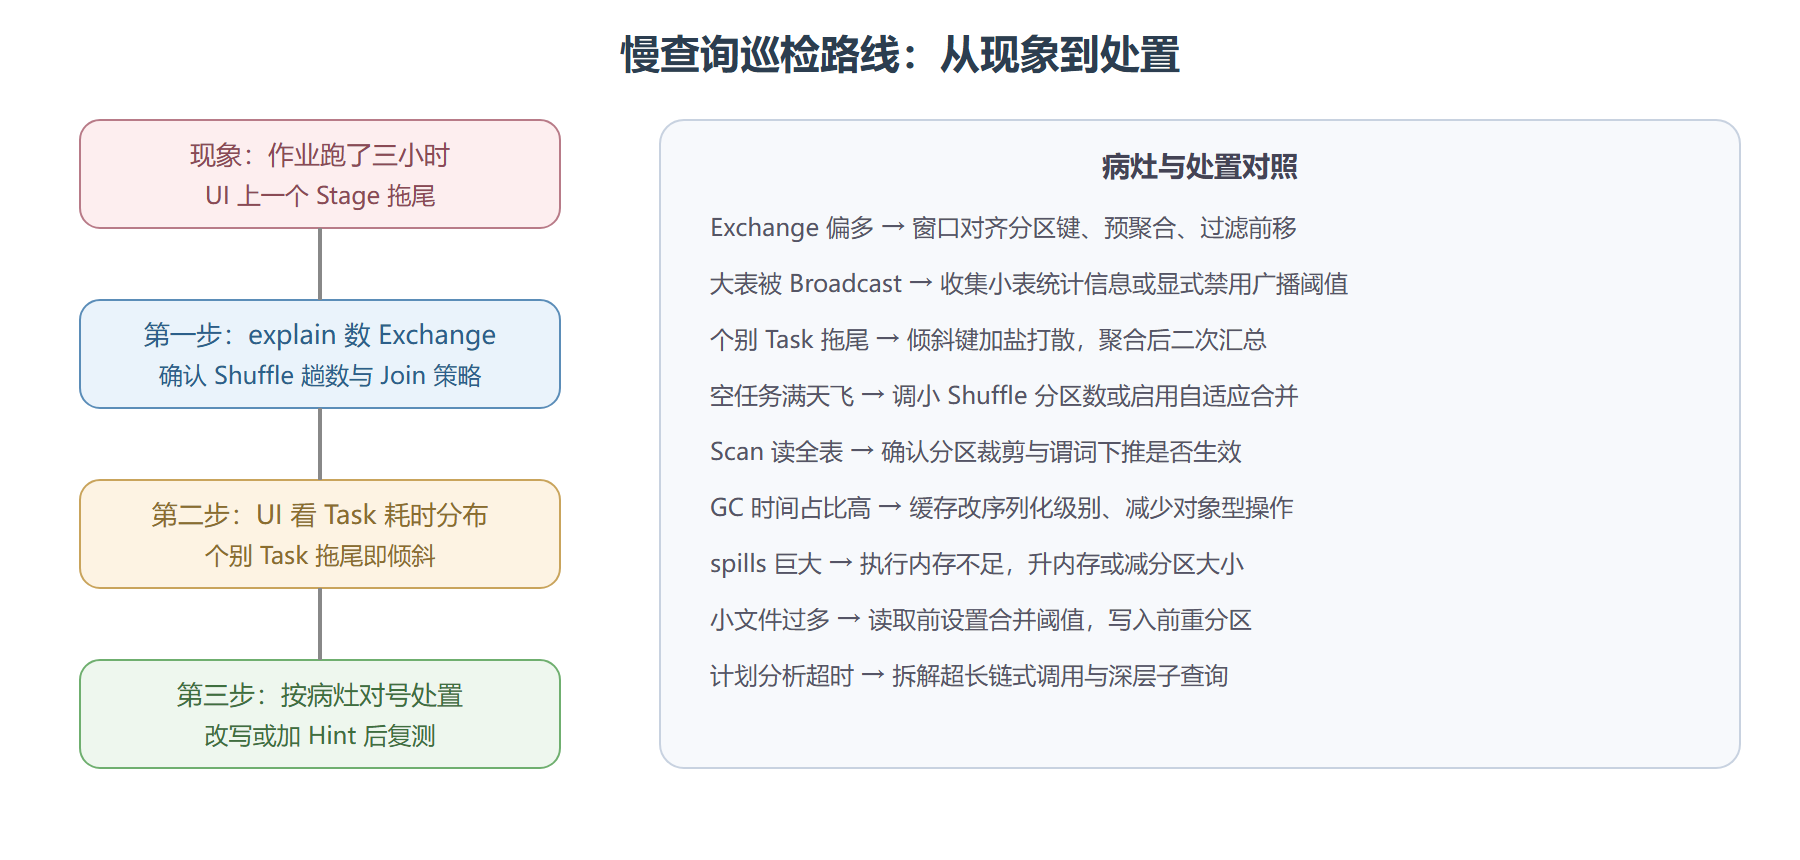
慢查询诊断路线图
数据倾斜的两级治理
倾斜是分布式引擎的第一大病:某个键的记录量碾压其余键,对应 Task 独扛绝大部分数据,整个 Stage 等它一个。
一级:加盐打散。 把热点键拆成 N 份分别聚合,再按随机前缀二次聚合:
import pyspark.sql.functions as F salted = (orders.withColumn("salt", (F.rand() * 10).cast("int")) .withColumn("k", F.concat_ws("#", "user_id", "salt"))) step1 = salted.groupBy("k").agg(F.sum("amount").alias("s")) step2 = (step1.withColumn("user_id", F.split("k", "#")[0]) .groupBy("user_id").agg(F.sum("s").alias("total")))
热点键被摊到 10 个分区各自聚合,二次汇总只需处理小结果。代价是多一轮轻量 Shuffle。
二级:广播绕行。 倾斜发生在 Join 且一侧可装入内存时,干脆不让它走 Shuffle:
small = spark.table("users_dim") hinted = orders.join(F.broadcast(small), "user_id") # 小表复制到各 Executor,本地 Join
自适应与参数速查
启用自适应查询执行后,引擎在运行中合并小分区、切换 Join 策略、处理倾斜,相当一部分手工优化被自动化:
spark.conf.set("spark.sql.adaptive.enabled", "true") spark.conf.set("spark.sql.adaptive.skewJoin.enabled", "true")
| 参数 | 作用 | 巡检含义 |
|---|---|---|
| shuffle 分区数 | 控制 Exchange 后并行度 | 空任务多则调小,CPU 吃不满则调大 |
| 广播阈值 | 自动广播的最大表体积 | 误广播大表时收紧此值 |
| 自适应开关 | 运行期重规划 | 新版默认开启,老作业需确认 |
| 倾斜 Join 处理 | 自动拆分倾斜分区 | 与手工加盐二选一即可 |
⚠️ 常见坑:不看计划先调参。分区数、广播阈值这些旋钮只对已确诊的病灶有效,盲目拧只会把问题从一处搬到另一处。
诊断心法:从症状反推病灶
巡检慢查询时按症状归类,能少走弯路。症状一:某个 Stage 的 Task 条形图一根长尾、其余分钟级完成——典型倾斜,先做热点键计数再选加盐或广播。症状二:所有 Task 均匀但整体慢——不是倾斜,先查 Exchange 的输入量,多一半是少写了过滤或选多了列,让引擎搬了不该搬的数据。症状三:Task 数上千、每个几秒——分区过碎,调小 Shuffle 分区数或开自适应合并。症状四:作业大部分时间在 GC——内存账问题,参数在此章无解,去第 6 章算内存配比。四类症状对应四个不同层面的处方,混着猜是性能优化最贵的习惯。
另外记住手工与自动的边界:自适应查询执行能兜住分区碎、Join 策略误判、常规倾斜三类问题,业务热点键加盐这种"要懂数据语义"的优化它做不了——机器看得到分布,看不懂业务。把自动化当默认,手工干预留给带业务判断的疑难杂症,这是 SQL 调优的分工底线。
四类症状还有个共同的加速器:把诊断步骤固化成脚本。热点键计数、Exchange 汇总、Task 分位数提取,三段代码各十几行,接到作业号就能出报告。手工巡检半小时的活儿压缩到十秒,更重要的是报告格式统一,跨团队比对故障样本时才不会各说各话——巡检工具沉淀的速度,几乎决定了团队排障能力的上限。
再压一条经验法则收尾:一次只改一个变量。诊断阶段可以并发地看各种指标,处置阶段必须串行验证——同时调分区数、换缓存级别、改 Join 提示,指标好转也说不清是哪一刀见效,恶化更无从回退。把"改一处、复跑、记录、再改下一处"做成团队纪律,慢是慢了点,但每一步都留下可复用的因果证据,长期看比"组合拳"快得多。本章至此,SQL 侧的巡检工具箱齐了;带着这套读计划的习惯进第 3 章,你会发现流作业不过是同一份计划按时间片反复执行。带着问题跨章,比按页码顺序读收获密度高得多。最后提醒:性能优化没有终点,设好基线、管住变更,比追求极限更接近工程本质。与诸君共勉,下一章见。
本节要点回顾
- 诊断三步:explain 数信号 → UI 看 Task 分布 → 按病灶对号处置
- Exchange 是账单:Shuffle 趟数直接决定数据搬运成本
- 倾斜两级:加盐打散治聚合,广播绕行治 Join
- 自适应兜底:运行期重规划覆盖多数常规优化,手工干预留给疑难杂症