3.1 微批执行模型:把河流切成湖
3.1 微批执行模型:把河流切成湖
本节摘要:Spark Streaming 的核心是微批——接收器把持续到达的数据按批次间隔切成离散数据块,定时器每到点就把这批数据包装成 RDD,作为一个小批作业提交给标准批引擎执行。本节巡检这条转换链路的每一站,量化"实时"的真实延迟构成,并说明 DStream 在引擎里的真实身份。
接收、切片、触发:三站巡检
数据从进入集群到被处理完,经过三站:
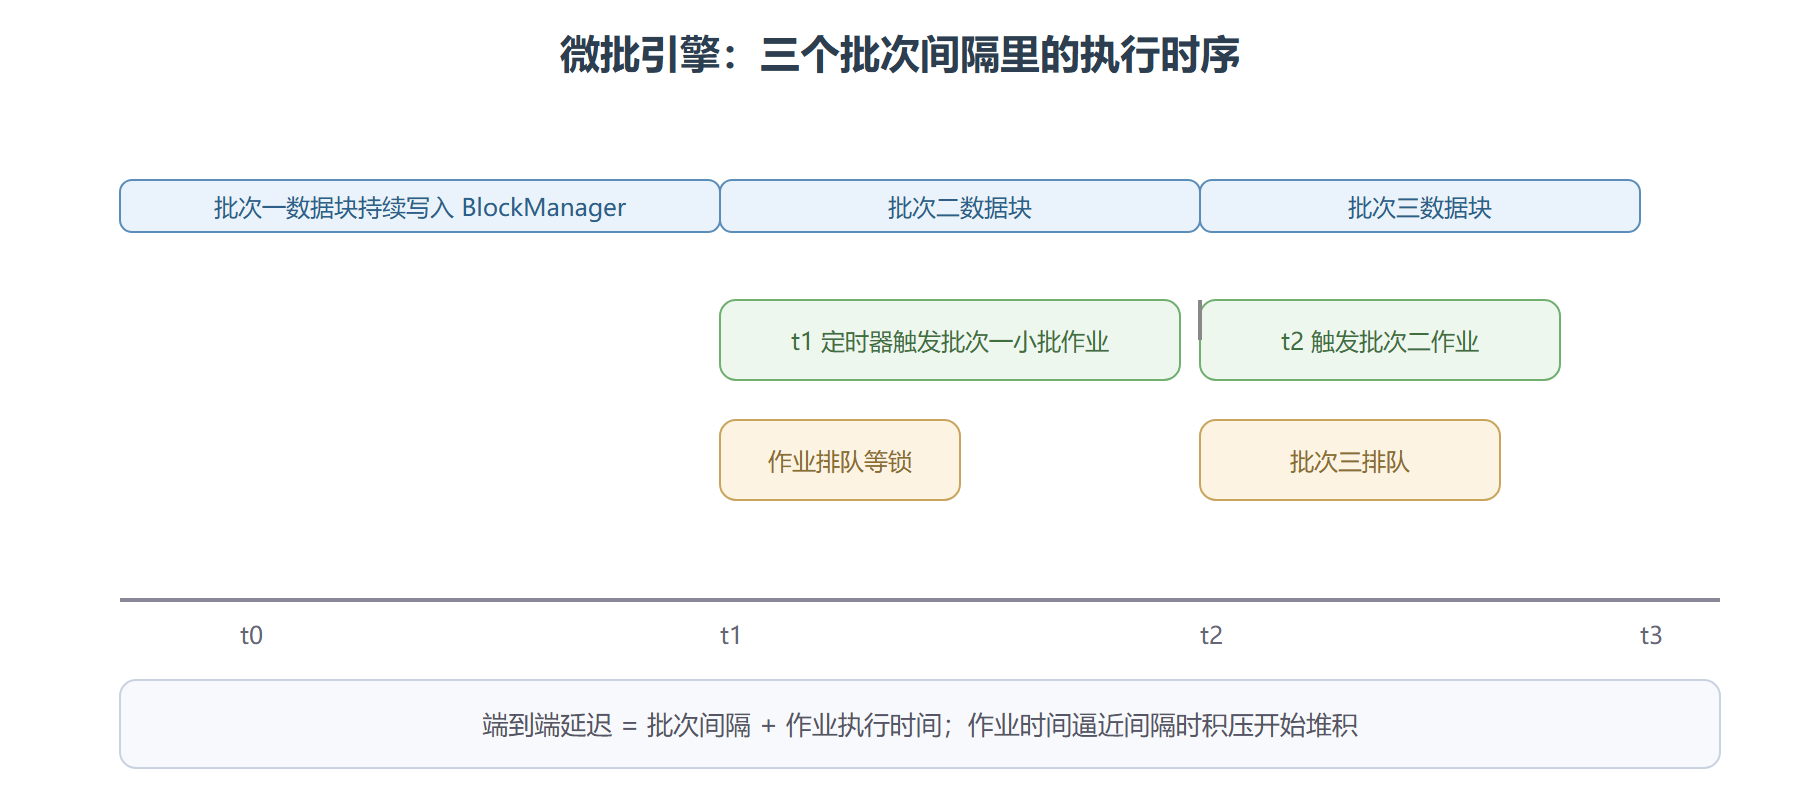
第一站:接收器。 Receiver 是常驻在 Executor 上的长任务,占用一个核心,持续从源(消息队列、Socket、日志采集器)拉数据,按块间隔(默认与批次间隔联动)切成数据块,写入 BlockManager 并向 Driver 里的接收器追踪器汇报元数据。
第二站:切片成批。 Driver 的作业生成器每到批次间隔时刻,把这个窗口内收到的所有数据块打包成一个批次,逻辑上就是一个 RDD——分区块即分区。
第三站:定时触发。 生成的 RDD 交给与批处理完全相同的调度链路:DAGScheduler 切 Stage、TaskScheduler 派 Task、Executor 执行。上一个批没跑完,下一个批只能排队——积压由此产生。
微批流水线时序
用最小程序感受批次节奏
from pyspark import SparkContext from pyspark.streaming import StreamingContext sc = SparkContext(master="local[2]", appName="MicroBatch") ssc = StreamingContext(sc, 5) # 批次间隔 5 秒 lines = ssc.socketTextStream("localhost", 9999) # 接收器:占一个核心常驻拉取 counts = (lines.flatMap(lambda line: line.split()) .map(lambda word: (word, 1)) .reduceByKey(lambda a, b: a + b)) counts.pprint() # 每批次打印一次本批结果 ssc.start() ssc.awaitTermination()
启动后对着 UI 看:每 5 秒冒出一个新作业,每个作业的 Stage 结构与手写 RDD 词频完全一致。local[2] 是最低配置——一个核心养接收器,一个核心跑作业,少一个就死锁。
DStream 的真实身份
DStream(离散化流)在引擎里不是数据结构,而是"RDD 的时间序列生成器":你写下的每个 DStream 算子,都被翻译成"对每个批次的 RDD 施加同样的转换"。所以第 1 章全部知识直接生效——血统、Stage、Shuffle、缓存,一个不少。流计算与批计算在执行层是同一种东西,这是 Spark 引擎统一性最直接的体现。
⚠️ 常见坑:把批次间隔调到几百毫秒去追"低延迟"。作业调度本身有开销,间隔逼近开销时吞吐崩塌、积压滚雪球。微批模型的舒适区在秒级;真要毫秒级延迟,那不是这台引擎的赛道。
# 配套的数据源终端:模拟持续到达的事件流 # nc -lk 9999 # 然后每隔一两秒敲几个词:hello spark hello streaming # 另一个窗口盯 UI:作业列表每 5 秒新增一条,DAG 拓扑逐字相同 # 连续观察三个作业后你会确信:这就是同一份图纸的反复展开
与常驻流水线模型的对照
把微批和逐条处理的真流水线摆在一起,差异立刻显形。延迟上,微批的地板是批次间隔加调度开销,秒级是舒适区;真流水线逐条通过,毫秒级可期。吞吐上,微批每批摊薄了调度与任务启动成本,大批量下反而占优;真流水线的单条开销护不住超高吞吐。语义上,微批天然"批"粒度——一次失败重放一个批次,事务边界清晰;真流水线的每条消息各自负责,幂等设计更琐碎。选型时先问延迟硬指标:秒级可接受,微批的工程成熟度与容错体系几乎是白送的;非要毫秒级,换引擎比调参诚实。
这个对照也解释了为什么 Structured Streaming 后来提供连续处理模式——在同一套 API 皮下面把微批内核换成轻量流水线的尝试,侧面印证了两种模型的边界是真实存在的,不是宣传话术。
微批还有一个常被低估的工程红利:可回放性。每个批次是一个独立作业,输入是按时间切好的数据块,出了问题可以单独重跑某个时间窗,与批处理世界的对账工具完全兼容。真流水线里"重放昨天的第 37 秒"要精细到位移级,微批里就是"重跑那个批次"——粗,但好用。做数据质量兜底时这种粗粒度回放往往比精细化重放更可靠,粒度越粗,一致性边界越好画。
把本节的三站链路再串成一句值班口诀:接收器管进水、定时器管开工、批引擎管干活。出问题时依次反问——水位涨没涨(接收器堵了)、作业按时开了没(定时器与调度)、开了跑多久(批引擎负载)。三个问题把"流作业为什么慢"切成三个互斥的检修区,比盯着一片滚动的日志逐行找答案高效得多。这个三分法也是后续三节的骨架:下一节先看图纸怎么画(算子模板),再看跨批记忆(窗口状态),最后看稳定阀(容错与背压)。
新手常问的"第一个流作业该跑什么",答案是小词频:一个 socket 源、一条计数链、一个 pprint 输出,二十行代码把三站链路全部点亮。跑起来后故意做两个破坏实验——停掉数据源看接收器行为、把批次间隔调到一秒看调度开销占比——比读十页文档更能建立对微批的时间感。本节的实验代码就是为此准备的,别只看,跑一遍。跑完记得停掉再退出——流作业不主动停会一直占着核心,这是新手第二天发现笔记本发烫的头号原因。实验虽小,责任心的培养从第一行流代码就开始了。祝第一个流作业顺利跑通。
本节要点回顾
- 三站链路:接收器切数据块,作业生成器打包成 RDD,定时器触发小批作业
- 延迟构成:批次间隔加作业执行时间,间隔是架构地板
- DStream 即模板:流算子展开为逐批次的 RDD 转换,批引擎照常调度
- 核心预算:接收器与作业抢同一批核心,规划并行度时必须分开记账