3.3 窗口与状态管理:跨批次的记忆
3.3 窗口与状态管理:跨批次的记忆
本节摘要:无状态转换每批清零,窗口与状态操作让引擎记住历史。窗口把多个相邻批次拼成一个"跨批次 RDD"再计算;状态算子则维护一张随批次更新的键值登记表。本节拆解滑动窗口的执行代价、两种状态 API 的取舍,以及状态生存期的控制。
窗口:把几个批次钉在一起
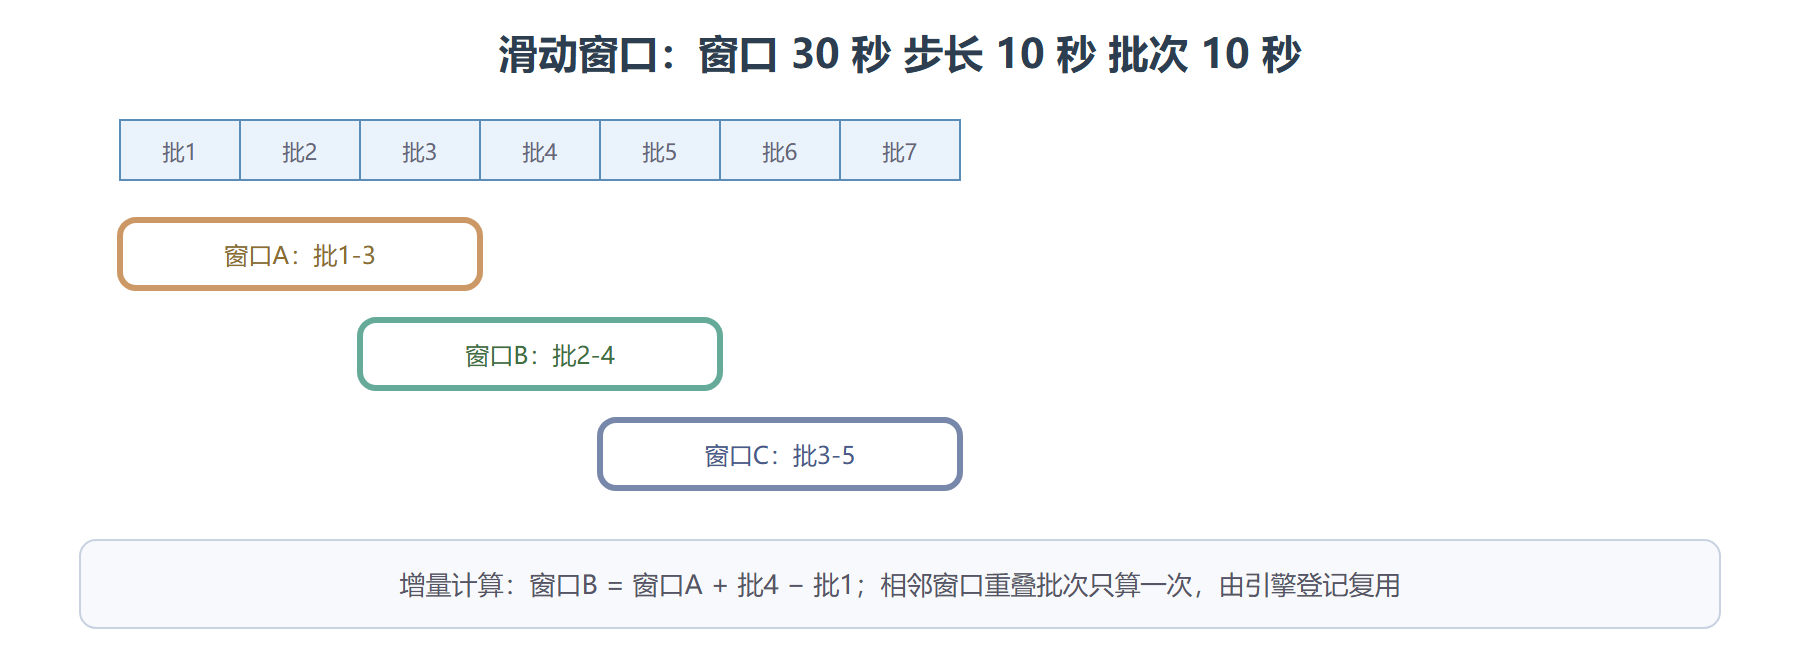
窗口由两个参数定义:窗口长度(覆盖多少时间)与滑动步长(隔多久算一次)。二者的公约数必须等于批次间隔——引擎按批次切数据块,拼不出更细的窗口。
from pyspark.streaming import StreamingContext ssc = StreamingContext(sc, 2) words = ssc.socketTextStream("localhost", 9999).flatMap(lambda l: l.split()) # 每 2 秒滑动一次,统计最近 30 秒:拼 15 个批次为一个虚拟 RDD windowed = words.countByWindow(windowDuration=30, slideDuration=2) windowed.pprint() # 带键版本:先本批聚合,再跨批求和 pair = words.map(lambda w: (w, 1)) reduced = pair.reduceByWindow(lambda a, b: a + b, lambda a, b: a - b, 30, 2)
第二段是引擎的精巧之处:reduceByWindow 的增量形式传入"加函数"与"减函数",新窗口结果 = 旧窗口结果 + 进入窗口的批次 − 离开窗口的批次。代价从"每次重算 15 个批次"降到"加减两头的增量"。普通 window().reduceByKey() 是傻算版,两者在 UI 上的作业耗时能差一个量级。
窗口与滑动步长的空间关系
状态:一张随批次滚动的登记表
窗口解决"最近 N 个单位时间",状态解决"从开播到现在"。两种 API 对应两代设计:
updateStateByKey——整表重写式。 每个批次把新数据与旧状态全量合并,状态表整体重算再存回:
def update(new_values, running): return (running or 0) + sum(new_values) running_counts = pair.updateStateByKey(update) # 状态随批次无限累积
mapWithState——增量维护式。 只有出现新数据的键被处理,其余键原样保留,可设超时自动清除:
from pyspark.streaming.state import StateSpec, RDD def track(key, value, state): total = (state.get() or 0) + (value or 0) state.update(total) return (key, total) session_sums = pair.mapWithState( StateSpec.function(track).timeout(3600)) # 1 小时无更新即清除
| 维度 | updateStateByKey | mapWithState |
|---|---|---|
| 每批开销 | 全状态表参与 | 仅活跃键 |
| 超时清除 | 无内建支持 | 原生支持 |
| 输出形态 | 完整状态表 | 只输出活跃键 |
| 适用 | 状态键少的小场景 | 生产主力 |
状态存放在内存加检查点里。状态表涨到千万键级别,每批全量合并的 updateStateByKey 会把批次间隔吃穿——这不是调参问题,是选错工具。
⚠️ 常见坑:状态无界增长。用户会话、设备指纹这类天然累积的键,必须配超时或定期归档,否则内存与检查点体积一起失控,重启恢复时间也随之恶化。
选型问答两则
滑动窗口步长怎么定,重叠会不会白算
步长的选择本质是"结果要多新鲜"与"批次数要不要翻倍"的交换。窗口长度 60 秒、步长 10 秒,同一秒的数据会进入 6 个窗口——引擎为每个"窗口起点对齐的批次组"各维护一份聚合,重叠部分靠登记复用不是白算,但状态存储与每批合并量确实按窗口数放大。步长压到批次间隔一倍时状态最省,代价是结果刷新变粗;高频需求下建议改用带 Watermark 的会话化思路而不是硬压步长。
状态该全量存内存还是依赖检查点
两者不是二选一而是分工:内存承担每批读写,检查点承担持久化恢复。真正的决策点是状态规模——活跃键在百万级以内,默认配置足以;逼近千万级时每批合并与序列化开销开始吃掉批次间隔,此时要么给状态瘦身(更短超时、更小的值结构),要么把大状态迁到外部存储,只留轻量聚合在引擎内。判断依据始终是那条老曲线:批次耗时对批次间隔的比值,状态造成的恶化它会第一个报警。
窗口与批次间隔对不齐会怎样
参数校验会直接拒绝启动——窗口长度与步长必须是批次间隔的整数倍,这不是建议而是硬约束。原因在执行层:微批按批次间隔生成 RDD,窗口聚合要把若干个批次的数据块拼在一起,除不尽意味着某些窗口没有对齐的批次组可拼,引擎无从登记复用。所以调整批次间隔时,全作业的窗口参数都要联动复查,只改一处会在下次重启时收到校验错误,幸好错误信息相当直白。
一句话总结本节的设计哲学:窗口与状态都是"把时间写进数据结构"的手段——窗口给记录盖上虚拟的时间戳分组,状态给键记上跨批次的账本。理解了这一点,选择哪个 API 只是语法问题;反过来只会调 API 而没有时间账本的意识,写出的流作业迟早栽在状态失控或窗口错位上。下一节的容错三件套,本质上也是给这本时间账上的保险。账本记清楚了,保险条款才读得懂。这也是流处理学习曲线里最陡的一段,翻过去后面都是顺坡。坚持住,快到山脊了。
本节要点回顾
- 窗口三参数:长度、步长须为批次间隔整数倍,重叠批次引擎登记复用
- 增量窗口:加减函数版本把窗口计算从重算降为增量
- 状态两级:整表重写式简单但贵,增量维护式是生产标配
- 状态要设生存期:无界状态表是流作业最常见的慢性病