4.1 MLlib与分布式学习:迭代落在内存里
4.1 MLlib 与分布式学习:迭代落在内存里
本节摘要:MLlib 是建在 Spark 引擎上的分布式机器学习库。它存在的理由正是引擎的舒适区:迭代计算对同一数据集反复扫描,缓存机制让每轮迭代的输入直接来自内存而非磁盘。本节巡检一轮参数更新的完整执行路径,量化缓存的效果,并交代基于 DataFrame 的新版 API 形态。
一轮迭代在引擎里的旅行
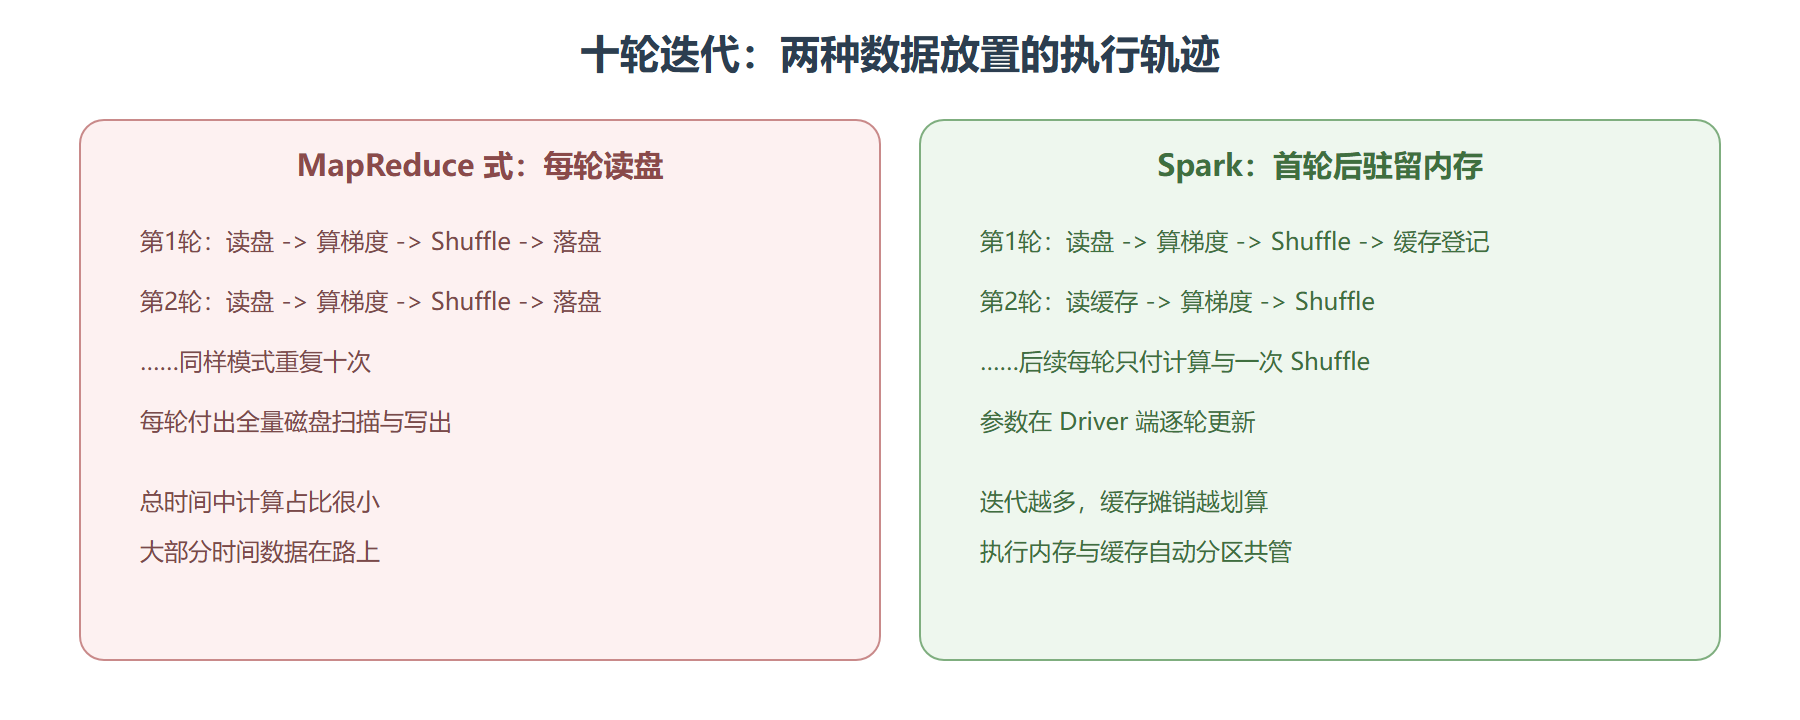
以最简单的逻辑回归为例,每轮迭代做三件事:算梯度、累加梯度、更新参数。映射到引擎:梯度计算是逐分区的 map(窄依赖),跨分区累加是一次 reduce(宽依赖,一次 Shuffle),参数更新在 Driver 端完成。下一轮迭代,输入还是那份训练数据——缓存命中,直接开跑。
from pyspark.sql import SparkSession from pyspark.ml.classification import LogisticRegression spark = SparkSession.builder.appName("MlIntro").master("local[*]").getOrCreate() training = spark.read.parquet("train_features") # 特征化后的训练集 lr = LogisticRegression(maxIter=50, regParam=0.01) # 50 轮迭代 = 50 次小批作业链 model = lr.fit(training) # 不缓存直接训
现在加上一行,重训一次:
cached = training.cache() model2 = lr.fit(cached) # 首轮后数据驻留内存
在 UI 的 Storage 页能看到这份缓存,以及每个后续迭代的任务从"读分区"变成"读缓存块"。数据量到 GB 级时,两版的总训练时间可以差数倍——差的正是每轮迭代省下的磁盘扫描。
磁盘迭代与内存迭代的执行对比
基于 DataFrame 的新 API
MLlib 分两代:基于 RDD 的旧 API 已进维护期;基于 DataFrame 的新 API 是现在的正统。新 API 的每个算法都是"吃特征列、吐预测列"的转换组件,因此能被 Catalyst 优化、能进 Pipeline 拼接、能享受 Tungsten 紧凑格式。巡检旧代码时见到 mllib 包名(RDD 系)与 ml 包名(DataFrame 系)要能分清:前者只是历史,新作业一律走后者。
| 维度 | 旧 RDD API | 新 DataFrame API |
|---|---|---|
| 数据入口 | RDD 向量 | DataFrame 特征列 |
| Catalyst 优化 | 不参与 | 全程参与 |
| Pipeline | 无 | 原生支持 |
| 维护状态 | 仅修缺陷 | 持续演进 |
⚠️ 常见坑:忘缓存就 fit。默认的 MEMORY_ONLY 级别放不下时会静默退化为"部分分区反复重算",训练时间莫名其妙地长。大数据集改 MEMORY_AND_DISK,把"退化为重算"改成"退化为读盘",行为可预期得多。
缓存效果的验证与解读
缓存的价值不该靠信仰,应当场验证。方法很简单:先跑一次不缓存的 fit 记录总时长,再缓存后重跑,对比 UI 里两版作业的输入读取来源——不缓存版每轮迭代都出现读分区的 IO 阶段,缓存版从第二轮起这一段消失。差值就是缓存的净收益,通常随迭代轮数线性放大:五十轮迭代省五十次扫描,数据集越大、轮数越多,这笔账越惊人。
解读时还要看两条曲线的 GC 时间:序列化缓存(MEMORY_ONLY_SER)用解压 CPU 换内存占用,若缓存后 GC 时间明显下降而总时长持平甚至更好,说明换对了。反之数据本来紧凑、缓存后又触发频繁垃圾回收,就退回默认级别——缓存级别没有万能答案,UI 上两条曲线才是裁判。
分布式训练还有一笔账单要交代:参数同步。每轮迭代里各 Executor 的局部梯度要汇到 Driver 求和再广播回全体,梯度向量的维度乘以 Executor 数就是每轮的通信量。特征维度上十万时这笔账开始显眼,好在梯度是小对象,广播路径成熟,多数场景不构成瓶颈——真正的雷区在特征维数爆炸时连梯度本身都算不动。遇到"加机器反而更慢"的训练,先查同步等待:某个慢 Executor 拖住每轮的归约,全体陪跑,这本质是第 2 章倾斜问题在训练侧的化身。
学习率与迭代的收尾判断也归引擎观察管:训练日志里每轮的损失值单调下降后趋于平坦,就是停手的信号——maxIter 设得过大,后面的轮次纯粹在为缓存读取与梯度同步付账,模型却不再变好。MLlib 的部分算法支持在验证集损失不再改善时提前停止,把它打开等价于给迭代上了自动刹车,比事后对着曲线拍轮数体面得多。训练的"够用就好",在分布式语境下每次都真金白银。
收束成一份训练前的检查单:输入已缓存、级别适配体积、迭代数有依据、提前停止已启用、验证集与训练集切分在 Pipeline 之外。五项各值一行代码或一个参数,合起来就是"训练作业不白烧集群"的全部前提。后面三节分别展开算法、特征与打包,都建立在这份账本之上。
再补一个量级感:同样的逻辑回归,单机库在千万样本内往往更快——分布式训练的价值要到数据装不进单机内存、或需要与数仓管道无缝衔接时才兑现。先问"数据真的大到要分布式吗",再谈算法选型,这个顺序能替团队省下不少集群开销。MLlib 的真正强项,是把训练嵌进数据处理主链路:特征在引擎里铸好、训练在同一会话完成、结果直接回流仓库,全程零数据搬运——单机库给不了这条流水线。认清这个定位,既不会高估也不会错怪这把分布式工具,选型时心态就稳了。带着这份清醒进下一节的算法库巡礼,各算法的优缺点才不会变成背诵题,而是执行形态的自然推论——这一点,是本章与普通算法教程最大的分野,也是巡检视角在机器学习领域最值钱的一处兑换。
本节要点回顾
- 舒适区对位:迭代学习反复扫同一数据,恰好命中缓存机制的甜点
- 一轮迭代账单:逐分区梯度是窄依赖,梯度归约一次 Shuffle,Driver 更新参数
- API 新旧之分:ml 包 DataFrame 系是新正统,mllib 包仅维护
- 缓存要显式:fit 不会自动缓存输入,级别按数据集规模选