4.3 特征工程:把原始字段铸成向量
4.3 特征工程:把原始字段铸成向量
本节摘要:特征工程把杂乱的原始列变换成算法可消费的特征向量列。MLlib 把每步变换封装为 Transformer,有的只需固定规则(无状态),有的要先扫描数据统计参数(需 fit)。本节巡检两类 Transformer 的执行差异,串联完整加工链,并检查特征质量。
两类 Transformer:要 fit 的和不要 fit 的
理解 MLlib 特征组件的关键一刀:要不要先看数据。
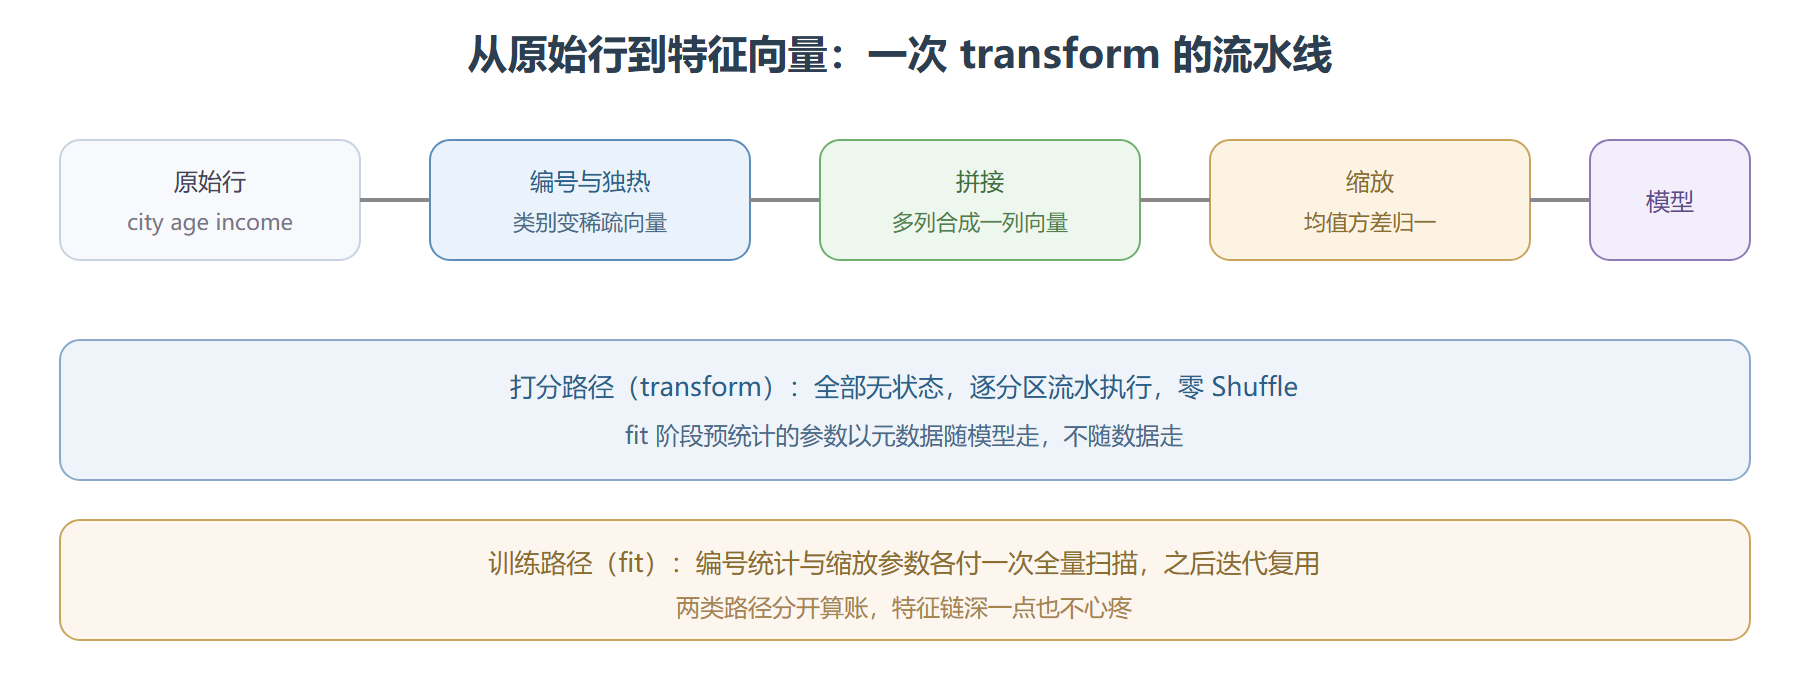
- 无状态 Transformer:直接 transform。如 Tokenizer 分词、一键多值的 OneHotEncoder 的编码应用阶段、VectorAssembler 拼向量。规则写死,每个分区独立执行,纯窄依赖。
- 有状态 Estimator:先 fit 再用。如 StandardScaler 要先统计均值方差、StringIndexer 要先数类别频次、 IDF 要先算文档频率。fit 阶段触发一次全量扫描与聚合,产出的参数装进 Model 后,transform 又变回窄依赖。
from pyspark.ml import Pipeline from pyspark.ml.feature import (StringIndexer, OneHotEncoder, VectorAssembler, StandardScaler) from pyspark.ml.classification import LogisticRegression # 有状态:先数每个类别出现多少次,决定编号 city_idx = StringIndexer(inputCol="city", outputCol="city_idx") # 无状态:按编号做独热展开 city_vec = OneHotEncoder(inputCol="city_idx", outputCol="city_vec") # 无状态:把各路特征拼成一列向量 assembler = VectorAssembler(inputCols=["city_vec", "age", "income"], outputCol="raw_features") # 有状态:先统计均值方差再缩放 scaler = StandardScaler(inputCol="raw_features", outputCol="features") lr = LogisticRegression(featuresCol="features", labelCol="churn")
引擎视角的执行账:整条链只在 fit 阶段(city_idx、scaler、lr 三处)付 Shuffle 或全量扫描;上线打分时全部退化为窄依赖流水线——这正是特征链可以放心做厚的底气。
特征加工链的数据形态流转
特征质量检查:别喂模型吃坏数据
from pyspark.sql import functions as F assembled = assembler.transform(sample_df) assembled.select("raw_features").summary("count").show() # 空向量与全空列检查:VectorAssembler 默认跳过空值,先补齐或剔除 nulls = sample_df.filter(F.col("income").isNull()).count() # 类别基数检查:city 编号超过几百个就该合并长尾 sample_df.groupBy("city").count().orderBy(F.desc("count")).show(20)
特征工程的三大质量坑都在这段代码的检查范围内:空值悄悄变成零向量、类别基数爆炸拖垮独热维度、训练与打分两套代码各写一份变换导致特征漂移。第三坑的根治方案就是下一节的 Pipeline——训练与打分共用同一条链。
⚠️ 常见坑:打分服务手工重写变换逻辑,与训练侧参数脱节。StringIndexer 的类别编号、Scaler 的均值方差都是 fit 出来的参数,脱离原 Pipeline 复刻,等于给模型喂了一套口径不同的特征。
特征质量巡检清单
上线前照单过一遍,比出事后反推省力得多。空值巡检:各类统计(均值、计数、独热维度)分别用 describe 与 null 计数扫一遍,空值在向量装配后会成为零或默认值,模型不会报错但会悄悄学进噪声。基数巡检:类别列去重计数超过阈值(经验值几百到几千),长尾合并成"其他"桶,否则独热维度失控、编号表膨胀。分布巡检:连续列的分位数快照留档,离线训练与线上打分各取一份对拍,漂移超过阈值即触发重训——第 4.4 节的案例会看到这条快照如何救命。泄漏巡检:任何用到了标签信息的变换(例如按转化率编码类别)必须在训练侧单独 fit 并冻结,否则评估指标虚高得离谱。
这份清单的巡检成本极低——每项都是一条 groupBy 或 describe 的事——但漏掉任何一项的修复成本都以天计。特征工程的质量纪律,说到底是"把检查做成例行公事"。
最后补一个取舍常被问到的点:特征该在引擎里做还是上游做。判断标准是"参数是否随数据漂移"——需要 fit 的变换(编号、缩放、统计编码)留在引擎侧随 Pipeline 走,保证口径统一;纯规则变换(时间戳拆解、字段拼接、单位换算)可以前移到上游表,给所有消费方复用。一刀切地把特征全塞进训练作业,或全推给上游,都会在某一侧积累口径债——分布式的世界里,口径就是货币。判据再重复一遍因为它最常被违反:参数随数据的留引擎,规则随代码的留上游。两者的边界划清后,下一节的 Pipeline 自然就是引擎侧那部分的打包容器。口径先于算法,是特征工作的第一性原则。## 本节要点回顾
- 一刀两断:要不要 fit,取决于变换参数是否来自数据统计
- 打分零 Shuffle:transform 路径全是无状态窄依赖,放心加厚特征链
- 参数随模型走:编号表、缩放参数序列化在 Model 里,不随数据重算
- 三坑必检:空值、类别基数、训练打分口径漂移