5.1 图数据模型:把关系降维成分区表
5.1 图数据模型:把关系降维成分区表
本节摘要:GraphX 用三张 RDD 表示一张图——顶点表、边表、路由表。边按源顶点分区,路由表记录每个顶点落在哪,三元组视图在这套结构上按需生成。本节拆开这套降维结构,看清每张表在 Executor 上的物理形态。
上一章结束时,特征向量还老老实实待在列里。本节把数据换成"关系",看引擎如何用最朴素的分表手段驯服图这种最难切分的数据——它承接着第 1 章的分区与 Shuffle 知识,是后两节一切图算子的地基。
关系数据为什么难切
行式数据的分区策略随便挑:哈希、轮转、范围,切完各分区老死不相往来。图不行。一条边的两个端点分属不同分区时,任何"沿边计算"都要搬运数据。切图的本质矛盾是:按点切,边跨分区;按边切,点的属性被复制多份。
GraphX 不试图解决这个 NP 难的图划分问题,而是选了一个工程上可执行的折中:边按源顶点哈希分区,点的属性允许在需要的分区里存副本。代价是顶点属性有冗余,收益是"从某点出发的所有边"天然聚在一个分区,出边方向的计算零搬运。
三张表:图的物理形态
建一张小图看引擎里发生了什么。
import org.apache.spark.graphx._ import org.apache.spark.rdd.RDD // 顶点:(顶点id, 属性)。属性这里放人名 val users: RDD[(VertexId, String)] = sc.parallelize( Seq((1L, "李工"), (2L, "王工"), (3L, "赵工"), (4L, "钱工"))) // 边:(源id, 目标id, 边属性)。属性这里放协作次数 val rels: RDD[Edge[Int]] = sc.parallelize( Seq(Edge(1L, 2L, 12), Edge(2L, 3L, 7), Edge(1L, 3L, 3), Edge(3L, 4L, 9))) // partitionedEdges 默认按源顶点做 2D 边分区 val graph = Graph(users, rels) graph.numEdges // 返回 4 graph.numVertices // 返回 4
提交后 Driver 拿到的是一个 Graph 对象,里面装着三张 RDD:
| 表 | 内容 | 分区依据 | 物理位置 |
|---|---|---|---|
| VertexRDD | 顶点id → 属性 | 哈希,带索引去重 | 各 Executor 内存 |
| EdgeRDD | 边三元组,按源点聚簇 | 源顶点哈希 | 各 Executor 内存 |
| routingTable | 顶点id → 出现在哪些边分区 | 极小的位图结构 | 跟随边分区缓存 |
路由表是这套设计里最容易被忽略的一块。它小到可以广播,却是后面 joinVertices 能"知道去哪个分区找点"的地图。没有它,每次点边对齐都要全局 Shuffle;有了它,引擎先查位图再定向搬运。
图降维到三张表的结构
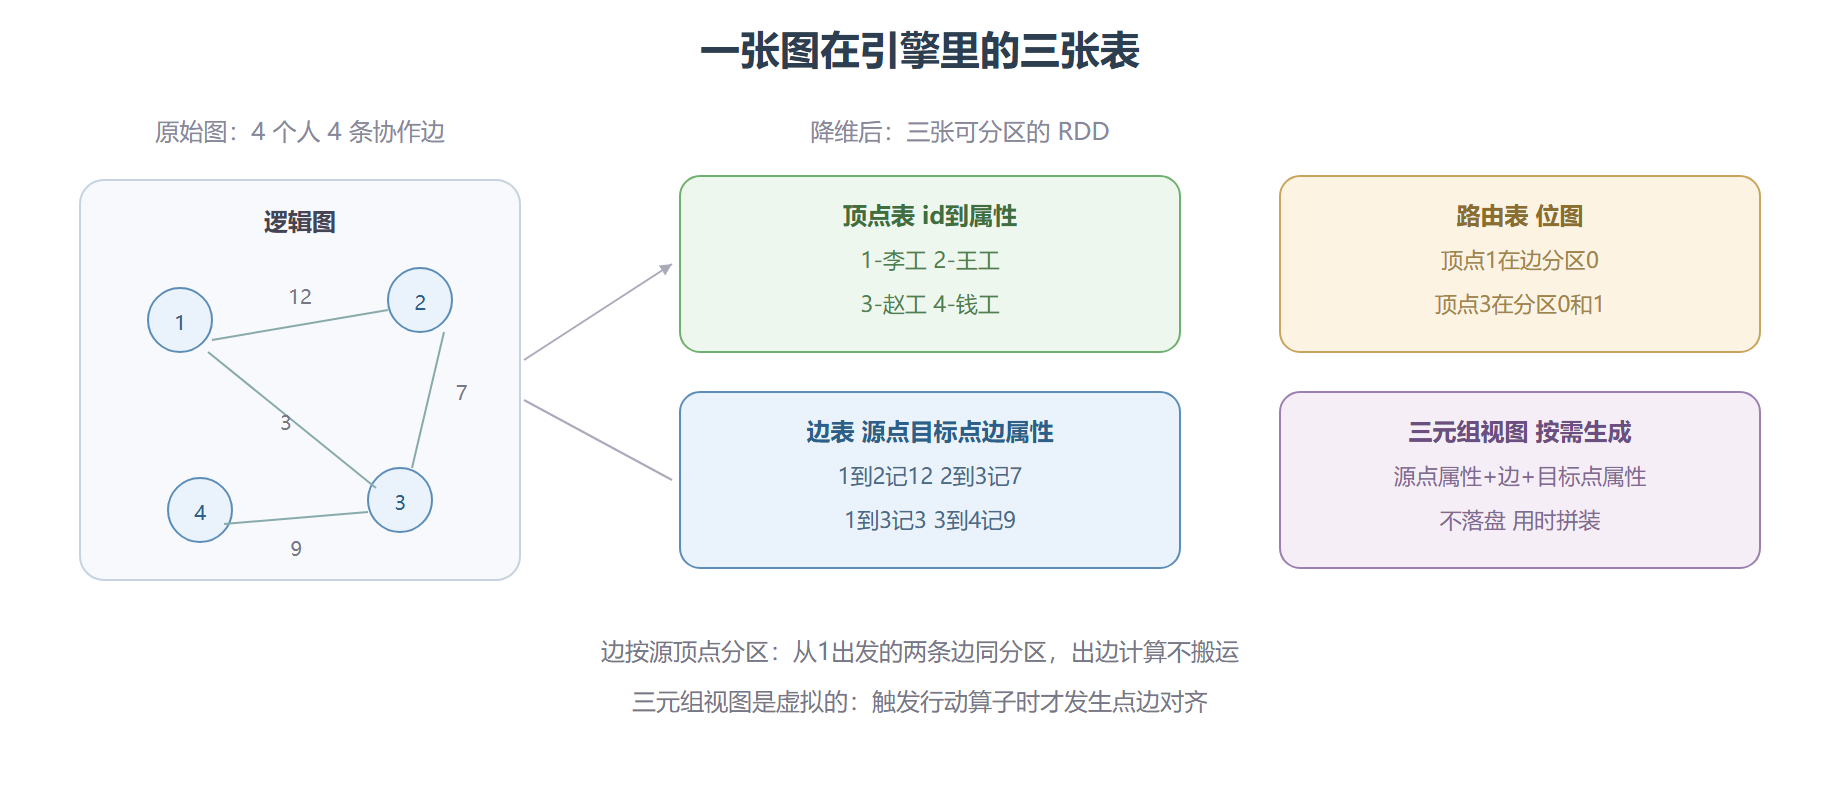
动手验证:三元组是按需生成的
// triplets 不触发计算,只是注册了一个"对齐计划" val tri = graph.triplets // 行动算子落地,此刻才发生点边对齐 tri.map(t => s"${t.srcAttr} 协作 ${t.dstAttr} ${t.attr} 次") .collect() .foreach(println) // 输出(顺序可能因分区而异): // 李工 协作 王工 12 次 // 王工 协作 赵工 7 次 // 李工 协作 赵工 3 次 // 赵工 协作 钱工 9 次
在 Spark UI 的 Storage 页签里,你找不到 triplets 的缓存条目——它是对齐计划的产物,不是实体表。这是 GraphX 省 内存的关键一手:能虚拟的绝不物化。
⚠️ 常见坑:反复使用 triplets 而不缓存底层图,每轮迭代都会重新对齐点边。图规模大时,先把 Graph 缓存(graph.cache)再进循环,否则每轮迭代都在为同一份搬运买单。
💡 关键直觉:把 GraphX 的图当成"两张带预分区约定的表 + 一张小地图",一切行为都能用第 1 章的 Shuffle 知识推出来,不需要新物理概念。
FAQ 一问:图这么大,顶点属性副本不会爆内存吗
会有冗余,但可控。副本只存在于"有以该点为源点的边"的分区里——一个顶点出度多大,最多被复制到多少个边分区,度数为零的孤点甚至不占副本。社交网络这类幂律图里,长尾用户的副本开销微不足道,真正的压力来自超高 hubs 节点:一个千万出度的顶点,其属性副本遍布大量分区。好在副本只是属性对象,不是边数据,体积通常远小于边表本身。若属性确实庞大(比如每个点挂着嵌入向量),惯例是把属性外置到广播变量或独立表,图里只留轻量 id,用 join 按需取回——结构与负载分离,是图数据建模的老经验。
顺带算一笔规模账给直觉:亿级边的图,边表每条记录几十字节,总量也就几个 GB,配上副本冗余仍在单集群内存的舒适范围内;真正顶不住的是"属性巨大且频繁更新"的图——副本一多,每次属性变更要同步的位置就多。所以建图前先问自己:顶点属性多久变一次?变化频繁的重属性图,GraphX 的副本设计会持续放大写入成本,此时应认真考虑把属性外置或换专用图存储,而不是硬扛。这份规模直觉同样适用于读侧:建图前对边表做一次按源点的计数聚合,几分钟就知道 hubs 的量级,比建完图跑第一轮迭代时才发现一个分区独大要体面得多。这份"建图前先数边"的习惯,与第 1 章建 RDD 前先想分区数是同一个动作——分布式世界的进门仪式。带着这份意识进下一节的算子层,搬运账单就不会看花眼。## 本节要点回顾
- 图难在切分:按点切边跨分区,按边切点被复制,GraphX 选边按源点分区做工程折中
- 三张表各司其职:顶点表存属性、边表存关系、路由表是定向搬运的地图
- 三元组是虚拟视图:只在行动算子触发时对齐生成,不占常驻内存
- 路由表小而关键:它让 join 类操作从全局 Shuffle 降级为定向复制
- 缓存习惯:迭代前缓存图本体,是图算法性能的第一道闸
下一节在这三张表之上组装算子:改顶点、改边、沿边发消息,每一种都对应不同的搬运账单。