5.3 内置图算法:逐轮拆解迭代账单
5.3 内置图算法:逐轮拆解迭代账单
本节摘要:GraphX 内置 PageRank、连通分量、三角计数等算法,全部构建在 aggregateMessages 之上。本节手工推演 PageRank 的权重流转,拆连通分量的收敛条件,并用三角计数收尾,给出一份"每轮迭代付什么账"的清单。
上一节的心脏(aggregateMessages)本节开始整跳动。判断能否读懂任何 GraphX 算法源码的标准很简单:能否说出它每轮迭代发出什么消息、怎么合并、何时停。
PageRank:权重沿边流动
import org.apache.spark.graphx.lib.PageRank // 静态版:固定跑 10 轮 val ranks = PageRank.run(graph, numIter = 10).vertices // 动态版:权重变化小于容差就停,轮数自适应 val ranksD = PageRank.runUntilConvergence(graph, tol = 0.01).vertices ranksD.collect().foreach(println)
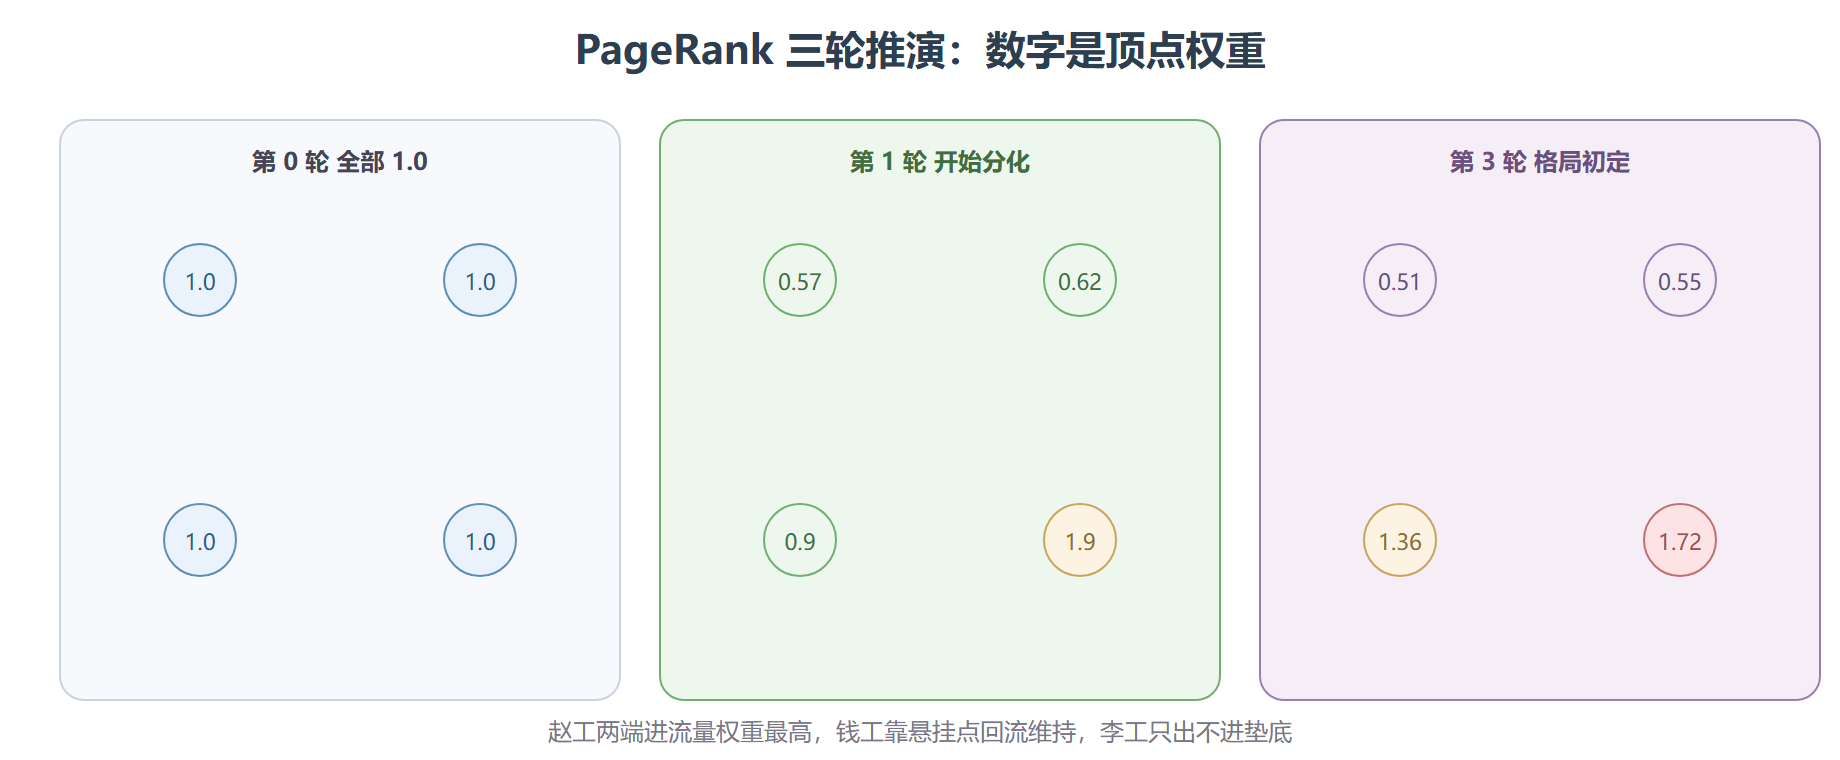
用上一节的 4 人协作图手工推 3 轮,每点初始权重 1.0。PageRank 的规则:每轮把自身权重的 0.85 均分给出边邻居,0.15 留在系统外,再统一补齐总量。第一轮后:李工发出 1.0 给两位邻居各 0.5;王工把 1.0 全给赵工;赵工把 1.0 给钱工;钱工无出边(悬挂点),权重按惯例回流均匀重分。三轮下来,赵工持续吸入两端流量,权重爬到约 1.7,钱工稳定在 1.4 上下,李工因只进不出逐渐滑落。
引擎账单:每轮一次 aggregateMessages(沿出边发权重)加一次补齐 join,10 轮迭代就是 10 次 Shuffle 边界的轮回。动态版的收益是轮数往往砍半以上——代价是每轮多算一次"最大变化量"的全量聚合,用来判断收敛。
权重流动的三轮视图
连通分量:取邻居最小号,迭代必收敛
import org.apache.spark.graphx.lib.ConnectedComponents val cc = ConnectedComponents.run(graph).vertices cc.collect().foreach(println) // (4,1) (2,1) (1,1) (3,1) // 4 个点全连通,分量号都归到最小顶点 id 1
算法思想朴素到极致:每个顶点初始把"自己见过的最小顶点号"设为自身 id,每轮沿边广播这个最小号,邻居取更小者更新自己。它收敛是有限轮的——每轮至少有一个分量的标签定型,最坏轮数受图的直径约束。生产上它常用来做"归一化":同一自然人的多个账号、同一设备的多次会话,靠一张关系图滚出一个集团 id。数亿顶点的图跑它,瓶颈几乎总在每轮 aggregateMessages 的消息重分区上,分区数调到与边分区对齐能省不少搬运。
三角计数:衡量社区的稠密度
import org.apache.spark.graphx.lib.TriangleCount val tc = TriangleCount.run(graph).vertices tc.collect().foreach(println) // 每个点的属性是"该点参与了几条三元环"
三角计数的前提是边方向规范化(每条无向边只留一个方向),引擎会先做一次 reverse 去重。它的产出常被除以总边数得到全局聚集系数,社交网络里这个数字直接反映"朋友的朋友也彼此是朋友"的强度。巡检经验:三角计数的中间消息里携带的是邻居 id 列表,高度数点会把消息撑得很大,遇到超 hubs 节点要小心单条消息超限。
三种算法的执行账单对照
| 算法 | 每轮消息内容 | 收敛依据 | 相对成本 |
|---|---|---|---|
| PageRank 动态版 | 权重标量 | 最大变化小于容差 | 中,轮数自适应 |
| 连通分量 | 目前见过的最小 id | 一轮无任何更新 | 高,最坏跑满直径轮数 |
| 三角计数 | 邻居 id 集合 | 无迭代,两轮消息 | 消息大,hubs 是雷区 |
💡 关键直觉:GraphX 的内置算法没有魔法,全是 aggregateMessages 的配方。能读懂配方,就能按自己的业务改消息函数——比如把协作网络的 PageRank 消息从"均分权重"改成"按协作次数加权",一行 sendMsg 的改动。
⚠️ 常见坑:忘了缓存图本体就让算法跑十轮,等于每轮重算一遍对齐。另一个坑是迭代算法跑在倾斜的图上——一个千万粉丝的顶点会把一个分区的消息撑爆,必要时先做度数分流预处理。
何时别用 GraphX
巡检的最后一步是知道边界。图规模在千万边以内、且计算与批分析共线(结果要直接进数仓或机器学习链路),GraphX 的引擎协同是优势;当图超过十亿边、迭代深度大(最短路、多跳查询)、或需要毫秒级在线图查询时,专用图计算引擎或图数据库在通信模式与索引上都有代差优势。另一个信号是开发体验:GraphX 停留在 Scala RDD API,没有 DataFrame 版本,Python 侧无法直接使用——纯 Python 团队维护 GraphX 代码库的成本要提前算进选型账里。折中方案常见两种:用 Spark 完成图数据的预处理与算法外围的批计算,把核心迭代交给专用引擎;或干脆用消息队列加自研迭代任务模拟小规模图计算,规模不大时反而最省心。选型结论一句话:先算清边数量级与迭代深度,再看团队语言栈,两个约束一交叉答案基本就出来了。## 本节要点回顾
- PageRank 权重沿出边流动:每轮一次消息 Shuffle,动态版用容差换轮数
- 连通分量靠最小号传播:最坏轮数受图直径约束,是集团归一的主力工具
- 三角计数消息最重:邻居集合随度数膨胀,超 hubs 节点要预处理
- 一切算法同一原语:改 sendMsg 就能定制业务化图算法
- 缓存与倾斜:图算法两大高频事故源,先缓存再迭代,先分流再发消息
图计算到此收束。第 6 章换巡检对象:不再看数据怎么算,而是看承载计算的集群怎么部署、怎么配资源、怎么排障。