6.1 集群部署模式:Task 派发的四条路径
6.1 集群部署模式:Task 派发的四条路径
本节摘要:Spark 可跑在 local、Standalone、YARN、Kubernetes 四种模式与 client/cluster 两种提交形态下。模式决定资源由谁分配、Executor 落在哪;提交形态决定 Driver 进程位置。本节逐条走 Task 派发路径,给出选型依据。
前五章代码里那句 setMaster 从没被认真对待过,本节补上:它是引擎巡检的第一个分叉点。同一行代码,master 参数不同,Driver 找谁要资源、Executor 落在哪个进程、日志去哪看,全都不同。
local:单进程里的"仿真集群"
# 4 个线程模拟 4 个 Executor slot,Driver 跑在提交进程里 spark-submit --master "local[4]" --class com.demo.App app.jar
local 模式下没有网络:Driver 与"Executor"是同进程线程,Task 派发退化为线程池提交,Shuffle 走本地磁盘目录。它的价值不在性能而在保真——第 1 章的分区实验、第 2 章的执行计划观察都适合先在 local 验证。注意 local 模式默认给每个任务极小的 JVM,遇到要调 executor 内存的行为实验会失真,此时用 local-cluster 模式,能在单机里拉起真实的多个 Executor 进程。
Standalone:Spark 自带的简装集群
# 主节点 sbin/start-master.sh # 工作节点,向主节点注册并提供核数内存 sbin/start-worker.sh spark://master-host:7077 spark-submit --master spark://master-host:7077 \ --deploy-mode cluster --executor-memory 4g --executor-cores 2 app.jar
Standalone 主从架构一目了然:Driver(cluster 模式下)向 Master 申请固定数目的 Executor,Master 指挥 Worker 拉起 Executor 进程,Executor 反向注册回 Driver。资源模型是粗粒度的"先到先得",没有队列、没有抢占,适合团队内小型专用集群。巡检入口是 Master 的 8080 端口页面,能看到每个 Worker 的在用与剩余资源。
YARN:借别人的资源池
# client 模式:Driver 在提交机,调试期看输出方便 spark-submit --master yarn --deploy-mode client app.jar # cluster 模式:Driver 跑在集群内的 ApplicationMaster 容器里 spark-submit --master yarn --deploy-mode cluster \ --num-executors 20 --executor-memory 6g --executor-cores 4 app.jar
YARN 模式下 Spark 不再自己管资源:ApplicationMaster 负责向 ResourceManager 要容器,每个容器装一个 Executor。与前两种模式的本质区别是多租户公平性——队列、优先级、抢占都由 YARN 统一裁决,Spark 只是池子里的一个租户。代价是排障要跨两层:Spark UI 之外还要看 YARN 的容器杀死记录。生产上多数事故的第一现场就在这:容器内存超限被杀,Spark 侧只表现为 Executor lost 与任务重算。
Kubernetes:容器化部署
spark-submit --master k8s://https://k8s-apiserver:6443 \ --conf spark.kubernetes.container.image=spark:3.5 \ --conf spark.kubernetes.executor.request.cores=2 app.jar
K8s 模式把 Executor 变成 Pod,由 K8s 调度器按资源请求与亲和规则落位。它带来的新能力全是容器生态的:弹性伸缩接群自动扩缩容、镜像统一运行环境、Executor Pod 挂了由 K8s 重建。注意 Driver 也跑在 Pod 里(除非 client 模式),网络策略与镜像仓库的准备成本高于 YARN,适合已经容器化的团队。
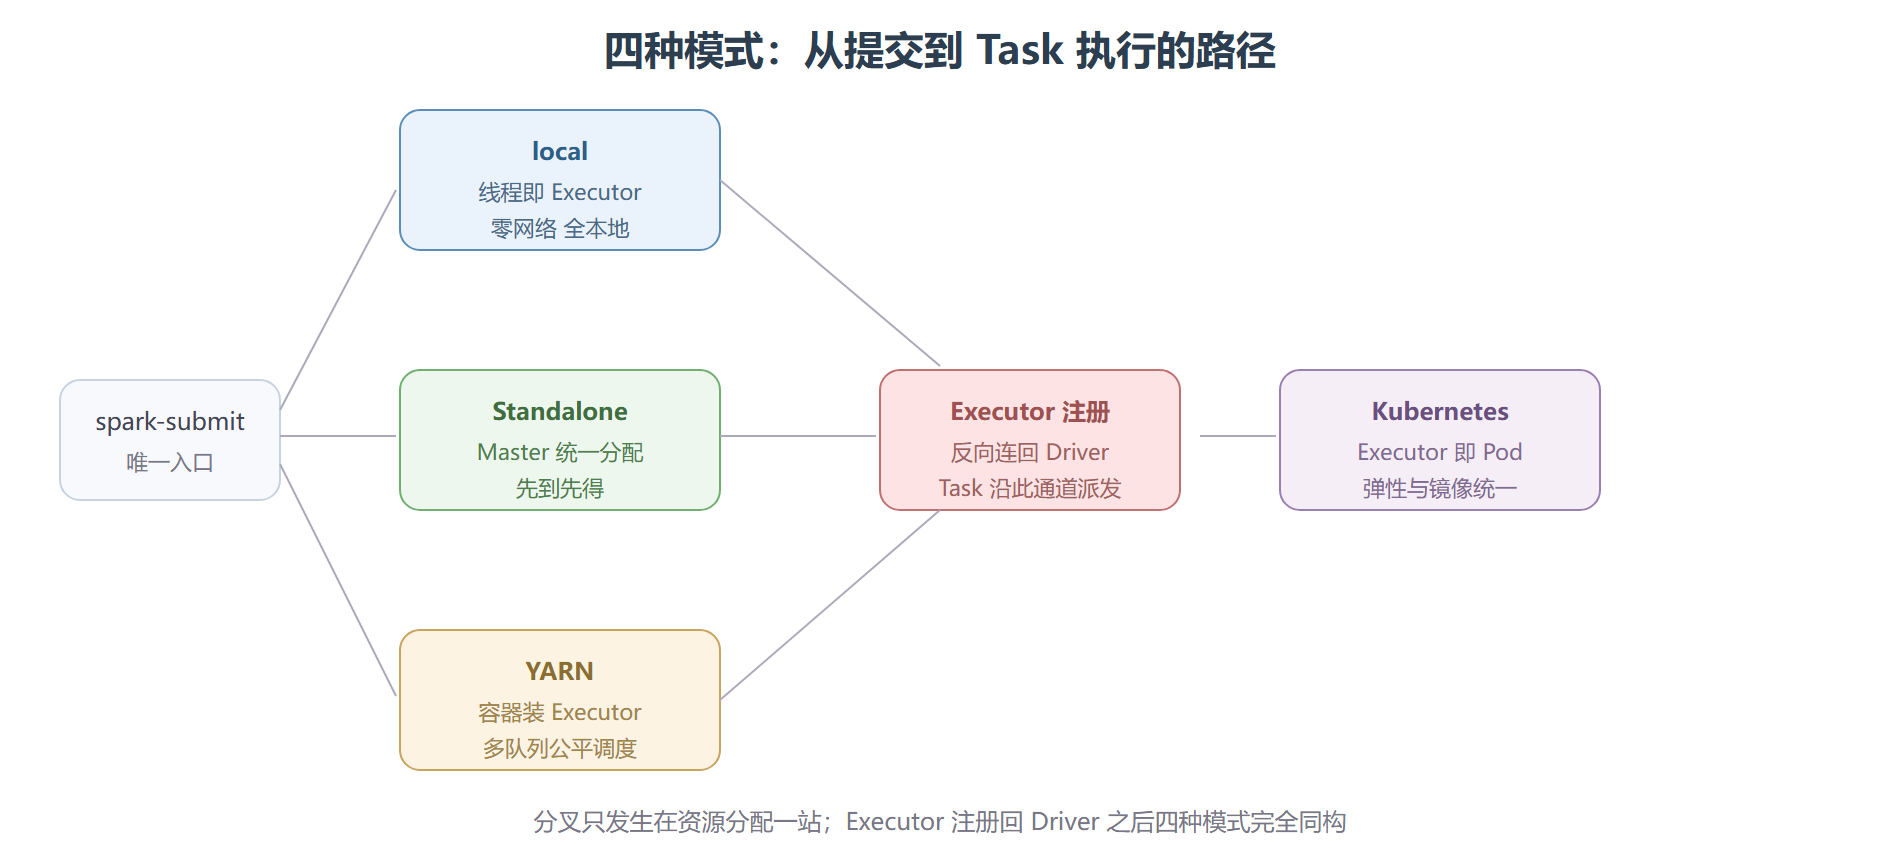
四条派发路径的对照
client 与 cluster:Driver 落位之争
deploy-mode 决定 Driver 进程在哪。client 模式 Driver 在提交机,repl 与即席查询靠它实时看结果,但要求提交机与集群网络互通且不能中途断网。cluster 模式 Driver 进集群,提交机断线作业照跑,生产定时任务必选——代价是 stdout 要去集群侧找。巡检习惯相应不同:client 模式日志就在手边,cluster 模式第一站是 yarn logs 或 kubectl logs。
巡检案例:同一作业换模式的执行差异
背景:一个 20 分钟的 Shuffle 型作业从 local 搬上 YARN。操作:仅改 master 与资源参数,代码不动。结果:local 下 8 分钟跑完(数据本就在本机磁盘),YARN 上首次跑 21 分钟——多出的是数据从 HDFS 读取的吞吐差与容器冷启动。解读:模式切换不改 DAG,改的是每个 Task 的 I/O 环境与调度延迟,性能对账要把这两项单列。变式:该作业挪到 K8s 且启用动态分配后,高峰期 Executor 数从 20 浮动到 35,总时长反而稳定在 19 分钟——弹性吸收了队列波动。
⚠️ 常见坑:client 模式跑生产长任务,人下班断 VPN,Driver 一死全作业陪葬。另一个坑:YARN 下忘记设 spark.yarn.maxAppAttempts,ApplicationMaster 失败一次整个应用直接退出。
本节要点回顾
- 四模式一分叉:资源分配方式不同,Executor 注册回 Driver 之后完全同构
- local 保真有限:涉及 Executor 内存行为的实验用 local-cluster
- YARN 是多租户世界:排障必须跨 Spark 与资源管理器两层
- K8s 生态增益:弹性、镜像、Pod 级隔离,但准备成本最高
- deploy-mode 看场景:调试用 client,生产用 cluster,断网即断作业是真实教训
模式定了,下一步是往里填资源。下一节算内存账:每个 Executor 的内存被切成哪几块、参数怎么互相牵制。