6.3 监控日志与故障巡检:从信号到根因
6.3 监控日志与故障巡检:从信号到根因
本节摘要:Spark 的观测面由 UI、指标系统、事件日志三层构成。本节给出巡检路线:先定层(Driver/调度/Executor/数据),再看层内信号,最后用日志坐实根因;并整理倾斜、缓存逐出、Executor lost 三类高频故障的完整排查过程。
前两节是"布置机房",本节是"值夜班"。巡检的核心方法论只有一句:先定层,再定因。跳过定层直接猜代码,是排障绕远路的第一大原因。
三层观测面各看什么
# 事件日志:把作业全过程录下来,事后用 UI 离线重放 --conf spark.eventLog.enabled=true \ --conf spark.eventLog.dir=hdfs:///spark-logs # 指标系统:给 Prometheus 抓的落点 --conf spark.metrics.conf.driver.source.jvm.class=org.apache.spark.metrics.source.JvmSource
UI(4040 端口)看"这一次作业":Stage 耗时、任务分布、Shuffle 读写量、Storage 命中。指标系统看"长期趋势":各 Executor 的内存与 GC 曲线,接上 Prometheus 与 Grafana 才有比对能力。事件日志看"案发现场回放":作业已经死了,UI 没了,用历史服务器载入事件日志重放全部细节。三层对应三种巡检时机:进行中、日常巡检、事后追查。
分层排障的路线图
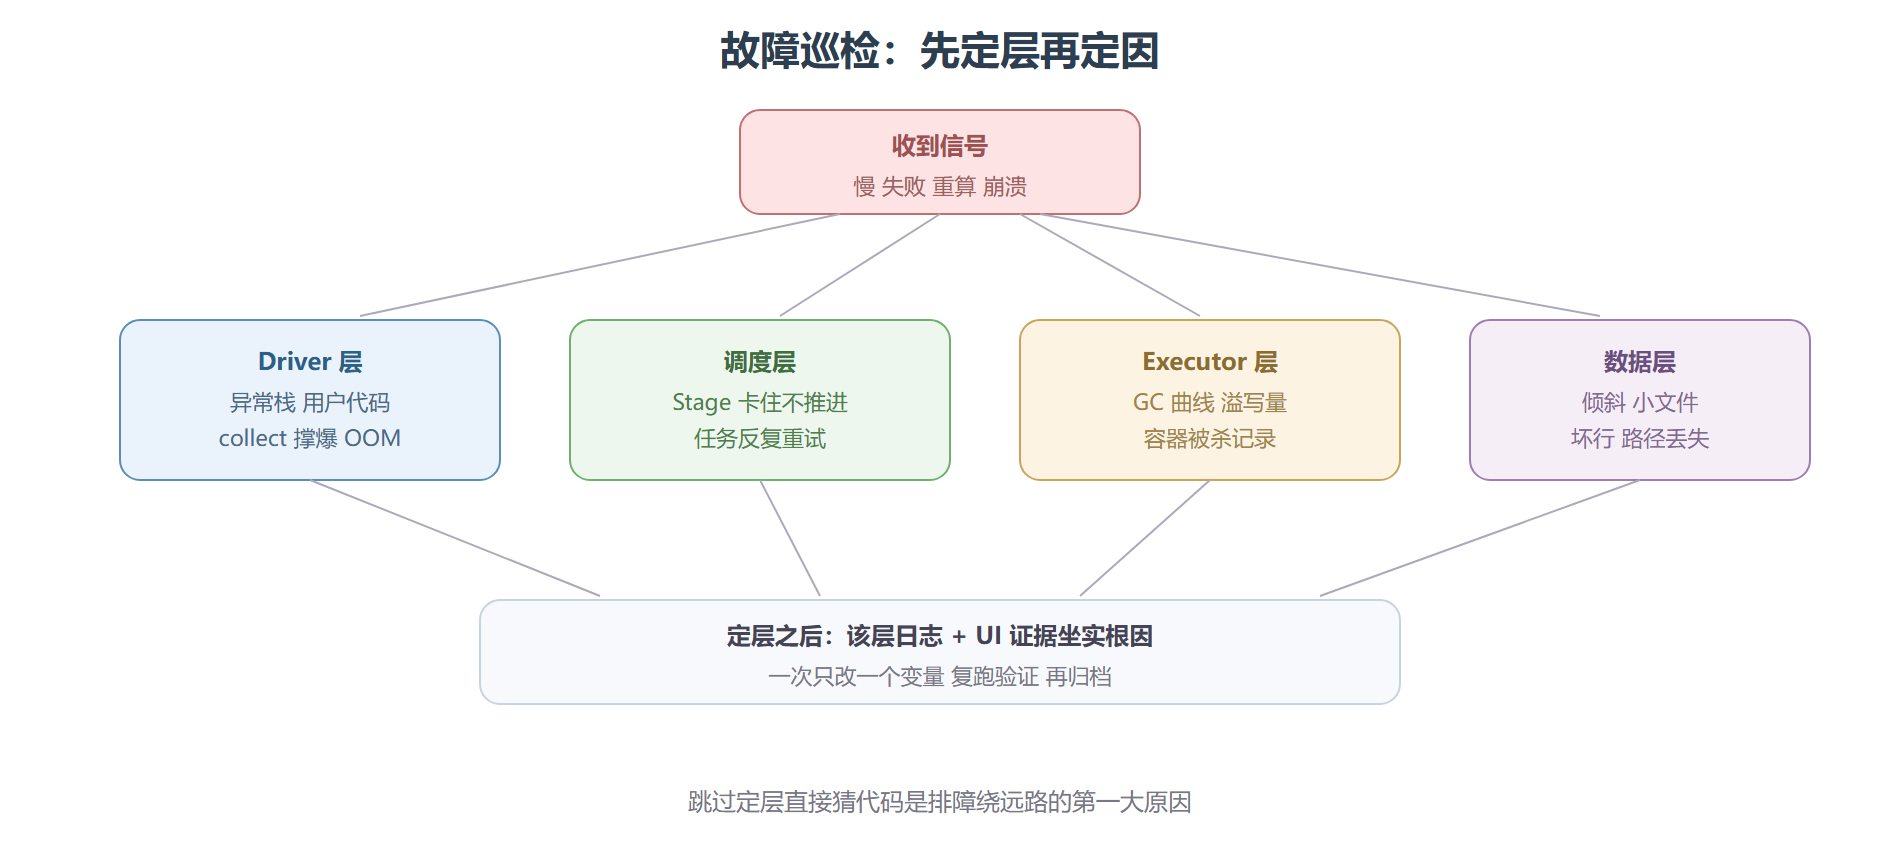
三类高频故障的完整排查
倾斜:199 等一的 Stage。 信号:Stage 页任务条形图里一根长尾,其余任务几分钟完成、一个跑一小时。定位:点开最长任务的详情看 Shuffle Read Size,与中位数比对通常差两个数量级。坐实:数据层——按 Shuffle key 计数确认热点 key。处置:热点 key 加盐打散、两阶段聚合,或开启 AQE 的倾斜拆分。验证:重跑后长尾消失、Stage 总时间贴近中位数乘任务数。
缓存逐出:越跑越慢的迭代。 信号:同样的迭代轮次,一轮比一轮慢。定位:Storage 页缓存比例逐轮下降、Executor 磁盘读曲线爬升。坐实:执行内存被 Shuffle 侵占,缓存块被挤出统一内存。处置:改序列化级别压缩体积、或提高存储份额并减少并发。上一节的内存账在这里直接兑现。
Executor lost:被杀的搬运工。 信号:任务日志成片出现 Executor lost 与 fetch failed,Stage 反复重试。定位:先看 YARN 容器杀死记录或 K8s Pod 事件,再分三类——超内存被杀(overhead 不足)、节点故障(整机失联)、磁盘满(Shuffle 写不进)。处置各不同:涨 overhead、等节点剔除重提、清盘或换 Shuffle 目录。这里体现了第 6.1 节的结论:YARN/K8s 模式下排障必须跨到资源层去看。
# 一条命令拉全量日志(YARN cluster 模式的事后追查入口) yarn logs -applicationId application_1690000000001_0042 > full.log
⚠️ 常见坑:流作业(第 3 章的微批引擎)没有"作业结束"概念,UI 是连续滚动的事件流,巡检要改看批处理延迟指标——每个微批的调度耗时曲线抬升,往往比错误日志更早暴露问题。
💡 关键直觉:所有"神秘"故障在事件日志里都有先兆。把 eventLog 常开当成行车记录仪,是运维性价比最高的一项配置。
值班手册:接到告警后的头五分钟
把本章压成一张值班卡。第一分钟看作业还活着没有:UI 能打开、Driver 在不在、失败任务数是否还在涨。第二分钟定层:Stage 页卡住的环节是输入、计算还是输出,Executor 是死是活。第三分钟抓最近一次变更:配置、代码、数据量、上游表结构,四样里八成藏着根因。第四分钟决定动作:能降级先降级(缩小批次、回退版本、切备用队列),保业务再查因。第五分钟归档:把现象、证据、处置记进故障库——下次同类告警,这张卡就能从第五分钟倒着走。巡检的成熟度不体现在背了多少参数,而体现在这套节奏有多自动化。
把三类高频故障再各配一句"夜班速答"。倾斜:先数热点 key,别急着重启——重启只会让同样的长尾再跑一遍。缓存逐出:先看存储曲线再清缓存,盲目清除等于把症状和证据一起销毁。Executor lost:先查资源层的杀死记录再查 Spark,方向反了会在引擎日志里白熬两小时。三句话贴在值班屏幕边上,比任何长篇手册在凌晨三点都好使。
监控建设最后一段路是"让指标自己开口"。固定阈值告警只回答"超没超",趋势告警才回答"正不正常"——同环比、滑动分位数能抓到缓慢劣化,例如 Shuffle 读量每周涨 5%,三个月后就是压垮批窗口的大山。给每个核心作业建一条"耗时基线带",出带即告警,比拍一个绝对阈值可靠得多。指标系统的价值不在收集,在基线。
告警的最后一课是治理告警本身。基线带建好后,每周花十分钟看告警的触发与处理记录:误报的调阈值,没人响应的要么降级要么删除,重复触发指向的慢性问题转成工单根治。告警的信任是易耗品——连续三次狼来了,第四次真狼来了也没人看。监控系统的半衰期由此决定,运维的功夫一半在机器上,一半在流程上。把这节的路线图打印出来贴在值班位,是很多团队的起步动作,效果朴素但确实好。监控做扎实的团队,故障复盘会多半在讲改进而不是追责——这才是巡检文化的最终产出。与诸君共勉。
本节要点回顾
- 三层观测面:UI 看当次、指标看趋势、事件日志做回放
- 先定层再定因:Driver、调度、Executor、数据四层,跳层必绕路
- 倾斜三步:长尾定位、热点 key 计数坐实、加盐或 AQE 处置
- 逐出看曲线:缓存比例下降加磁盘读爬升是铁证
- Executor lost 分三类:超内存、节点故障、磁盘满,处置各不相同
引擎本身看护好了,最后一节补上围栏:谁能连、数据怎么加密、审计留什么痕。