7.1 与Hadoop生态集成:数据本地性的调度红利
7.1 与Hadoop生态集成:数据本地性的调度红利
本节摘要:Spark 与 Hadoop 的集成走两条线——HDFS 作为存储层提供块位置信息、Hive 仓库提供 metastore 元数据服务。块位置让调度器能优先派发本地任务,节省的是真实网络搬运。本节拆解这条红利链,并看 Hive 仓库表的读写路径。
最后一章从引擎与存储的握手开始。回到第 1 章的调度链路:TaskScheduler 派发任务前会拿到一份"任务偏好位置"清单,而这份清单最好的供给者就是 HDFS——块在哪台机器上,NameNode 一清二楚。理解这条链,才算理解 Spark 为什么"长在" Hadoop 生态里。
HDFS 连接器:块位置就是调度提示
df = spark.read.text("hdfs://nn:9000/logs/2026/08/*") # 触发执行后,Spark 向 NameNode 查询每个文件块的位置 # 生成的每个分区携带 preferLocation 信息
读取路径上的分工:Driver 侧列目录、按文件大小与块边界规划分区,随后每个分区带着"我的数据块在主机 A、B、C"的提示进入调度队列。TaskScheduler 的本地性分三级——进程本地(Executor 缓存里就有)、节点本地(同机 HDFS 数据节点)、机架本地(同机架搬运一次)。调度器会先等本地槽位,等不到再降级,等待超时由参数控制。这是一场"等一等等出网络搬运的节省"的博弈。
数据本地性的调度影响路径
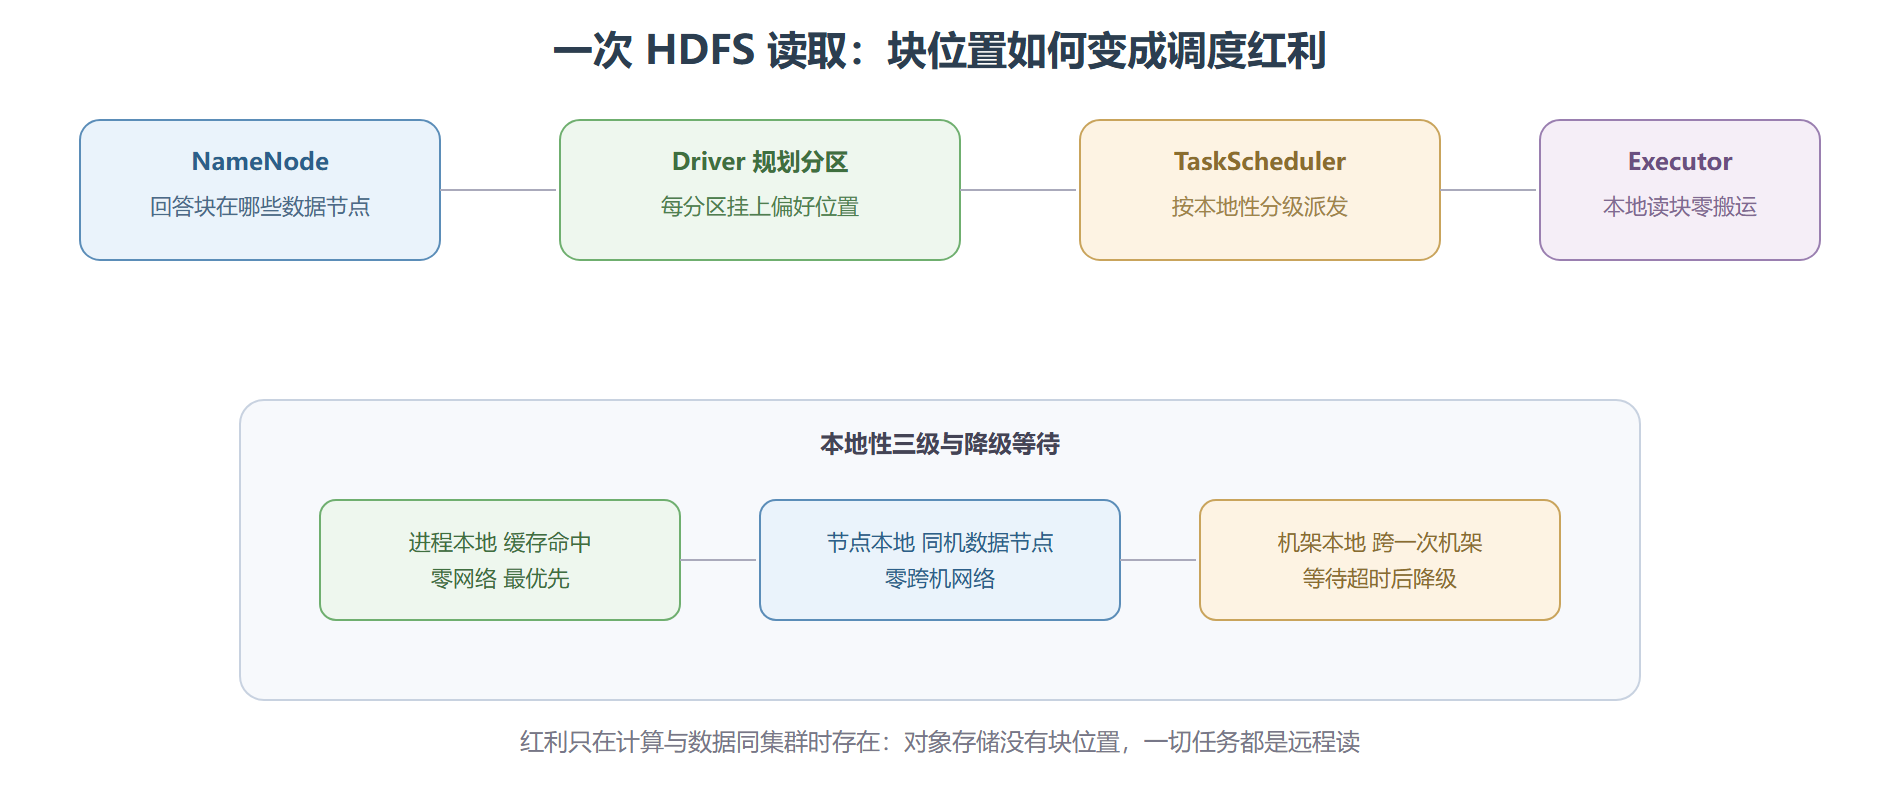
巡检视角的关键推论:换存储就换红利。同一作业从 HDFS 迁到 S3 或 OSS,块位置信息消失,所有任务降为远程读,Task 的输入阶段耗时整体抬升。这不是退化,是代价换来了对象存储的弹性与低价——两套账要分开算。
Hive 仓库:metastore 管目录,Spark 管计算
# 启用 Hive 支持后,SQL 直接落在仓库表上 spark = SparkSession.builder.appName("hive-brief") \ .config("spark.sql.warehouse.dir", "hdfs://nn:9000/warehouse") \ .enableHiveSupport().getOrCreate() spark.sql("SHOW DATABASES").show() spark.sql(""" SELECT dt, count(*) AS pv FROM dwd.user_events WHERE dt >= '2026-08-01' GROUP BY dt """).show()
metastore 里存放的是库、表、分区与列结构到物理路径的映射。Spark 拿到映射后,扫描哪些 HDFS 目录、怎么切分区,全部由自己的引擎决定——这就是" metastore 管元数据,计算引擎管执行"的分工。分区裁剪在此自动发生:WHERE 条件里的 dt 让引擎直接跳过不在范围的子目录,代价从全表扫降到分区扫。巡检方法是看执行计划的 PartitionFilters 行,确认分区条件真的下推了。
写回与格式选择
df.write.format("parquet") \ .partitionBy("dt") \ .mode("overwrite") \ .saveAsTable("dws.daily_pv")
| 格式 | 读路径特点 | 典型场景 |
|---|---|---|
| Parquet | 列裁剪与谓词下推,扫描量最小 | 数仓主存储 |
| ORC | 与 Parquet 同级,Hive 系生态更顺 | Hive 深度用户 |
| 文本与 JSON | 无下推,序列化贵 | 交换与调试 |
巡检案例:分区数失控拖垮 Driver
背景:按"小时加分钟"双字段分区写入,一天产生 1440 个分区目录。操作:例行查询整月数据。结果:Driver 规划阶段耗时 40 秒——4 万多个目录的列表与元数据解析全在 Driver 串行完成,Stage 还没开始跑。解读:文件系统连接器的"先列目录再切分区"设计决定了目录数就是 Driver 的负担,分区粒度要用查询模式反推,而不是越细越好。变式:改成按天分区加文件内按小时排序后,规划耗时降到 2 秒,代价是单分区查询要读整天数据再过滤——典型的粒度交换。
⚠️ 常见坑:小文件问题。每批任务各写一个目录下的小文件,一周后一个分区几千个文件,下游扫描的任务数爆炸。写入侧合并、定期 compaction 是仓库治理的常规动作。
💡 关键直觉:判断任何存储集成的好坏,就看一件事——它给调度器提供了多少位置与统计信息。HDFS 给块位置,Hive 给分区结构,对象存储两者皆无,答案就写在输入耗时里。
FAQ 一问:表统计信息从哪来,为什么影响这么大
Catalyst 选 Join 策略、估分区数靠的是表级与列级统计(行数、基数、空值率、极值)。新表或刚写完的分区统计缺失时,优化器只能用尺寸推算的粗默认值,广播与排序归并的抉择常出错。补齐动作就一条 ANALYZE 语句的事:对重点表与常用连接键收集统计,写入仓库元数据。调度系统里把"写入完成即触发统计收集"设为标准步骤,能消掉一整类"昨天还好好的"性能悬案——这类问题的特征恰恰是执行计划变了而代码没变。统计本身也要巡检:增量写入的表若只收过一次旧统计,行数估算会越漂越远,优化器的每个代价判断都跟着歪;按写入频率安排统计刷新周期,是数仓表继小文件之后的第二项例行体检。两件事在调度上都便宜,贵的是忘了做之后的事故排查工时。本节到此,文件系统侧的接入账算清了,下一节转向自带分区结构的行存世界。## 本节要点回顾
- 块位置即调度提示:本地性三级降级,红利来自免去的网络搬运
- 换存储换账本:对象存储无位置信息,输入阶段天然全远程
- metastore 与引擎分工:元数据映射归仓库,扫描计划归 Spark
- 分区粒度反推查询:过细的分区把负担转嫁给 Driver 规划阶段
- 格式选列存:Parquet 或 ORC 的下推能力是扫描成本的分水岭
下一节看另一种形态的邻居:不提供块位置、但按分区键自带切分信息的 NoSQL 行存。