7.4 Spark Connect与Delta Lake:引擎边界的新画法
7.4 Spark Connect与Delta Lake:引擎边界的新画法
本节摘要:Spark Connect 把客户端从集群 JVM 里解耦出来,逻辑计划经序列化送往服务端执行,客户端变成轻量安装;Delta Lake 在对象存储之上加事务日志与增量文件层,给数据湖补上 ACID 与时间旅行。两者一改计算边界、一改存储语义,是本册收尾的两块拼图。
全册巡检到这里,最后看两处正在变化的地界。第 1 章那张提交链路图里,Driver 与你的客户端进程是同一个 JVM——Spark Connect 动的就是这一刀;前几节的仓表写入没有事务保证——Delta Lake 补的就是这一课。
Spark Connect:客户端只剩一个计划生成器
# 客户端不再需要完整 Spark 安装,pip 装的薄客户端即可 pip install pyspark-connect spark = SparkSession.builder.remote("sc://connect-host:15002").getOrCreate() df = spark.read.parquet("warehouse/events") df.groupBy("dt").count().show() # 与集群内写法完全一致
变化在于链路:传统模式下你的 Python 代码与 Driver JVM 同进程,Py4J 网关在进程内转发调用;Connect 模式下,客户端只做一件——把链式调用组装成逻辑计划,序列化后经 gRPC 送到服务端,服务端里的 Spark 会话负责 Catalyst 优化、物理规划与任务调度全流程。执行结果以箭头格式流回。代码零改动是设计目标,底层运输完全重铺。
解耦前后的链路对照
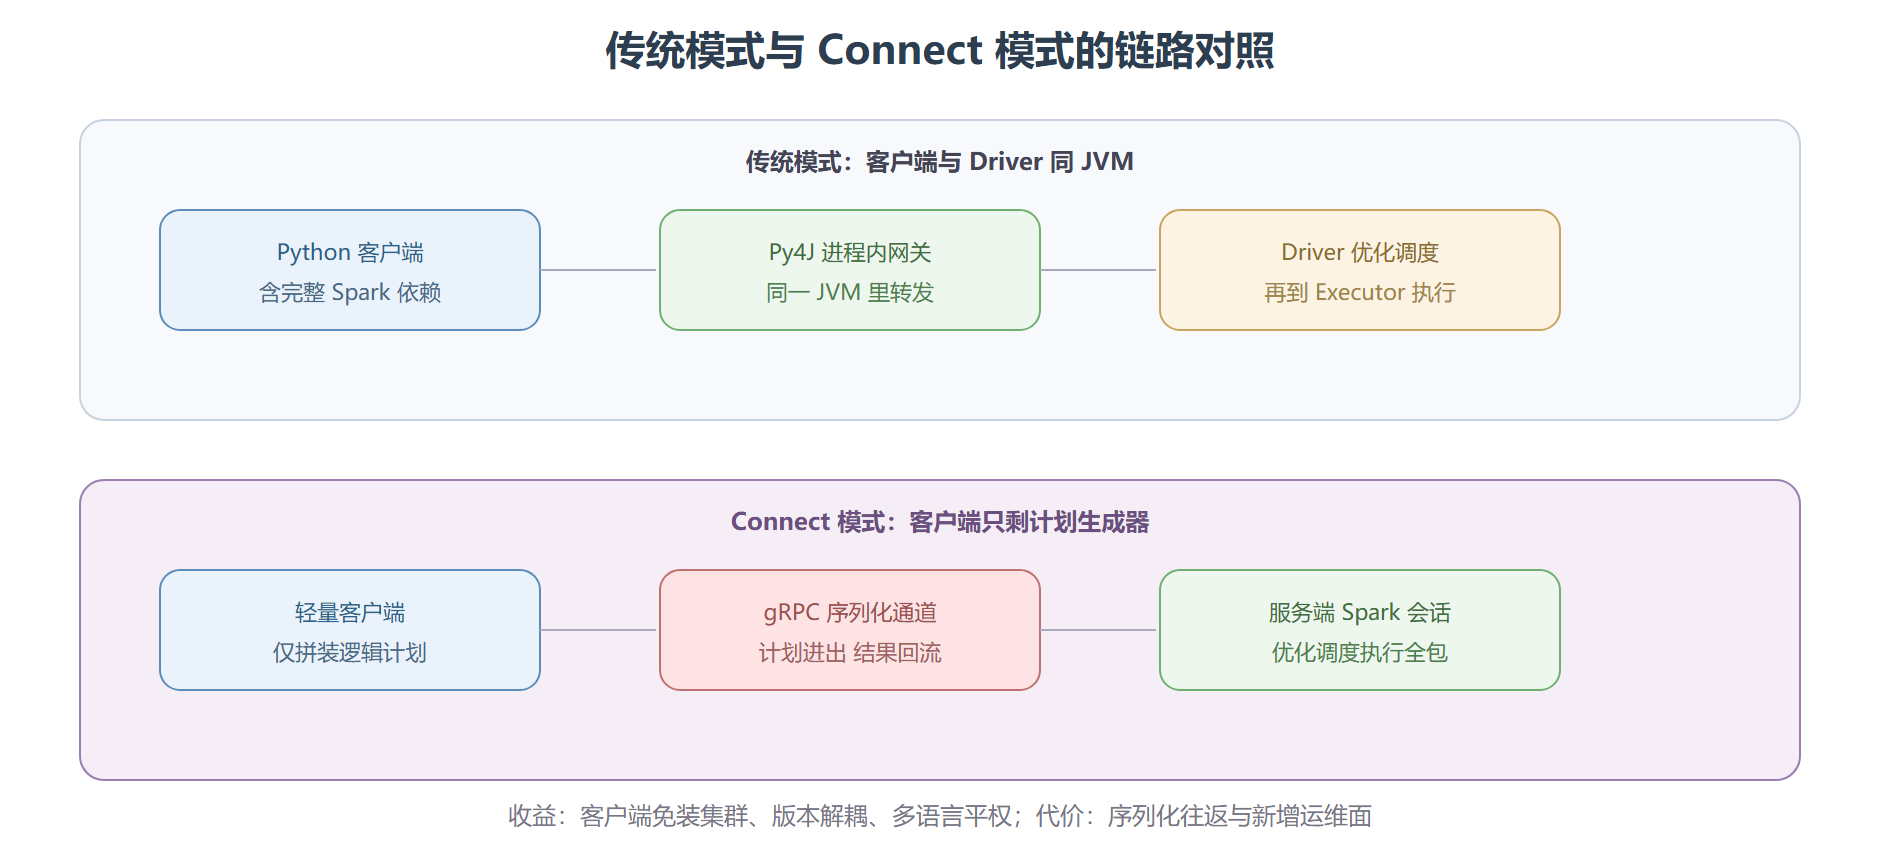
巡检视角的得失清单。收益三条:客户端摆脱对集群 JVM 版本的绑定,升级服务端不动客户端;笔记本、IDE 与应用服务器不再需要千兆级依赖;连接可以复用一个共享服务端,资源隔离交给服务端治理。代价两条:计划序列化与结果回流增加一跳延迟,毫秒级点查更疼;服务端成为新增的运维对象,需要按第 6 章的方法纳入巡检。适合分析与即席场景,极端低延迟场景仍倾向内嵌会话。
Delta Lake:给文件加一层事务账本
df.write.format("delta").mode("overwrite") \ .partitionBy("dt").save("hdfs://nn:9000/lake/events") # 事后回到昨天的版本看数据 from delta.tables import DeltaTable dt = DeltaTable.forPath(spark, "hdfs://nn:9000/lake/events") dt.history().show() # 每次提交一条记录 spark.read.format("delta") \ .option("versionAsOf", 3).load(path).count() # 时间旅行
机制拆开是"日志加数据"两层:数据仍是 Parquet 文件,每次写入只追加新文件;事务日志记录每个文件的加入与删除,读时先读日志拼出当前有效文件清单。ACID 来自日志的乐观并发控制——两个并发写冲突时,后提交者按日志检测冲突并失败重试,不会出现半张表。时间旅行几乎是免费的副产品:旧版本文件在清理策略保留期内还在,换一个版本号就读到。
| 能力 | 靠什么实现 | 巡检点 |
|---|---|---|
| 事务提交 | 日志的原子记录 | history 里每次提交的耗时 |
| 时间旅行 | 保留期内的旧文件 | 清理策略与存储成本 |
| 增量读取 | 日志记录的新增文件 | 流作业直接把表当源 |
| 模式演化 | 日志中的模式版本 | 兼容性级别设置 |
巡检案例:并发写冲出一张裂表
背景:两个团队各跑一个作业向同一张 Parquet 目录表写当天分区,调度偶发重叠。操作:无任何并发控制,直接覆写。结果:某天分区里出现两种 schema 的文件混居,下游扫描随机报列缺失。解读:纯文件目录没有事务,后写者只覆盖自己看到的文件清单,重叠窗口内的写入互相踩踏。变式:迁到 Delta 后,冲突的提交被日志仲裁,后到者失败重试,表任何时候都是完整一致的——这正是第 6.3 节"故障要防在配置层"的存储版注脚。
⚠️ 常见坑:以为 Delta 让小文件消失。它提供 compaction 能力,但合并要显式触发;流式高频写入不定期压实,文件数照样失控。
💡 关键直觉:Connect 改变的是"计划在哪成形",Delta 改变的是"文件如何成为表"。一个动了计算边界的画法,一个动了存储语义的地基,其余的 Spark 知识在前六章的位置不变。
FAQ 一问:Delta 的时间旅行能回多久
取决于两件事:物理文件还在不在、日志还记不记。默认策略按时间与版本双门槛清理过期快照,被清理的版本不可再读。所以"回到上周"不是无条件的承诺——回溯窗口要用清理参数显式保留,且要清楚保留期越长存储成本越高。生产惯例:审计要求长的表保留三十天以上,普通分析表一天到七天。另一个细节是时间旅行的读成本:读旧版本要把该版本之后删除的文件排除、新增的文件纳入,版本越老拼装清单越长,点查无感、大扫描时差异会显出来。因此"用时间旅行做长期回溯报表"不是好主意,重活儿该回到当时版本的物化产物上跑,时间旅行留给排查与对账这类轻量场景。全册的最后一块拼图就位,欢迎带着整套巡检视角回到你自己的集群。
本节要点回顾
- Connect 三收益两代价:版本解耦与轻客户端对上序列化延迟与新增运维面
- 逻辑计划跨线:客户端拼计划、服务端做优化与调度,代码零改动是设计目标
- Delta 是日志加文件:ACID 来自乐观并发控制,时间旅行是保留期的副产品
- 并发写的解药:纯目录必踩踏,事务日志天然仲裁
- 压实要显式:流式写入配定期 compaction 才不会重蹈小文件覆辙
全册到此收束。回头看第 1 章那张提交链路图——如今每个箭头你都能说出它的物理载体与失败形态,这台执行引擎的巡检日志,可以正式翻页了。