3.1 IoC容器如何为请求备好对象
3.1 IoC 容器如何为请求备好对象
本节摘要:IoC 容器在请求到来之前完成两件事——创建对象(Bean)并按依赖关系把它们连成一张网。本节解释控制反转反转的是什么、容器与 BeanFactory 及 ApplicationContext 的关系,并用启动期的实证观察代替抽象定义。
反转了什么
不 inversion 这个词时,先看没有容器时你怎么写代码:
public class OrderController { private final OrderService service = new OrderService(new JdbcOrderRepository(dataSource)); }
对象的创建权、依赖的组装权都在你手里,缺点也随之而来:上层类必须知道下层的构造细节,换一个实现要改上游,单元测试只能连着真数据库跑。所谓控制反转,就是把"创建与组装"这项控制权交给容器:
@RestController public class OrderController { private final OrderService service; public OrderController(OrderService service) { // 容器送进来 this.service = service; } }
你不再说"给我 new 一个",只声明"我需要一个 OrderService",容器负责找到或创建并递过来。依赖注入是这一思想的具体手法。收益集中在三处:实现可替换(换实现不动调用方)、可测试(测试时注入替身)、生命周期统一管理(对象何时生何时死有章法)。
容器的两个接口
容器自身的抽象经历了两层演进。BeanFactory 提供最基本的能力:注册定义、按名取 Bean。ApplicationContext 在其上叠加了企业应用需要的一整套:事件发布、国际化、资源加载、自动后处理。实际开发中用到的都是后者,常见实现三类:
| 实现类 | 配置来源 | 典型场景 |
|---|---|---|
| 注解配置上下文 | 注解与组件扫描 | 现代 Java 配置应用 |
| XML 文件上下文 | XML 装配文件 | 遗留系统维护 |
| Web 应用上下文 | 基于以上两种 | 每个 Web 应用一份 |
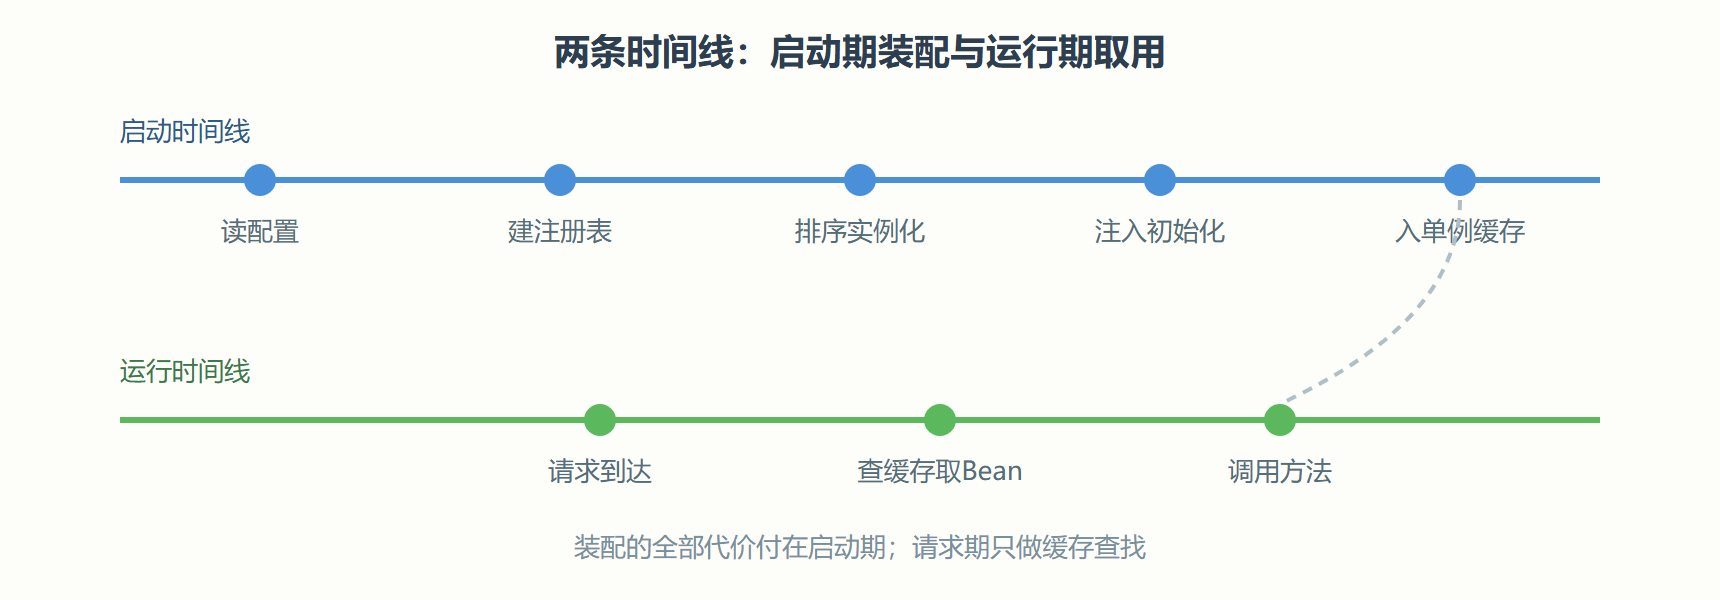
无论哪种,容器启动时做的事一致:读配置、生成 Bean 定义注册表、按依赖排拓扑序、逐个实例化并注入、执行初始化回调、放进单例缓存。请求到来时"取 Bean"只是查缓存,几乎零成本——这解释了为什么 Spring 应用的请求处理本身不因容器而产生明显开销。
图 3-1 请求时序与容器装配时序的错位
亲眼看一次装配
在启动类后面临时加一段,把容器里的Bean打印出来:
@SpringBootApplication public class TraceApplication { public static void main(String[] args) { var ctx = SpringApplication.run(TraceApplication.class, args); ctx.getBeanDefinitionNames() .forEach(n -> System.out.println("Bean 定义:" + n)); } }
输出会有上百行,其中一部分是你写的类,更多是框架自动配置进来的基础设施 Bean。这份名单就是请求旅程的幕后名单——旅程每经过一站,背后都有一个这里登记过的对象在工作。
案例:从手工装配到容器装配的一次重构
背景:接手一个旧模块,控制器里手工创建 Service、Service 里手工创建数据访问对象,连数据库连接都是自己管理的。换数据源要改三个类,测试必须连真库。操作分三步重构。第一步,把每个手工创建改成构造器声明依赖,类上加组件注解交由扫描。第二步,数据源这样的基础设施对象用配置类集中生产:
@Configuration public class DataSourceConfig { @Bean // 方法返回值进入容器,名即方法名 public DataSource dataSource() { var ds = new SimpleDriverDataSource(); ds.setDriverClass(org.h2.Driver.class); ds.setUrl("jdbc:h2:mem:lab"); return ds; } }
第三步,删掉所有 new 与销毁样板,启动验证。结果:代码净减约四成,测试时只需在构造器传入替身,不再触碰真库。解读:这次重构没有改变任何业务逻辑,改变的只是"创建权归属"——这正是控制反转的工程本质。变式:若团队仍在维护 XML 配置的老系统,同样的装配可以用 XML 声明完成,容器读进后与注解装配殊途同归;混合期里新旧两种来源可以共存,按 Bean 名衔接。
顺带一个实验:在配置类的方法上打断点重启,会看到每个 @Bean 方法只在启动期被调用一次;之后任何请求使用该 Bean 都不再进入方法——"单例缓存"不是口号,是可以断点验证的事实。
顺带回答两个延伸疑问。其一,Bean 数量多了启动会不会越来越慢?会,装配成本与 Bean 数量正相关,这也是切片测试存在的理由——只装配被测的那几层,启动成本随之骤降,第 8 章会接上这个话题。其二,容器与"服务定位器"模式有什么不同?服务定位器要你主动去要对象,依赖关系藏在方法体里;容器通过注入把依赖送到构造现场,依赖关系暴露在签名上,可读性与可测性都高出一截。辨析这类近亲概念时,抓住"依赖是否显式"这条线即可。
本节要点回顾
- 反转的是创建与组装权:代码从"造"退到"要"
- 注入带来三收益:可替换、可测试、生命周期统一
- ApplicationContext 是日常容器:BeanFactory 是它的内核
- 装配代价付在启动期:请求期取 Bean 只是查缓存
读完自测
不看正文回答:控制反转与依赖注入是什么关系;请求处理时从容器取一个 Bean 的成本为什么可以忽略;启动日志末行出现意味着什么。答不出的条目回到对应小节重读即可。