5.2 智能运维:状态修与预测性维护
5.2 智能运维:状态修与预测性维护
本节摘要:运维是铁路全生命周期成本的大头,检修体制的每一次升级——从坏了再修、到期就修,到看着状态修、算着趋势修——都是一次成本的重新分配。本节讲透四种检修体制的演化逻辑、状态修落地的两个前提,以及健康管理 PHM 的数据闭环。读完你能判断一个设备该用哪种修法,以及为什么。
修车不如不修车
运维工程师圈子里流传一句半开玩笑的话:最好的修是不修。它不是躺平,而是一个严酷的成本事实——过度检修本身会引入早期故障。装配工艺再精细,每次解体重装都是一次对出厂配合状态的破坏,新装配的故障率反而高于稳定运行期;检修窗口还直接吃掉运力。所以运维的最高目标从来不是"修得多好",而是"在恰当的时间,用最小的拆动,恢复到需要的可靠度"。要逼近这个目标,前提是知道设备此刻的真实状态与劣化趋势——这就是智能运维全部故事的起点。
四种检修体制:一条演化链
| 体制 | 触发条件 | 优势 | 致命短板 |
|---|---|---|---|
| 事后修 | 坏了才修 | 成本显性、简单 | 停机损失不可控,安全设备不可用 |
| 计划预防修 | 到期(里程或时间) | 风险可控、组织简单 | 过修与欠修并存,成本高 |
| 状态修 | 状态指标越过阈值 | 拆动最少、针对性强 | 依赖检测覆盖率与指标有效性 |
| 预测性维护 | 劣化趋势预测到期 | 提前介入、免突发 | 依赖模型精度与数据质量 |
计划预防修至今仍是铁路的主体体制,它管理的是统计意义上的风险:动车组按走行公里设检修等级,运行若干万公里做一次深度检修,等级越高解体越深;固定设备按周期巡检。它的软肋是一刀切:同一里程,有的部件状态尚佳被提前拆解,有的已在劣化却还没到期——过修浪费、欠修冒险。状态修的突破在于把"日历"换成"体检单":2.1 节的轨道 TQI 就是状态修的鼻祖级指标——TQI 越过管理值就安排捣固,没越线就不动,轨道养护从按周期变成按指标。预测性维护再进一步:不满足于"现在状态如何",而是用寿命模型与机器学习从传感器趋势里预测"多久后会越线",把维修提前排进天窗计划,突发故障被消灭在发生之前。
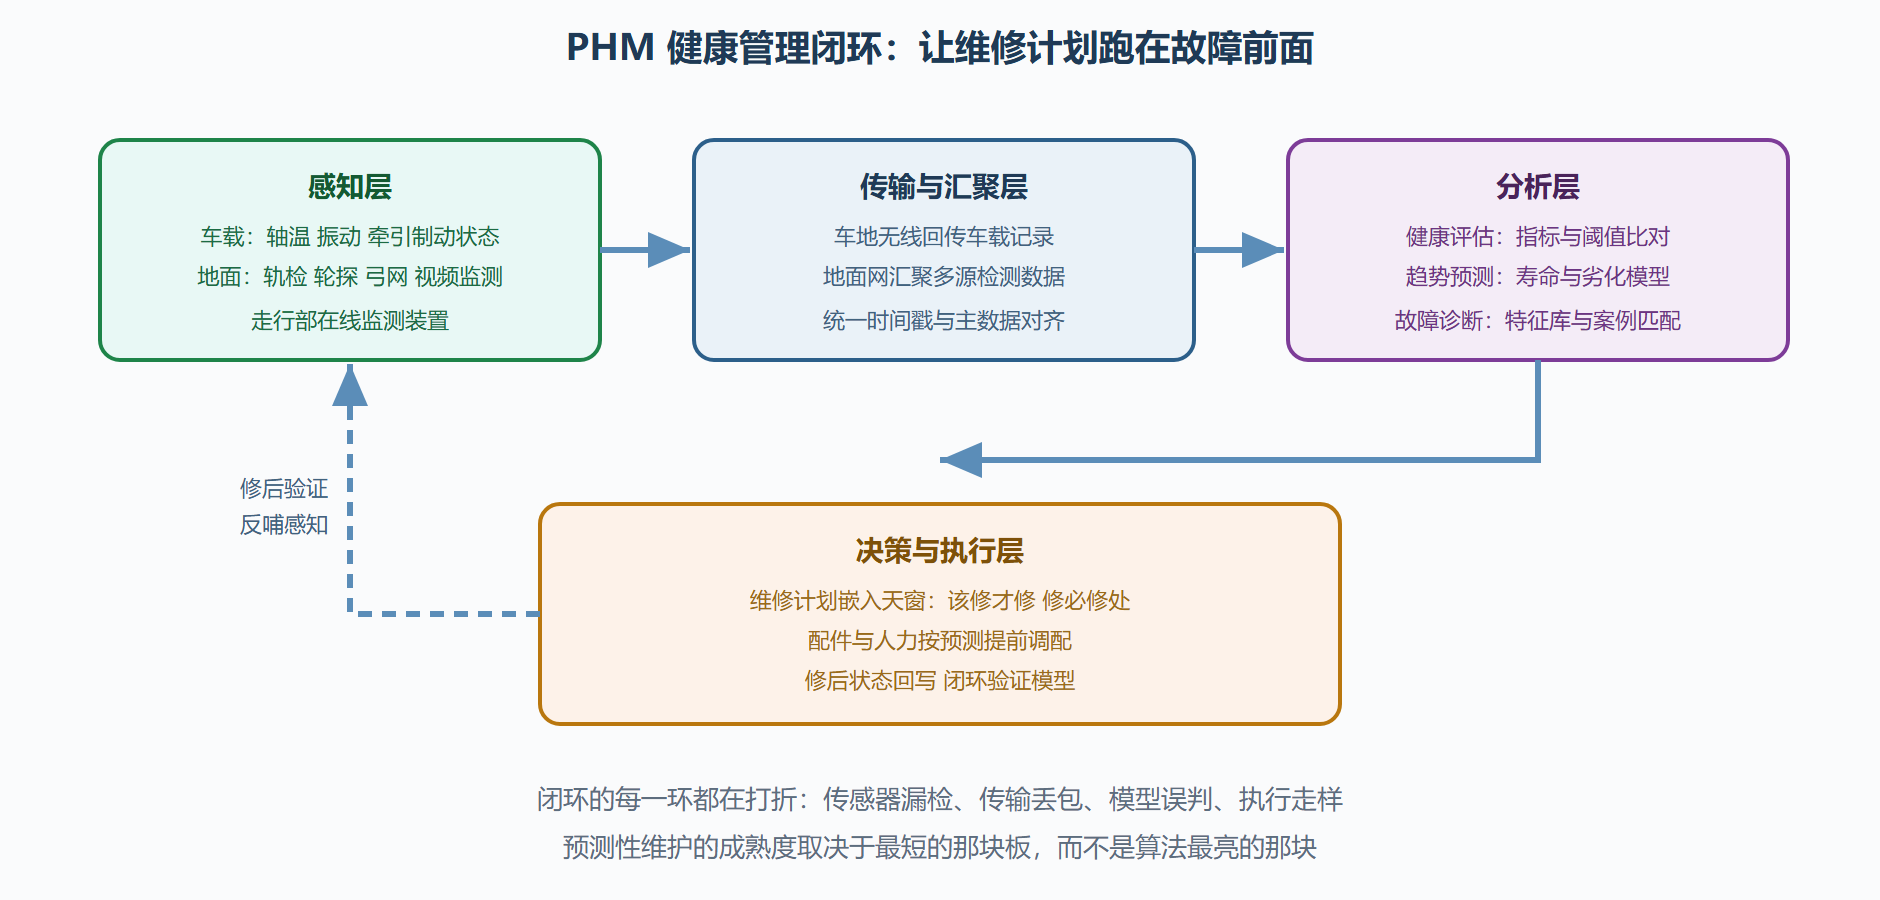
图 5-2:智能运维 PHM 架构:感知到决策的闭环
状态修的两个前提与一个陷阱
状态修说来动人,落地却有两个硬前提。前提一是检测覆盖率:状态修只对"看得见"的部件成立,看不见的地方退回计划修。动车组走行部有在线监测,电机温度有车载记录,但车厢内饰、焊缝内部这类难检测部位,周期检查仍不可替代。前提二是指标有效性:监测量必须与故障机理强相关。轴温探测(红外轴温探测装置沿线路按间隔布点,扫过每根车轴)之所以是经典成功案例,因为温升与轴承故障的因果链清晰;反之,若拿一个弱相关的代理指标做决策,状态修就退化成玄学。
陷阱叫数据漂移。模型是在历史故障数据上训练的,而运营条件在变:新车型、新线路、极端天气年份,都会让历史分布失真。成熟的智能运维体系都保留计划修的兜底周期,把状态修与预测修的结论作为"提前或延后"的调整量,而不是完全取代周期——用数据的增量修正经验的基线,而不是推翻基线,这是工程与论文的区别。
本节要点回顾
- 运维的最高目标是恰当时间最小拆动,过度检修本身是故障源,检修窗口直接吃运力;
- 四种体制按触发条件排成演化链:事后修、计划修、状态修、预测修,铁路现处计划修为体、状态修为用的混合态;
- 状态修的两个前提:检测覆盖率与指标有效性,轴温探测是因果链清晰的成功范本;
- PHM 闭环四层:感知、汇聚、分析、决策执行,成熟度取决于最短的板;
- 数据漂移是预测模型的天敌,实务做法是数据修正经验基线,保留计划修兜底周期。
常见问题
问:既然要预测性维护,还考传统检修资质和经验有必要吗?
答:有必要,而且更重要。模型给出的是"哪个部件大概多久会越线",把它变成具体的天窗作业计划、配件批次核对、拆装工艺执行,全是传统工艺经验的地盘。数据智能淘汰的是"凭手感判断何时修"这一环的垄断地位,判断的验证与执行反而更需要懂设备的人。
一个轴承的预测性维护之旅
用一个具体部件走完预测性维护的全流程。动车组轴箱轴承,车载温度与振动传感器每秒采集数据,随车记录;健康平台把它的温度曲线与同型件群体基线比对,三个月前出现轻微的温漂,振动特征谱里出现一个新生的窄带峰值——单看都在阈值内,趋势模型却判定这是滚道早期剥落的特征,预测四十天后触及告警线。系统自动生成检修建议:不紧急、可等下一个计划天窗,建议更换并留件分析。
作业当天,维修组按建议在计划天窗内完成更换,旧轴承送实验室解剖,确认了早期剥落诊断。解剖结论回写案例库,模型的特征权重得到一次真实标注——闭环的最后一步。这个案例的每个环节都有 counterparts:没有车载传感,就没有数据源;没有群体基线,单点温漂会被当作正常;没有趋势模型,告警会在四十天后才响;没有天窗计划接口,发现也没法变成作业。预测性维护不是一套算法,是一条流水线,算法只是其中最容易被看见的那一节。
检修等级的账
动车组的计划检修按走行公里分等级:较低等级以检查、清洁、功能试验为主,在天窗与库停时间内完成;中等级别增加部件更换与转向架检修,占用一至两天;最高等级接近深度解体,部件大修与车体整修并行,耗时以周计。等级越高,单次成本越高、频次越低,总成本曲线呈锯齿状分布。智能运维的价值在这个结构里看得最清楚:状态数据让部分低级修的检查项目被在线监测替代,让部分部件的更换从"到公里就换"变成"看状态再换",锯齿的峰值被削低、谷值被填平——总量省下的,就是 5.2 节说的过度检修成本。
修程优化的难点在于证据门槛:把一个周期性项目改为状态修,要拿出充分的可靠性数据证明风险不升,审批链条很长。务实路径是"先试点后推广":在管理规范的段先行,积累两个修程周期的数据对比,再进规程修订。修程是安全规章的一部分,改它的成本本身就是安全冗余的一部分——智能运维的账要这么算才算得诚实。
智能运维的核心挑战在于把海量检测数据转化为可操作的维修决策——这需要建立从数据到决策的完整链路。第一层是数据采集:轨检车、探伤车、综合检测列车每周跑一遍全路网,采集轨道几何、钢轨表面伤损、接触网导高拉出值等数千个参数;第二层是数据分析:把历次检测数据做趋势分析——某区段的轨距变化率持续偏高,说明道床稳定性在退化;第三层是维修决策:根据退化速率和安全阈值,自动生成维修工单并排入天窗计划。这条链路的难点在于第二层——不同检测数据的采样间隔不同、精度不同、对行车安全的权重也不同,需要建立一个统一的评估模型。中国铁路的牵引供电检测、工务检测、电务检测分别由不同部门管理,数据共享和融合是实现真正智能运维的最大组织障碍。