1.2 四种代谢组学范式
1.2 四种代谢组学范式
非靶向、靶向、通量组、脂组学是代谢组学的四种主要做法。它们的差别不在于仪器,而在于你要回答的问题:是"有什么不一样"(发现),还是"差多少"(定量验证),还是"流量走哪条路"(动态追踪)。
选范式就是选问题
很多新手纠结"该买哪个平台",其实第一问应该是"我要回答什么问题"。四种范式对应四类问题,代价结构完全不同:
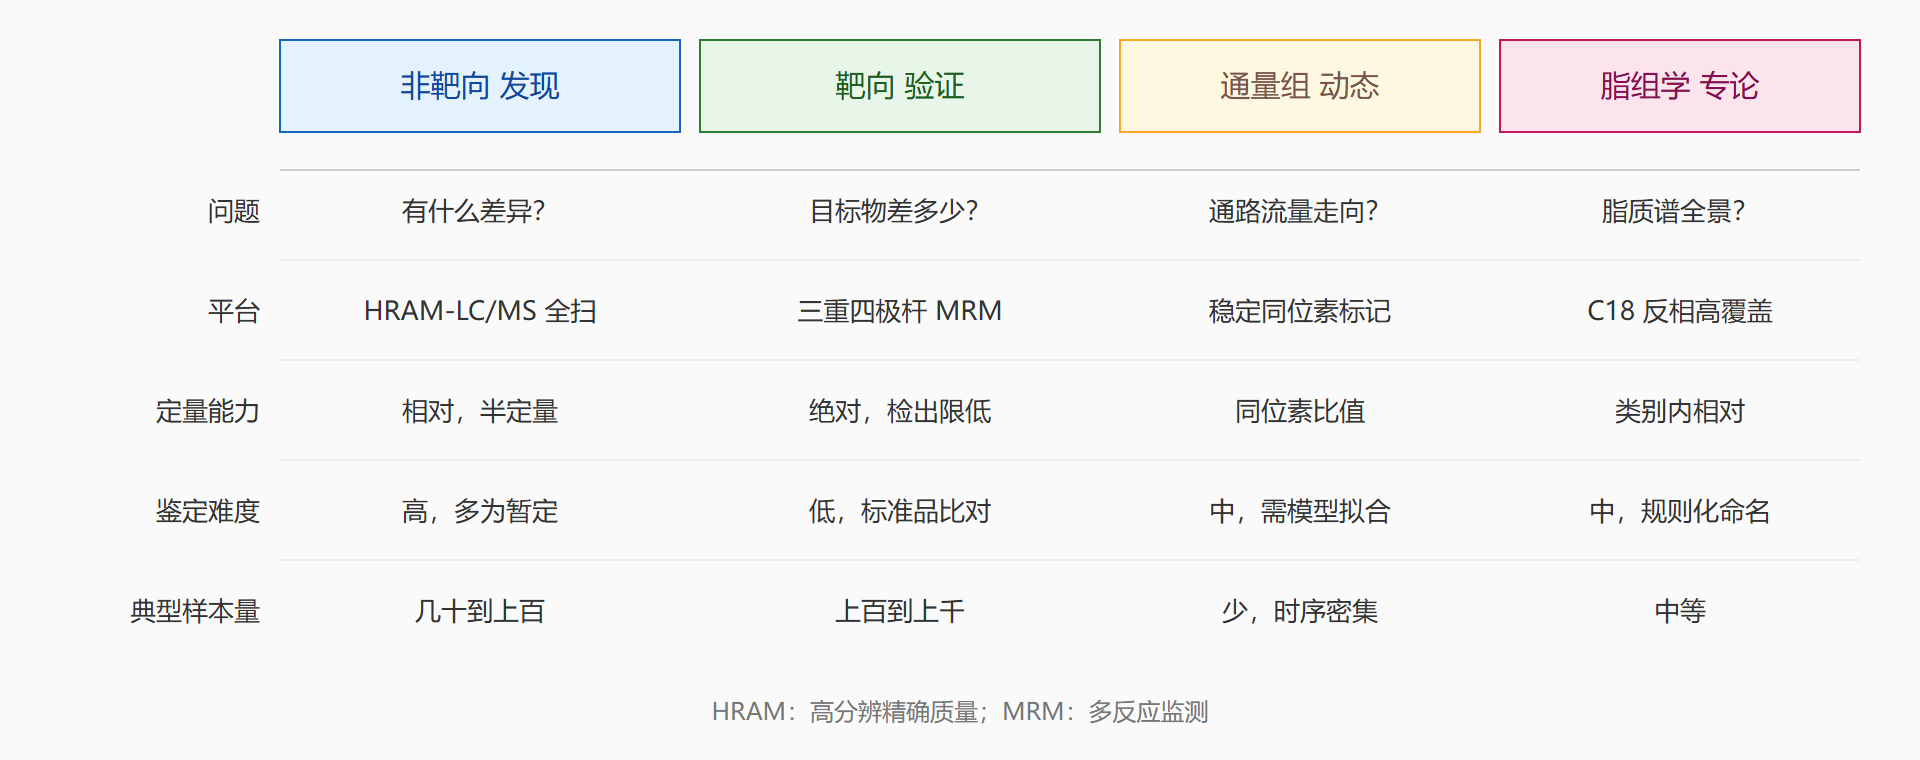
四范式对比矩阵
各自的典型剧本
非靶向:你不知道该测什么。血浆全扫一遍,捞出一批差异特征,回去鉴定——发现期工具,广但糙。
靶向:你已知要测 40 种氨基酸或 200 种脂质。三重四极杆逐个母离子→子离子对定量,配标准曲线,报告浓度单位是 μmol/L 而不是"峰面积"。临床检验的氨基酸筛查就是这一类。
通量组(fluxomics):给细胞喂碳-13 标记的葡萄糖,在不同时间点追踪同位素在代谢网络里的去向,反推通路流量。样本少、时间点多,数学模型重。
脂组学:脂质结构有"头基 + 碳链 + 双键"三维命名空间,种类爆炸(数万级),演化出专门的提取流程(MTBE 法)与命名规则,实际上已自成一家。
💡 关键直觉:范式之间是接力关系不是竞争关系。一篇高质量研究往往是"非靶向发现 → 靶向在独立队列验证"两段式,直接拿非靶向数据做临床结论是审稿人最爱打的靶子。
本节要点回顾
- 范式选择由问题决定:发现选非靶向,定量选靶向,动态选通量组,脂质深挖选脂组学
- 非靶向广而糙:相对定量、鉴定多为暂定注释
- 靶向窄而准:绝对定量、低检出限,但只能测名单上的
- 两段式设计(发现+验证)是应用研究的标准姿势
- 脂组学因命名空间爆炸独立成军
下一节解释这套工具为什么值得用——代谢物离表型到底有多近。
四种范式的决策树与成本账
非靶向(untargeted)、靶向(targeted)、通量组学(fluxomics)、空间代谢组学(MALDI/DESI 成像)四条路线不是学术分类,而是项目启动时的预算决策。用一张成本-信息量表来定夺:
| 范式 | 单样本质谱成本(相对) | 可注释代谢物数 | 信息类型 | 适用问题 |
|---|---|---|---|---|
| 非靶向 LC-MS | 1 | 10²–10³ | 相对丰度,发现导向 | 未知机制探索 |
| 靶向 MRM | 0.3–0.8 | 10¹–10² | 绝对浓度,高精度 | 假设验证、临床检验 |
| 通量组(¹³C 标记) | 3–10 | 10¹ | 速率信息 | 通路活性、重编程 |
| 空间成像 | 5–20 | 10¹–10² | 空间分布 | 组织异质性 |
决策的经验法则:若研究问题是"有没有差异、差异在哪",先跑小规模非靶向(每组 8–10 个生物学重复足够看到大效应);若问题是"某通路是否上调、上调多少",直接上靶向。最贵的错误是非靶向结束后再回头做绝对定量——两套仪器方法、两轮样本,成本翻倍。越来越多的实验室采用"warm-up 非靶向 + 靶向收尾"的两段式设计,第 3 章的统计功效节会给出样本量公式。
用小矩阵演示四种范式问出的问题
# 同一份数据,四种范式各自提取不同信息 # 行:样本;列:柠檬酸、α-酮戊二酸、谷氨酸(uM,模拟) data = [[182, 35, 610], [175, 33, 595], [190, 38, 640], # 对照 [210, 52, 700], [225, 55, 715], [205, 49, 690]] # 敲除 ctrl, ko = data[:3], data[3:] for j, name in enumerate(["柠檬酸", "aKG", "谷氨酸"]): mc = sum(r[j] for r in ctrl)/3 mk = sum(r[j] for r in ko)/3 print(f"[非靶向视角] {name}: 变化 {(mk/mc-1)*100:+.0f}%") ratio = lambda a, b: sum(r[a] for r in ko)/sum(r[a] for r in ctrl) / (sum(r[b] for r in ko)/sum(r[b] for r in ctrl)) print(f"[通量视角] 柠檬酸/aKG 比值变化 {ratio(0,1)-1:+.0f}% → TCA 中段阻滞线索") print(f"[靶向视角] 谷氨酸绝对浓度 {sum(r[2] for r in ko)/3:.0f} uM," f"是否超过文献参考区间需查 HMDB")
同一份数据,非靶向看到"三个都升了",通量视角看到"比值失衡",靶向视角回答"绝对浓度是否病理区间"。四种范式不是技术 rival,而是同一数据立方体的不同切面——成熟的代谢组学论文往往组合两个切面,一个负责发现、一个负责定量确认。
边界情况:范式之间的灰色地带
半靶向(widely targeted)方法近年兴起:用约 500–2000 个 MRM 离子对的大面板同时兼顾覆盖面与定量精度,介于两栏之间。选择它的场景是"样本珍贵且不允许重测"的临床队列。此外拟靶向(pseudo-targeted)先用非靶向建库再转 MRM,兼顾发现与验证,是国内多个团队推广的路线。范式选择没有唯一正解,只有与科学问题、样本量、预算的匹配度。
范式选择的反例集
清单之外,四种"失败选择"同样有教学价值。反例一:临床试验终点用非靶向收尾——非靶向的相对丰度无法满足药监部门对绝对定量的要求,方案会在注册阶段被退回。反例二:微生物短时程扰动研究用靶向面板——菌群-宿主互作的代谢物空间未知,两百个预定离子对大概率错过新信号,发现型问题配发现型工具。反例三:组织切片的空间异质问题用匀浆测——匀浆把空间信息平均掉,答非所问。反例四:预算只够单平台却追求"全谱"结论——覆盖残缺的全谱比聚焦的半谱更误导。每个反例的共同病灶是"工具先行于问题",范式表的正确用法是先写清科学问题与决策需求,再倒查表格。
# 用规则脚本练习范式判断(可换成自己的项目描述) def choose(novel_signal, absolute_quant, spatial, flux): if flux: return "通量组学(13C 标记 + 时间序列)" if spatial: return "空间代谢组学(MALDI/DESI 成像)" if not novel_signal and absolute_quant and n_targets := 40: return "靶向 MRM 面板" return "非靶向发现 + 靶向验证两段式" print(choose(novel_signal=True, absolute_quant=False, spatial=False, flux=False)) print(choose(novel_signal=False, absolute_quant=True, spatial=False, flux=False)) print(choose(novel_signal=False, absolute_quant=False, spatial=True, flux=False))