7.2 数据科学与 AI 融合
7.2 数据科学与 AI 融合
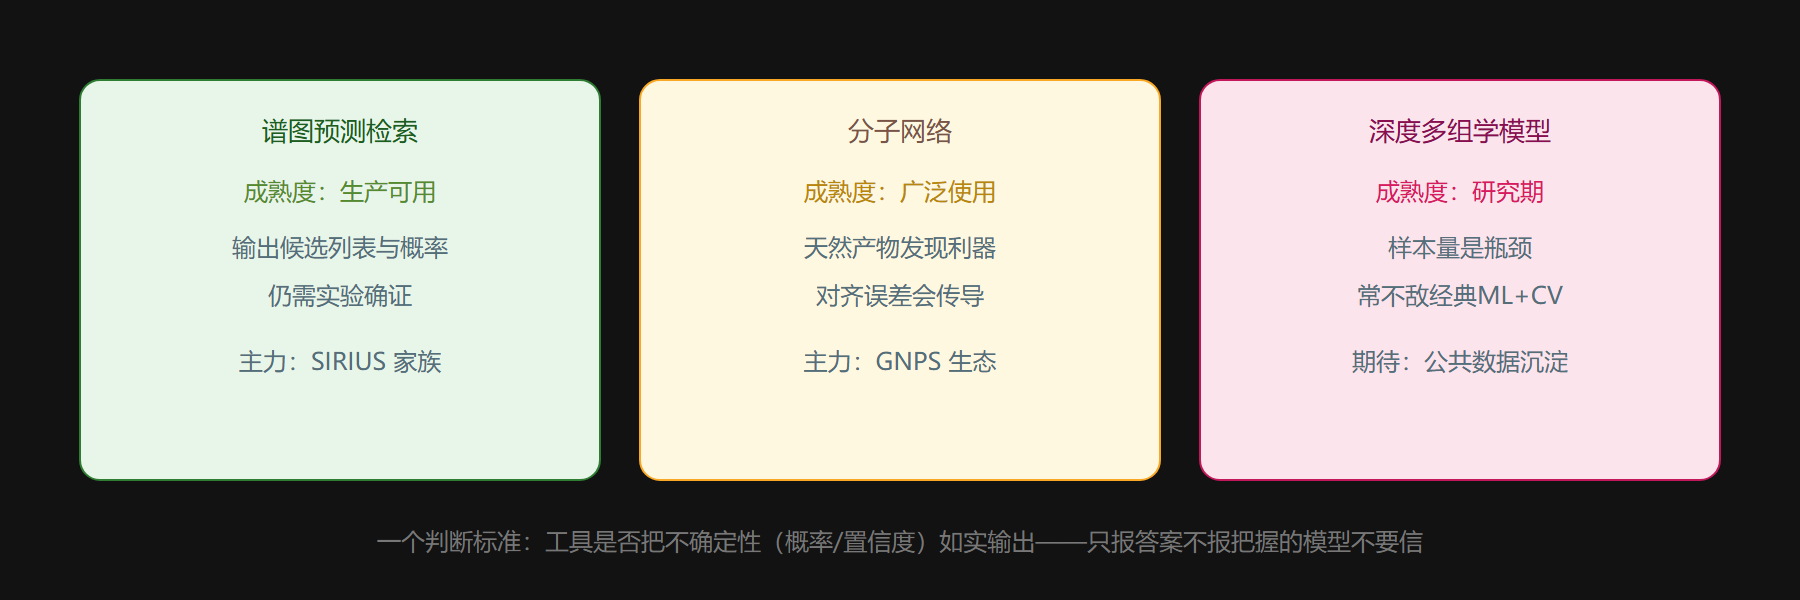
AI 在代谢组学里不是单一技术,而是三类具体角色:给谱图当翻译(碎裂谱预测与检索)、给数据当侦探(分子网络与无监督结构发现)、给多组学当整合者(跨模态模型)。每一类都有真实战果,也都埋着过度承诺的雷。
角色一:谱图预测——给匿名峰算出可能的身份
实验谱库(MassBank、NIST)只覆盖已知物的一小部分。计算碎裂谱预测(CANOPUS/SIRIUS 的碎片树推理、基于深度学习的预测器)能对没进过谱库的分子给出候选结构与类别概率。实战定位:不是替你鉴定,而是把"完全未知"变成"带概率的候选清单",实验再验证。CSI:FingerID 类工具在植物次生代谢(谱库覆盖极低)里的价值最明显。
角色二:分子网络——用谱图相似度聚类匿名峰
GNPS 的思想:两个特征的碎裂谱余弦相似度高,结构大概率相近。把全部特征的相似关系连成网络,差异分析从"单个峰"升级为"整个家族亮了"——某个差异峰的邻域全是上调的同类物,注释一次、全家受益,即使家族成员从未进过谱库。
# 概念示意:分子网络的核心一步 import numpy as np def cosine(a, b): return np.dot(a, b) / (np.linalg.norm(a) * np.linalg.norm(b)) # 对所有特征对的MS2向量算cosine,>0.7连边 # 下游:差异分析按"家族/模块"统计,而不是按单个m/z
角色三:多组学整合与预测模型
深度模型跨模态对齐(代谢组+转录组+菌群 16S)做表型预测,方法上延续 4.4 节 mixOmics 的思路但表达力更强。诚实的现状:在几百样本量级的代谢组学上,精调的深度模型对阵带交叉验证的随机森林,优势常常不显著——数据量才是瓶颈,不是模型容量。
AI 三角色的成熟度地图
⚠️ 常见坑:训练与测试数据存在批次或来源泄漏(同一仪器、同一队列分两半冒充独立验证),AI 论文里 AUC 虚高的头号原因。代谢组学样本量小,泄漏后果被放大——审稿时先查数据划分,再看模型架构。
本节要点回顾
- 三类角色:翻译(谱图预测)、侦探(分子网络)、整合者(跨模态模型),成熟度依次递减
- 谱图预测输出的是候选不是结论,实验确证不能省
- 分子网络按家族做差异分析,是天然产物领域的标配
- 深度模型的瓶颈是样本量,不是架构
- 警惕数据泄漏:划分方式比模型选择更能决定报告的可信度
下一节直面整个领域的老问题。
从谱库检索到深度学习:注释自动化的四级台阶
第一级是确定性匹配(m/z + RT + 谱库余弦),第二级是分子网络传播(GNPS),第三级是机器学习预测 CCS 与 RT(把"测得到的性质"变成过滤器),第四级是深度学习直接从结构预测碎裂谱(如 ICEBERG、MassFormer 一类模型),反过来对候选结构逐个"合成"理论谱再比对。第四级在 2023 年后把 Level 2 注释的假阳性率压低约一半,是近年最实质的方法学进步。
# 深度谱预测辅助注释的决策示意:候选结构与实测谱的余弦相似度 cands = {"候选A(正确结构)": 0.93, "候选B(同分异构)": 0.71, "候选C(错误分子式)": 0.35} for name, s in cands.items(): verdict = "高置信" if s > 0.85 else ("存疑" if s > 0.6 else "排除") print(f"{name}: 谱相似度 {s:.2f} → {verdict}") # 关键改进:传统余弦只在候选B/C间勉强区分(0.4 以下), # 预测谱加入相对峰强信息后正确结构稳定 >0.9
FAIR 与可复现:AI 时代的地基
模型再好,输入的峰表不可复原则一切归零。社区的三层基建:数据层(MetaboLights、Metabolomics Workbench 存原始 mzML 与 metadata)、标准层(ISA-Tab 格式、msPurity 质控指标)、模型层(openNPA、MetaboAnalystR 的可复现 notebook)。一个务实的自查:把论文的方法节交给第三方,能否仅凭文字复现峰表?多数现况是不能——参数(XCMS 版本与全部参数、随机种子、QC 过滤阈值)不齐是主因。AI 融合的真正前沿不在模型架构,而在让"数据-代码-参数"三件套成为论文的默认附件。
AI 融合的另一个提醒是数据的"时代漂移":训练于旧仪器、旧方法谱库的模型,迁移到新平台后性能悄然下降,且没有报错。防御做法是模型上线即监控——定期用 QC 样本的预测分布做漂移检测(如 PSI 指数超 0.2 触发重训)。把机器学习模型当"需要年检的仪器"而非"一劳永逸的公式",是代谢组学 AI 工程化的观念门槛。
AI 融合还有一个容易被乐观情绪掩盖的边界:代谢组学的样本量量级(几十到几百)远小于深度学习的胃口,大多数"深度学习注释代谢物"的论文实际靠的是迁移学习与数据增强撑起来的谱库预训练。这意味着模型在谱库覆盖密集的脂质与氨基酸区表现好,在化学空间的冷区(环境未知物、天然产物)依然退化到传统方法水平。使用者的正确姿势是把 AI 输出当作"优先级排序器"——它把候选从一千个排到前十个,最后的确认仍要人工谱图比对或标准品实验。把 AI 当加速器而非裁判,是目前样本量约束下唯一诚实的定位。
模型的化学一致性检验同样不能省略:预测保留时间、碰撞截面或碎片谱的深度学习模型,在测试集上报告的 MAE 必须换算为相对偏差并与仪器的固有质量轴稳定性比较——若模型误差已低于仪器漂移,再压低误差只是过拟合数字游戏。开源基准(如 CASMI 竞赛数据集)是检验自训模型泛化能力的低成本途径,每季度跑一次外部盲测并记录成绩,是 AI 工具能被质谱社区接受的最低诚信线。
人机分工的边界也应写进操作规程:AI 负责从上万特征中筛出前 50 个候选注释,人工只复核这 50 个的谱图与保留时间,两小时内可完成;若反过来让人工浏览全特征表,同样的复核质量需要两天。把"模型初筛、人工终审、抽样回测"三段写进 SOP,并保留每一次人工改判的记录,AI 融合才能真正缩短周期而不引入不可见的注释债务。