8.1 数据资源与工具生态
8.1 数据资源与工具生态
代谢组学的公共生态分四层:化合物知识库(这个分子是什么)、谱库(它的谱长什么样)、通路库(它在哪个网络里)、数据存证库(研究数据放哪)。工具链则围绕 R/Python 的几个核心包构成。
资源地图
数据库四层地图
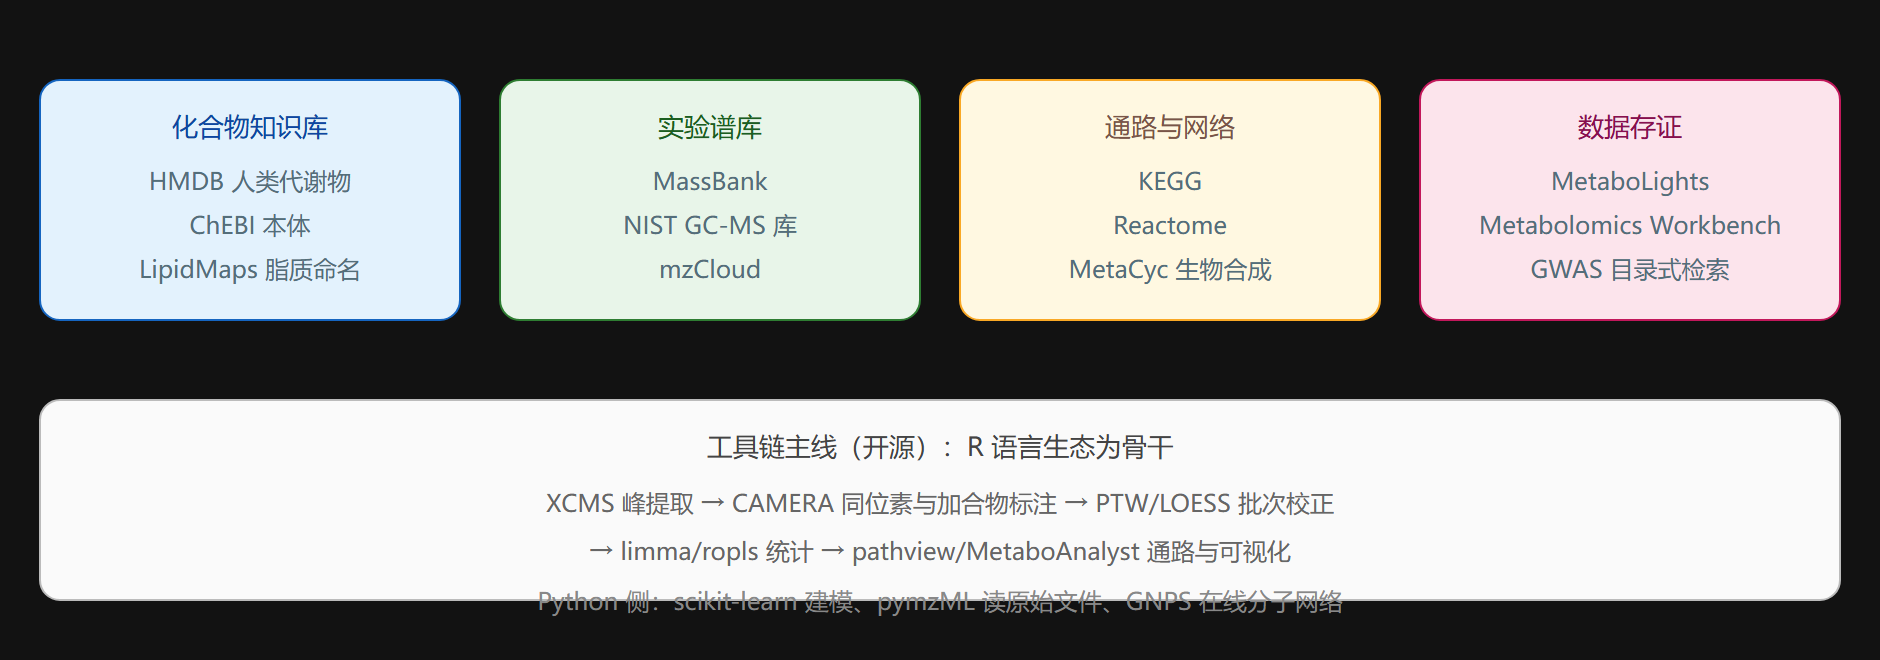
选型上我的倾向:处理层 XCMS 或 MZmine 二选一(前者脚本化可复现,后者图形界面易上手),统计层留在 R(limma + ropls 组合覆盖 90% 需求),一体化网页工具 MetaboAnalyst 适合教学与快速预览——但论文级分析必须落在脚本里,网页点出来的结果无法逐参数复现(7.3 节债务三)。
版本与引用礼仪
数据库和工具都在持续更新,HMDB 的条目数、KEGG 的通路注释逐年变化。方法学里写清版本号与访问日期,是让三个月后的自己(和审稿人)能对上结果的最低要求。工具用了就引用——XCMS、MetaboAnalyst 这些工具的论文引用量就是它们的经费生命线。
⚠️ 常见坑:直接把数据库注释当结论。HMDB 的"detected and quantified"标注并不等于在你的样品里确证——注释工具把 m/z 匹配到库里的疾病相关代谢物,中间隔着 5.2 节整条置信度阶梯。
本节要点回顾
- 四层资源:化合物库、谱库、通路库、存证库,各有分工
- 工具链骨干在 R:XCMS + CAMERA + limma + ropls + pathview
- 论文级分析必须脚本化,网页工具只做预览
- 版本号与访问日期写进方法学
- 注释不等于结论,置信度阶梯随时在场
下一节讲这些数据能共享到什么程度。
工具地图按流程段排列
原始数据处理:XCMS/MSnbase(R)、MZmine、MS-DIAL——三者功能重叠,社区按语言偏好与图形界面需求分流。注释与谱库:GNPS/MassBank/HMDB/METLIN,加上 SIRI/CSI:FingerID 做计算预测。统计分析:MetaboAnalyst(网页与 R 双形态,事实标准)、ROCR/biosigner 做特征选择。通路:Mummichog、MetaboAnalyst 通路模块、KEGG/Reactome 接口。工作流封装:Nextflow/Snakemake 与 Galaxy 代谢组学轨道,把上述工具串成可复现流水线。
| 资源 | 类型 | 规模/状态 | 在流程中的位置 |
|---|---|---|---|
| MetaboLights | 数据库(EBI) | 数千研究、FAIR 元数据 | 数据存放 |
| Metabolomics Workbench | 数据库(NIH) | 与论文投稿联动 | 数据存放 |
| GNPS | 谱库+分子网络 | 数十万光谱 | 注释 |
| MS-DIAL | 软件 | 免费开源、持续更新 | 峰表+注释 |
| MetaboAnalyst | 网页工具 | 全流程统计 | 统计与通路 |
用公开数据做方法对照:一个起步练习
# 下载 MetaboLights 公开研究(示意编号 MTBLS1 类)后先做三件核查 checks = { "原始数据在库(mzML 而非仅峰表)": True, "含 pooled QC 与运行顺序表": True, "提供 ISA-Tab 完整元数据(含仪器参数)": True, "报告了 QC 的 CV 分布": False, } score = sum(checks.values()) print(f"FAIR 自查 {score}/{len(checks)}") # 四项里缺"CV 报告":复现峰表可行,但评估数据质量需自己重算
工具生态的选型原则是"社区最大者优先":XCMS 与 MetaboAnalyst 的教程、论坛答案与错误案例最多,新手的时间成本最低;小众工具(某些付费平台的自带软件)可能在单项功能上更强,但出问题时无处求助。长期看,把流程封装进 Snakemake/Nextflow 的实验室,三年后仍能一键复现当年结果——工具生态章的落点不是罗列软件,而是搭建"自己实验室的流水线资产"。
从工具到流水线:一个最小 Snakemake 骨架
# 伪代码示意:把四段工具串成可复现流水线 rules = [ ("raw_to_mzml", "msconvert vendor.raw --mzML"), # ProteoWizard ("peaktable", "xcms centWave ppm=15 peakwidth=5,20"), ("annotate", "msdial -i peaktable -o annot.tsv"), ("stats", "MetaboAnalystR: PCA + PLSDA + 置换检验"), ] for name, cmd in rules: print(f"rule {name}: {cmd}") # 关键:版本号与全部参数写进 rule,重跑 = 一条命令
流水线化的收益在第三年显现:仪器升级、软件换代时,历史项目仍可整线重跑并对比差异。工具生态章的实践作业是把第 5 章的四个脚本封装成这样的骨架,作为实验室的第一份"代码资产"入库。
工具生态还有一个新手容易忽略的入口:每个主流工具的官方教程与内置示例数据。XCMS 的 faahKO 数据、MetaboAnalyst 的示例队列、GNPS 的教学谱库,都是作者团队精心挑选的"标准考题"——先在标准考题上复现教程结果,再处理自己的数据,遇到差异时才能区分"我的数据特殊"与"我的流程有错"。跳过这一步直接上手真实数据,排错时间平均翻数倍。工具生态不只是软件清单,还包括这些嵌在软件里的学习资产,善用它们是入门速度的最大杠杆。
工具选型还可以按维护活跃度过滤:过去六个月无提交、issue 无人回应的仓库,无论星标多少都应谨慎引入核心流程。一个务实的做法是把分析管线拆成"稳定层"(XCMS、MS-DIAL、MetaboAnalyst 这类多年维护的软件)与"实验层"(新发布的深度学习工具),实验层工具一律在容器中运行并锁定版本号,保证两年后重新执行仍能得到同一结果——可复现性本身就是数据生态的一部分。
资源引用也有规范可循:使用 HMDB 注释应注明版本号(不同版本间条目可增删两成),使用 GNPS 分子网络应报告参数文件与任务 ID。把"资源名+版本+访问日期"三要素写进方法学段落,是数据生态对使用方的最后一条互惠约定。