8.3 实验室最佳实践:一页项目清单
8.3 实验室最佳实践:一页项目清单
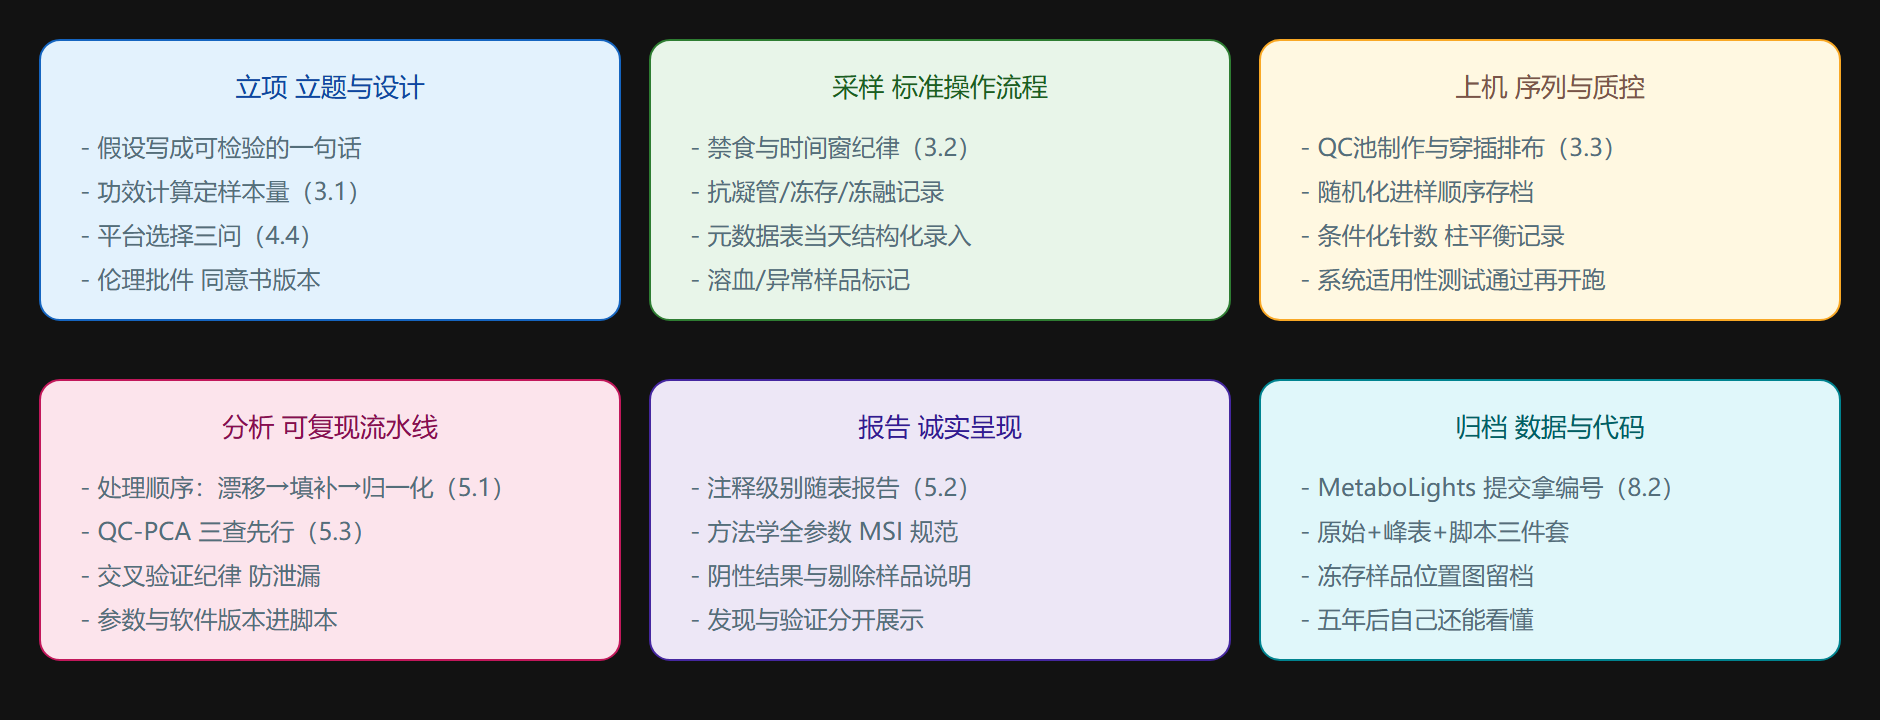
把全书的工作流压缩成一份可打印的项目清单:立项、采样、上机、分析、报告、归档六个阶段,每阶段列"必须做的"和"必须记录的"。它不教新知识,只防旧错误。
六阶段清单
项目生命周期一览
三条贯穿性纪律
纪律一:元数据先于数据。 采样当天录入结构化元数据表,比事后任何补救都便宜。字段至少含:样品编号、分组、性别年龄、采样日期时间、禁食时长、抗凝剂、冻融次数、操作者。
纪律二:版本即真相。 提取方案、上机方法、处理脚本全部带版本号,数据文件名里嵌版本。8.1 节说过的做法,这里再强调一次,因为它消灭的是"哪批数据用的哪个方法"这类永远扯不清的问题。
纪律三:QC 判断先于统计判断。 任何统计输出之前先看 QC:QC-PCA 聚团吗?RSD 分布达标吗?批次分开吗?QC 不过关的批次回去重跑,不要带病分析——带病的差异分析浪费的是后面所有人的时间。
新手上路的最小集
如果只允许记三件事:设计阶段想清楚验证路径(3.1)、采样阶段守住时间与温度(3.2)、分析阶段先交叉验证再相信模型(5.3)。其余细节可以查,这三条错了没有补救。
💡 关键直觉:最佳实践的本质不是"更严谨的美德",而是降低未来的成本——元数据、版本号、QC 存档都是写给三个月后那个记不清细节的自己(或接手的同事)的信。
本节要点回顾
- 六阶段清单:立项、采样、上机、分析、报告、归档,各有必做与必记
- 三条纪律:元数据先行、版本即真相、QC 先于统计
- 新手最小集三条:验证路径、时间温度、交叉验证
- 最佳实践 = 降低未来成本,不是道德表演
全书到此收束:从 1.1 的定义出发,你已经走完一份样本的完整旅程。接下来最好的学习,是拿一份公共数据(MetaboLights 上任何一项)把第 5 章流水线亲手跑一遍。
SOP 的最小完备集
一个代谢组学实验室的 SOP 至少覆盖八个环节:采样(时限、抗凝剂、分装)、储存(温度、冻融上限)、提取(溶剂配方、内标加入时机)、仪器(日检混合标样、质量窗)、序列设计(随机化+QC 频率)、数据处理(参数记录、QC 过滤)、注释(等级标注规范)、发布(原始数据+代码)。每份 SOP 的关键字段是版本号与生效日期——没有版本的 SOP 等于没有 SOP。
| 环节 | SOP 必含字段 | 常见缺陷 |
|---|---|---|
| 采样 | 时限、容器、稳定剂 | 时限写"尽快"不可执行 |
| 提取 | 溶剂比例、温度、内标时机 | 内标在离心后才加 |
| 仪器 | 日检项目与允收窗 | 只记"正常"不记数值 |
| 序列 | 随机化方案、QC 频率 | 顺序表事后补做 |
| 数据 | 软件版本+全部参数 | 只写软件名不写参数 |
用日检数据建立质控图
# 连续 20 天日检标样的某离子响应(归一化值) resp = [1.00, 0.99, 1.01, 1.02, 0.98, 0.99, 1.00, 1.03, 1.06, 1.09, 1.12, 1.15, 1.18, 1.16, 1.19, 1.22, 0.85, 1.24, 1.26, 1.28] import statistics as st mu, sd = st.mean(resp[:8]), st.stdev(resp[:8]) # 基线期 print(f"基线 {mu:.2f} ± {sd:.2f},控制限 [{mu-2*sd:.2f}, {mu+2*sd:.2f}]") for i, r in enumerate(resp[8:], start=9): if abs(r - mu) > 2*sd: print(f"第 {i} 天响应 {r:.2f} 越限 → 停机排查(清洗离子源/重调谐)") elif r > mu + sd and i >= 15: pass # 连续漂移趋势也需响应,见 Westinghouse 规则 # 第 17 天的 0.85 是单点失控,而 9-16 天是渐进漂移:两类失控的处理不同
质控图的判读规则(单点越限、连续同侧、渐进漂移)来自工业统计过程控制,代谢组学实验室直接继承。最佳实践的最后一公里是"异常的处置记录"——越限之后停了几针、重跑结果、受影响样本清单,全部落档。审计与复现要的从来不是"从不出问题",而是"出了问题可追溯"。
最佳实践的落地核对:开工检查单
# 新项目启动前的 10 项核对(打勾才开工) checklist = { "S1 采样时限写入方案": False, "S2 分装与冻融上限": True, "S3 内标种类与时机": True, "S4 序列随机化方案": True, "S5 QC 频率与 CV 门槛": True, "S6 数据处理参数卡": False, "S7 注释等级标注": True, "S8 原始数据归档计划": False, "S9 统计预注册(含样本量)": False, "S10 伦理批件与同意范围": True, } missing = [k for k, v in checklist.items() if not v] print(f"未就绪 {len(missing)} 项: {missing}") # 项目启动会的正确议题就是清空这张表
这张检查单浓缩了全书主线:设计(第 3 章)、平台(第 4 章)、数据(第 5 章)、伦理(本章第 2 节)最终都汇成开工前的一页核对。代谢组学的可靠性不依赖天才,依赖的是把正确的事情重复做对的组织能力——本教程以这句话收束。
全书以最佳实践章收束,还可以给一个组织层面的视角:实验室的质量体系成熟度大致分四级——口头传承(师傅带徒弟)、文档化(有 SOP 但版本混乱)、可追溯(台账与质控图齐全)、可复现(流水线与数据归档一体)。多数实验室卡在第二级向第三级的跨越上,卡点不是知识而是习惯势力——记录的三十秒总被"先做完实验再说"挤掉。破局的常见抓手是把记录动作嵌进流程物理路径(柱台账就挂在柱温箱旁、QC 图由脚本每日自动推送到群组),让"正确的事"成为"最省力的事"。管理的这条朴素原理,是本教程送给未来实验室负责人的最后一句话。
落地时可给每条 SOP 附上"偏离记录表":任何一次实际操作与文本的偏差(如离心延迟了 8 分钟、冻融多了一次)当场记入表格并随数据归档。审计经验表明,大多数事后无法解释的离群样本都能在这张表里找到对应条目;反过来,一张干净的偏离表本身就是数据可信度的最有力证明。最佳实践的终点不是文件柜里的装订册,而是每个数据点背后可回放的现场记录。