4.1 实验设计与高通量
4.1 实验设计与高通量
本节摘要:SOURCE 4.1:DOE 替代 one-factor-at-a-time;自动化微型生物反应器并行筛选;QbD 定义 CPP 对 CQA 影响。
动手:2³ 因子 DOE 示例
| 因子 | 低水平 | 高水平 |
|---|---|---|
| 温度 | 34°C | 37°C |
| pH | 6.8 | 7.2 |
| 补料速率 | 低 | 高 |
# 8 次实验 + 3 中心点 → 主效应与交互 # 响应:第 14 天滴度 g/L # 工具:JMP / Design-Expert / Python pyDOE2
为什么 one-factor-at-a-time 是陷阱
传统的单因子法(OFAT)一次只变一个因子,固定其他因子。它的三个致命缺陷:
- 忽略交互效应:两个因子单独改变都不显著,但组合改变可能显著。OFAT 结构上无法发现这种交互。
- 实验次数爆炸:3 个因子各 3 水平,OFAT 需要 1 + 3×2 = 7 次实验且只探索一条"线";而全因子 3³ = 27 次能探索整个"立方体"。因子一多,OFAT 的信息效率断崖式下降。
- 无法估计误差:没有重复与随机化,实验噪声被当成真实差异,结论可靠性无从谈起。
DOE(实验设计)的统计学根基正在于此:用随机化抵御未知干扰,用重复估计纯误差,用分式因子在信息与成本间权衡。结果不再是"改了什么变好了",而是"哪些因子显著、哪些交互存在、最优区域在哪里"。
2³ 因子设计:主效应与交互
以温度、pH、补料速率三个因子为例,2³ 全因子共 8 次实验(+中心点重复)。每个因子的主效应 = 高水平平均响应 − 低水平平均响应;交互效应则需要跨因子对比。用 Python 可直接完成全部分析:
# doe_analysis.py —— 2^3 因子设计分析骨架 import numpy as np # 8 个角点实验的响应(第14天滴度 g/L),按标准序排列 design = [ (-1,-1,-1), (1,-1,-1), (-1,1,-1), (1,1,-1), (-1,-1,1), (1,-1,1), (-1,1,1), (1,1,1), ] y = np.array([2.1, 2.9, 2.3, 3.1, 2.6, 3.5, 2.8, 3.8]) # 滴度 effects = {} for col in range(3): plus = [y[i] for i, d in enumerate(design) if d[col] == 1] minus = [y[i] for i, d in enumerate(design) if d[col] == -1] effects[f"因子{col+1}主效应"] = sum(plus)/len(plus) - sum(minus)/len(minus) # 1-2 交互项 inter = [(0,1),(0,2),(1,2)] for a, b in inter: p = [y[i] for i,d in enumerate(design) if d[a]*d[b] == 1] m = [y[i] for i,d in enumerate(design) if d[a]*d[b] == -1] effects[f"因子{a+1}x因子{b+1}"] = sum(p)/len(p) - sum(m)/len(m) for k, v in sorted(effects.items(), key=lambda x: -abs(x[1])): print(f"{k}: {v:+.2f} g/L")
输出中效应绝对值越大越重要。交互项显著说明"温度的影响取决于补料速率"这类复杂关系,单因子优化必然漏掉。
响应面法:从显著到最优
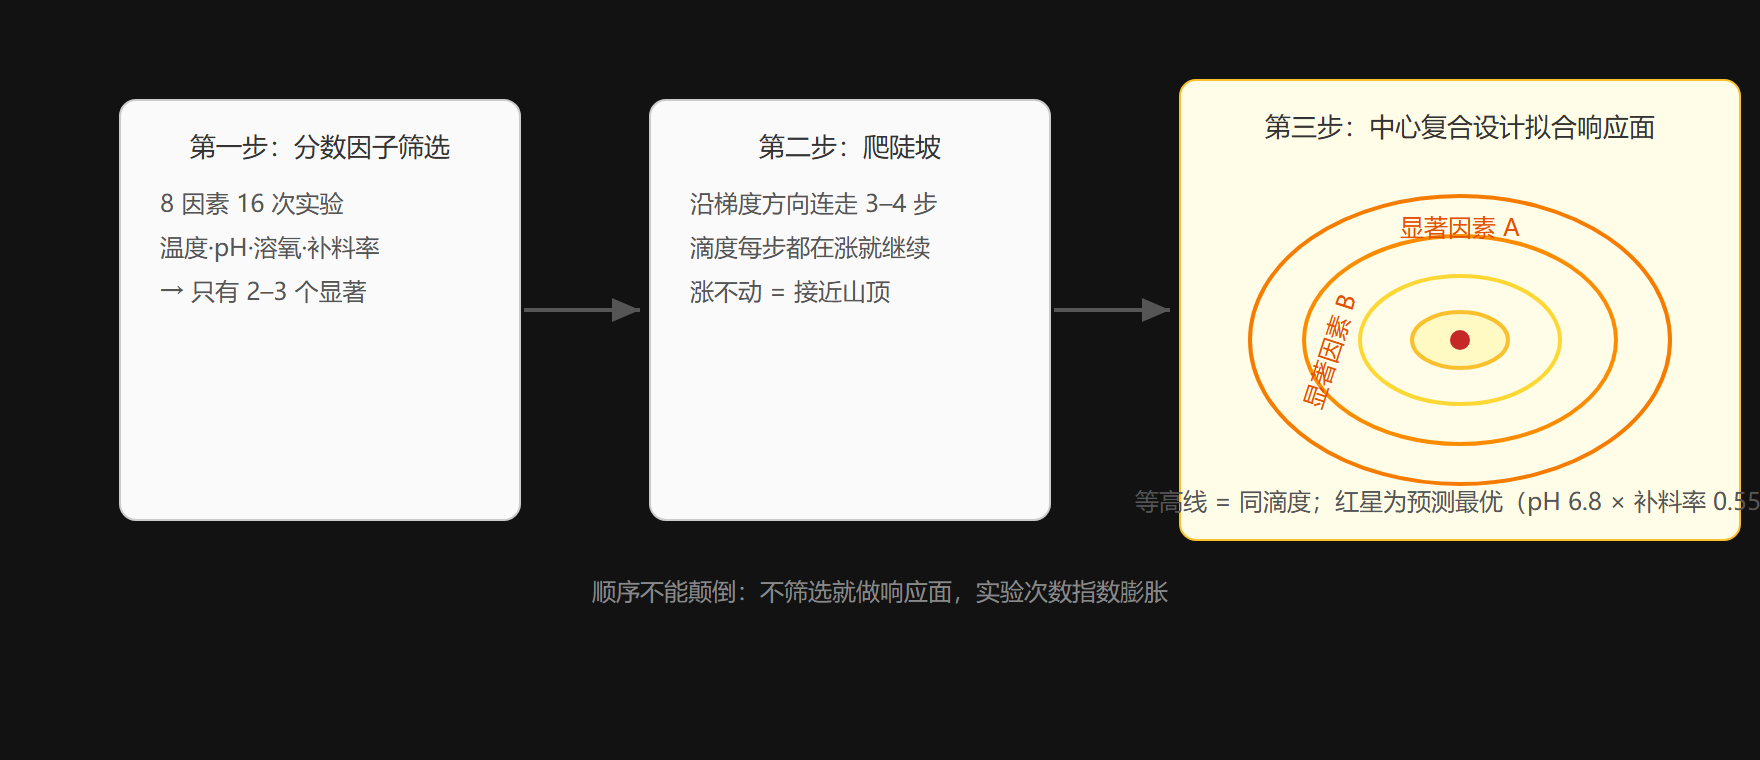
因子设计只能指出"哪些因子重要";要找最优组合,需要响应面法(RSM)。常用中心复合设计(CCD)在因子空间的角点、轴点与中心点布点,拟合二阶多项式响应面:
响应 = b0 + b1·T + b2·pH + b3·F + b12·T·pH + ... + b11·T² + ...
对响应面求梯度为零的点,即得预测最优区。RSM 的价值在于把"最优区域"从离散的水平组合扩展为连续的设计空间——这正是 QbD 概念的基础:设计空间内的参数扰动,都应有可预测且可接受的响应。
响应面法:从因素筛选走到最优点
高通量:把月压缩成周
高通量平台(自动化微型生物反应器、微流控芯片、机器人工作站)把传统数月的实验工作量压缩到数周。其价值不在于"自动化跑实验"本身,而在于让 DOE 得以规模化执行:
- 传统 8 个条件的 DOE 需要 8 个反应器串行跑 8 轮,耗时数周;
- 高通量系统可并行跑 48–96 个微型反应器(mL 级),一轮完成,且带在线 DO/pH 控制。
但高通量有个前置条件:微型反应器与生产尺度的相关性必须已被验证。微型系统的传质、剪切、蒸发特性与生产罐差异巨大,未经验证的"高通量结果"可能把整个优化引向歧途。成熟的方案会用一组代表性条件做规模桥接实验,确认微型与生产尺度的响应一致后,再放开高通量筛选。
中心复合设计与分式因子:成本与信息的权衡
全因子设计的实验次数随因子数指数增长(3 因子 8 次、6 因子 64 次)。因子超过 4 个时,工业界普遍转向两类缩减策略:
- 分式因子设计(fractional factorial):只跑全因子的一半或四分之一,牺牲高阶交互项的估计,换取实验次数减半。前提是"高阶交互通常不显著"这一工程假设成立。2⁶⁻² = 16 次实验就能估计 6 个因子的主效应与主要二阶交互,比全因子的 64 次节省 75%。
- 中心复合设计(CCD):在角点、轴点与中心点布点,适合在确定关键因子后做响应面。轴点的存在让二阶项(曲率)可估计,代价是轴点可能超出实际可操作范围(如负浓度无意义),需按实际边界做标度变换。
选型原则可以概括为:筛选阶段用分式因子,优化阶段用 CCD/响应面。两阶段衔接时,前一阶段筛选出的显著因子直接成为后一阶段的设计因子,非显著因子固定在经济水平。
用效应量而不是 p 值做工程判断
DOE 分析容易陷入"看 p 值"的误区。p 值回答"效应是否显著区别于噪声",但显著不等于重要:一个 p<0.05 的效应可能只有 0.1 g/L,工程上无意义。正确做法是同时看两个量:
- 效应量:主效应/交互效应的绝对值,直接对应该参数改变一个水平带来的响应变化;
- 帕累托图:把所有效应按绝对值降序排列,直观看出"头部的少数效应贡献了绝大部分响应"。
把效应量与工艺经济性挂钩,才能把统计语言翻译成决策语言:一个使滴度提升 0.5 g/L 的温度效应,若其操作范围让放热负荷翻倍,就要重新权衡。代码层面,可用 statsmodels 完成完整分析:
# doe_full.py —— 含交互与曲率检验的完整分析骨架 import numpy as np from statsmodels.formula.api import ols # 6 因子分式设计(此处示意 3 因子全因子 + 中心点) design = [(-1,-1,-1),(1,-1,-1),(-1,1,-1),(1,1,-1), (-1,-1,1),(1,-1,1),(-1,1,1),(1,1,1),(0,0,0)] y = np.array([2.1,2.9,2.3,3.1,2.6,3.5,2.8,3.8,3.0]) df = np.column_stack([np.array(design), y]) # 拟合一阶模型 + 交互项(示意) model = ols("y ~ A*B*C", data={ "y": y, "A": [d[0] for d in design], "B": [d[1] for d in design], "C": [d[2] for d in design], }).fit() print(model.summary().tables[1]) # 查看各效应的 coef 与 p 值,结合效应量判断
提示:真实项目里还应在随机顺序下补跑重复实验,用中心点标准差估计纯误差,再评价各效应。
QbD 语境下的 DOE
在 QbD 框架下,DOE 不再只是开发工具,而是注册语言的一部分:每个 CQA 要能追溯到其影响的 CPP,每个 CPP 要有 DOE 支撑的操作范围,操作范围要落在设计空间内。这样监管审查时,工艺的"可调节余量"与"风险认知"都有数据背书。
⚠️ 常见坑:DOE 结果无重复验证——统计显著≠工艺稳健。
💡 关键直觉:实验设计是把试错变成可解析方程。
重点提炼
- OFAT 无法发现交互且实验次数爆炸
- DOE 识别主效应与交互
- RSM/CCD 将离散水平推广为连续设计空间
- 高通量缩短早期开发
- 高通量相关性验证是不可跳过的步骤
- QbD 将 DOE 结果写入注册资料