5.1 医药生物工艺
5.1 医药生物工艺
本节摘要:SOURCE 7.1:单抗、疫苗、mRNA、CGT;GMP 环境下 upstream/downstream 严格验证;CAR-T 工艺即产品。
动手:MAb 工艺骨架
| 步骤 | 典型条件 | 分析 |
|---|---|---|
| 种子扩增 | 摇瓶→WAVE | 无菌、代数 |
| 生产培养 | fed-batch 14d | 滴度、活力 |
| 收获 | 深层过滤 | 浊度、生物负荷 |
| 捕获 | Protein A | HCP、DNA |
| 精制 | 离子交换 | 聚体、糖型 |
上游:把活细胞变成产品源头
单抗(MAb)是医药生物工艺的"教科书产品",其上游工艺的核心是种子链(seed train)与生产培养的衔接。从工作细胞库(WCB)解冻,经过摇瓶、小反应器逐级扩增,最终接入生产罐,整个过程必须满足三个约束:
- 代数控制:扩增代数受最大允许传代数(MSPD)限制,超代数即废弃,以保证产物一致性与遗传稳定性。
- 无菌保障:任何一步污染都前功尽弃,因此培养基、管路、反应器全程执行灭菌验证与密封性检查。
- 在线监控:DO、pH、活细胞密度(VCD)全程记录,作为批次放行依据。
生产阶段以 fed-batch 为主流:14 天左右的培养周期内,通过补料维持营养供给,温度从 37°C 生长相切换到 31–33°C 生产相(低温促进折叠、减少聚体)。当代 CHO fed-batch 滴度已达 5–10 g/L,但滴度只是起点,糖型与聚体水平才是放行的关键。
下游:成本大头在这里
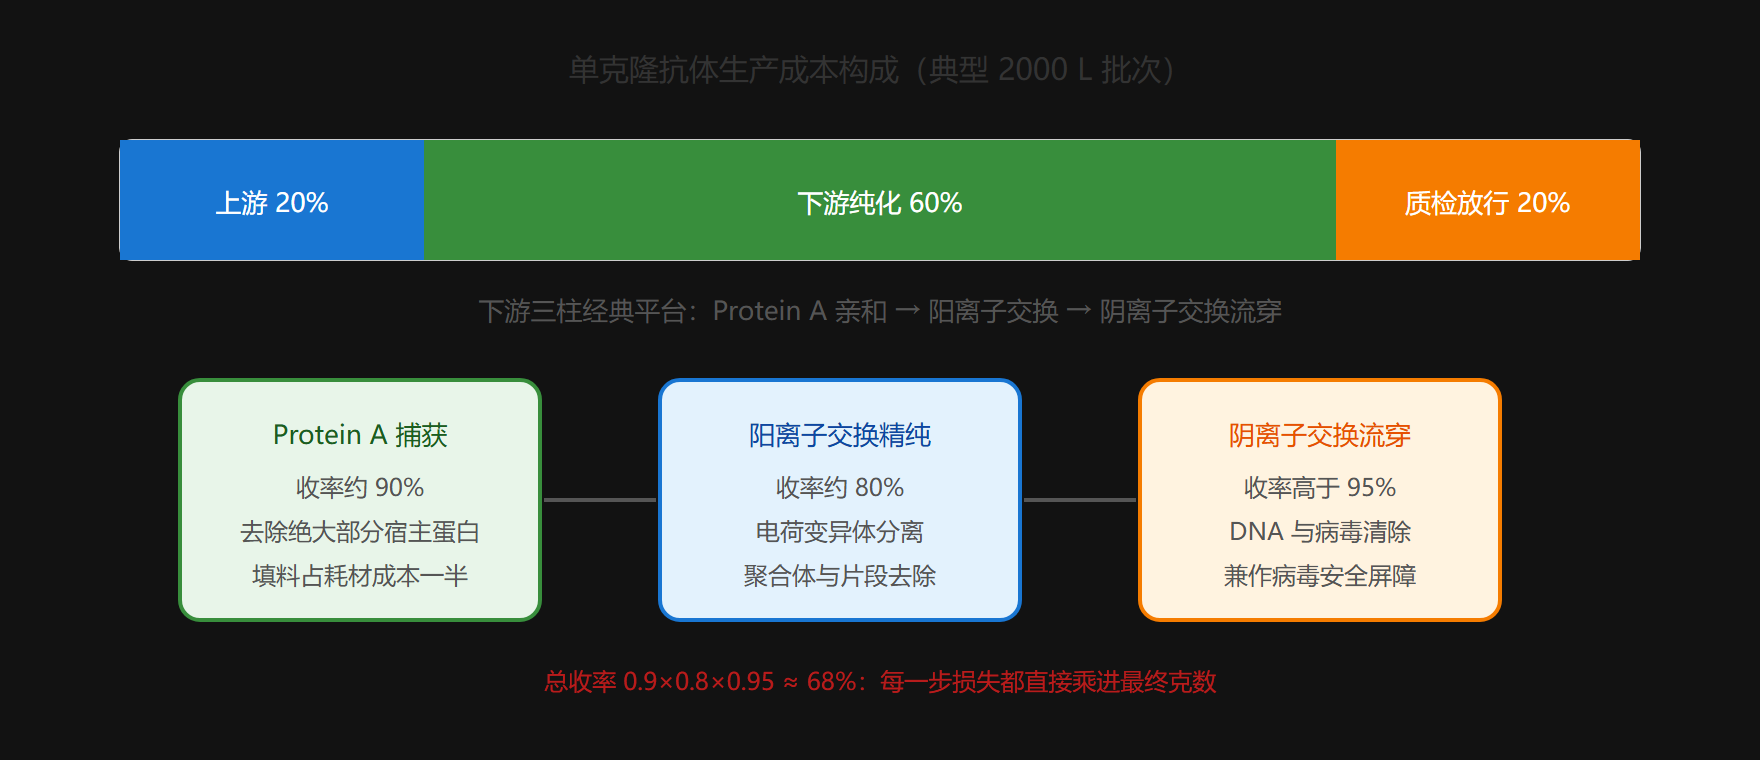
很多团队把精力集中在上游,但下游纯化与制剂占成本大头。单抗下游的经典平台是"Protein A 捕获 + 两步精制":
- 收获:深层过滤或离心去除细胞与碎片,控制浊度与生物负荷。
- 捕获:Protein A 亲和层析特异性地抓住抗体的 Fc 区,一步实现数百倍纯化,但需洗脱中和,且要控制 HCP(宿主细胞蛋白)与残留 DNA。
- 精制:阴/阳离子交换层析去除聚体、电荷变异体与残留 HCP;疏水层析或混合模式层析进一步精制。
- 病毒清除:低 pH 孵育与纳滤双保险,这是生物药特有的安全要求。
每一级纯化都有收率损失,整体收率是乘法的产物:上游滴度 8 g/L,收获 95%、捕获 90%、精制 85%、制剂 95%,总体回收约 69%——下游每提升 1 个百分点,都直接换算成产能。这也是"下游成为瓶颈仍只优化上游"为何是错误的工程直觉。
生物药成本结构:下游纯化占大头
疫苗、mRNA、CGT:同源不同构
- 疫苗:灭活/减毒疫苗靠病毒培养,重组亚单位疫苗靠表达系统(CHO、昆虫细胞、酵母),工艺核心是抗原质量与佐剂配方。质量控制关注残留宿主 DNA 与活性单位。
- mRNA 疫苗:2020 年疫情推动了整套工艺革命。体外转录(IVT)用 T7 聚合酶从 DNA 模板合成 mRNA,工艺要点包括 T7 表达效率、核苷酸池稳态(保持四种 NTP 比例)、加帽加尾效率,以及下游的连续纯化(层析 + 超滤)降低乙醇消耗。工艺创新即产品上市速度——这是 mRNA 工艺最独特的属性。
- CGT(细胞与基因治疗):CAR-T 等自体细胞产品,"工艺即产品"达到极致。从患者体内采集 T 细胞,体外激活、病毒载体转导、扩增、回输,全流程在数周内完成且每批都是"单一患者专属"。工艺开发与产品定义不可分,任何工艺变更都直接改变产品本身,监管按"风险定制"审评。
用代码做整线收率推演
把每步收率写进一个简单模型,能直观看到瓶颈所在:
# yield_model.py —— 上下游整体收率推演 steps = [ ("上游培养", 8.0, 1.00), ("收获", 1.00, 0.95), ("Protein A捕获", 1.00, 0.90), ("精制层析", 1.00, 0.85), ("制剂灌装", 1.00, 0.95), ] titer = steps[0][1] recovery = 1.0 for name, _, step_yield in steps[1:]: recovery *= step_yield print(f"起始滴度: {titer} g/L") print(f"总体回收率: {recovery*100:.1f}%") print(f"成品得量: {titer * recovery:.2f} g/L") # 假设上游滴度提升 25%(8→10 g/L) titer2 = 10.0 print(f"若仅提升滴度25%: 成品 {titer2 * recovery:.2f} g/L") # 假设下游每步提高 5 个百分点 recovery2 = 0.95 * 0.95 * 0.90 * 0.95 * 1.00 print(f"若下游每步+5%: 成品 {titer * recovery2:.2f} g/L")
对照两个结果,你会直观理解为什么"下游每 1% 都值得抠"。
制剂与质量控制:最后一公里的严谨
纯化后的蛋白/核酸距离"可注射产品"还有制剂环节,其工程要点常被低估:
- 配方设计:缓冲液、赋形剂(糖类、表面活性剂、氨基酸)决定产品的稳定性与给药途径。单抗通常需要高浓度制剂(100–200 mg/mL),黏度随浓度剧增,灌装与注射都面临工程挑战。
- 无菌灌装:无菌(aseptic filling)要求环境分级(A/B 级)、无菌验证、过滤器完整性测试。污染是生物药不可承受之重。
- 冷链与包装:部分产品(尤其 mRNA 脂质纳米颗粒)对温度极敏感,冷链设计是产品可用性的前提。
质量控制则贯穿全链条:原料(培养基、缓冲液)、中间品(HCP、DNA、内毒素)、成品(含量、纯度、效力、无菌)。每一个 CQA 都要有已验证的分析方法,方法验证(精密度、准确度、专属性、线性、耐用性)是注册资料的一部分。分析方法本身也是"工艺"——方法转移失误导致的批次争议,并不比工艺本身少。
工艺验证与商业化的最后一步
临床前与临床期间的工艺还允许演化,商业化前必须"冻结"。工艺验证(PPV)的经典三段结构:
- 工艺设计(process design):用 DOE/QbD 建立设计空间,明确 CPP 与 CQA 映射;
- 工艺确认(process qualification):在商业规模连续跑至少 3 批 PPQ 批次,确认参数落在既定范围且 CQA 达标;
- 持续工艺验证(CPV):商业生产期间持续监测批次数据,用统计过程控制(SPC)与趋势分析维持工艺在受控状态。
PPQ 批次数据是监管放行的核心证据,也是"一次性成功放大仍是行业痛点"的制度根源——商业化首三批若失败,代价是产能损失、周期延误与合规问询。这反向说明 4.2 节数字孪生"投产前演练"的价值。
# ppq_check.py —— PPQ 批次合格判定骨架(示意) def ppq_review(batches, spec_lo, spec_hi, target): n = len(batches) mean = sum(batches) / n in_spec = all(spec_lo <= b <= spec_hi for b in batches) dev = max(abs(b - target) for b in batches) / target print(f"PPQ 批次: {n} 批, 均值 {mean:.3f}") print(f"全部在规格内: {in_spec}, 最大相对偏移 {dev:.1%}") ok = n >= 3 and in_spec and dev <= 0.10 print("判定: " + ("PASS" if ok else "FAIL, 需调查")) return ok ppq_review([4.82, 4.91, 4.88], spec_lo=4.5, spec_hi=5.2, target=4.9) # 输出: PPQ 批次: 3 批, 均值 4.870; 判定: PASS
真实 PPQ 判定还包含 CQA 的规格符合性、工艺能力指数(Cpk)与偏差/变更审查,此处仅演示最小判定逻辑。
mRNA 疫苗快速生产需优化 T7 聚合酶表达、核苷酸池稳态、连续纯化降乙醇消耗——工艺创新即产品上市速度。
⚠️ 常见坑:下游成为瓶颈仍只优化上游——整体收率是乘法关系。
💡 关键直觉:医药生物工艺利润在质量与合规,不只滴度。
要点速记
- MAb 平台化工艺是行业基准
- 上游滴度与下游回收率是乘法关系
- 上下游需 Integrated 优化
- 病毒清除是生物药特有要求
- CGT 把工艺写入产品定义
- PAT/QbD 是注册语言