3.2 SQL在Access中的实现
3.2 SQL 在 Access 中的实现
本节摘要:设计视图的每一次点击都被翻译成 SQL。Access 的方言支持 SELECT 联接聚合的完整家族,外加 TRANSFORM 交叉表等私有扩展。本节带你读、写、改三个层次过一遍,目标是不再惧怕 SQL 视图。
上一节的每个拖拽动作,Access 都在后台同步写成了文本。切换方式简单:查询工具组里点"视图"选"SQL 视图",或者右键查询标签。本节的目标只有一个——让你从"看得懂"走到"敢手改"。
一、读懂第一句话:SELECT 的骨架
把上节那个单表筛选查询切到 SQL 视图,会看到类似这样的一句:
SELECT 订单.业务单号, 订单明细.货品编码, 订单明细.数量, 订单明细.成交单价 FROM 订单 INNER JOIN 订单明细 ON 订单.ID = 订单明细.订单ID WHERE (((订单.下单日期)>=Date()-90) AND ((订单.状态)<>"作废")) ORDER BY 订单.下单日期 DESC;
四个关键词各司其职:SELECT 声明要哪些列;FROM 说明数据来自哪,INNER JOIN 描述两张表按什么字段对齐(这就是界面里那根联接线的文字形态);WHERE 是筛选条件;ORDER BY 定输出顺序。Access 自动生成的 SQL 有个显著特点——括号特别多,那些多余的圆括号是解析器的历史习惯,手工书写时完全可以不带,执行不受影响。
跟读一遍就能发现:"左联接"对应 LEFT JOIN,"汇总里的 Group By"对应 GROUP BY 子句。语言和界面是同构的,学过的图形概念全部有现成的文字对应物。
二、手写升级:聚合与表达式
接下来脱离鼠标,把品类汇总查询完整手写一遍:
SELECT HUOPIN.品类, Sum(MINGXI.数量) AS 总销量, Sum([成交单价]*[数量]) AS 销售额, Sum(IIf(库存现有量<安全库存,1,0)) AS 缺货品类标记 FROM (HUOPIN INNER JOIN MINGXI ON HUOPIN.ID = MINGXI.货品ID) INNER JOIN DINGDAN ON DINGDAN.ID = MINGXI.订单ID WHERE DINGDAN.下单日期 >= Date()-90 AND DINGDAN.状态 <> "作废" GROUP BY HUOPIN.品类;
新面孔有三个,逐个点破:
- AS 别名给计算列起名,报表上显示的就是这个名字;
- IIf 函数是 Access 方言里的行内判断,
IIf(条件, 真值, 假值)三段式,本例用它给缺货行打标记; - 多表链式联接要用括号明确两两结合顺序,这是 Access SQL 最让外来者不适应的语法特征——别的数据库允许一次列三张表平铺联接,Access 要求
(A JOIN B) JOIN C这样逐层套。
书写习惯建议:关键字大写、每条子句另起一行、中文对象名不加方括号也合法但含空格时必须加。这些不是语法要求,是把 SQL 从"天书"变"便签"的排版技巧。
三、方言小抄:它有而标准没有的
Access SQL 与教科书标准 SQL 的差异值得专门列出,免得你拿着网上教程生搬硬套:
差异速查 日期字面量 用井号包裹 WHERE 下单日期 = #2026-03-01# 模糊匹配 通配符为星号问号 Like "A*" 而非标准的百分号 串接符号 用 & 号 姓名 & "-" & 电话 大小写 默认排序规则不区分 Option Compare 决定 交叉表 私有 TRANSFORM...PIVOT 结构 标准没有 TOP 关键字 支持 Select Top 10 取前若干名
其中 TRANSFORM 结构到 3.3 再展开。眼下先把日期井号和通配符差异刻进脑子——这两个坑在第一次从外部搬 SQL 进来时几乎必踩。
四、子查询:查询里再嵌一个提问
有些问题一句话装不下,比如"找出销售额高于自家平均值的品类"。解法是把平均值那段先用括号算出来当参照系:
SELECT 品类, Sum([成交单价]*[数量]) AS 销售额 FROM 查询某明细口径 GROUP BY 品类 HAVING Sum([成交单价]*[数量]) > (SELECT Avg(月度销售合计) FROM 查询品类月度汇总);
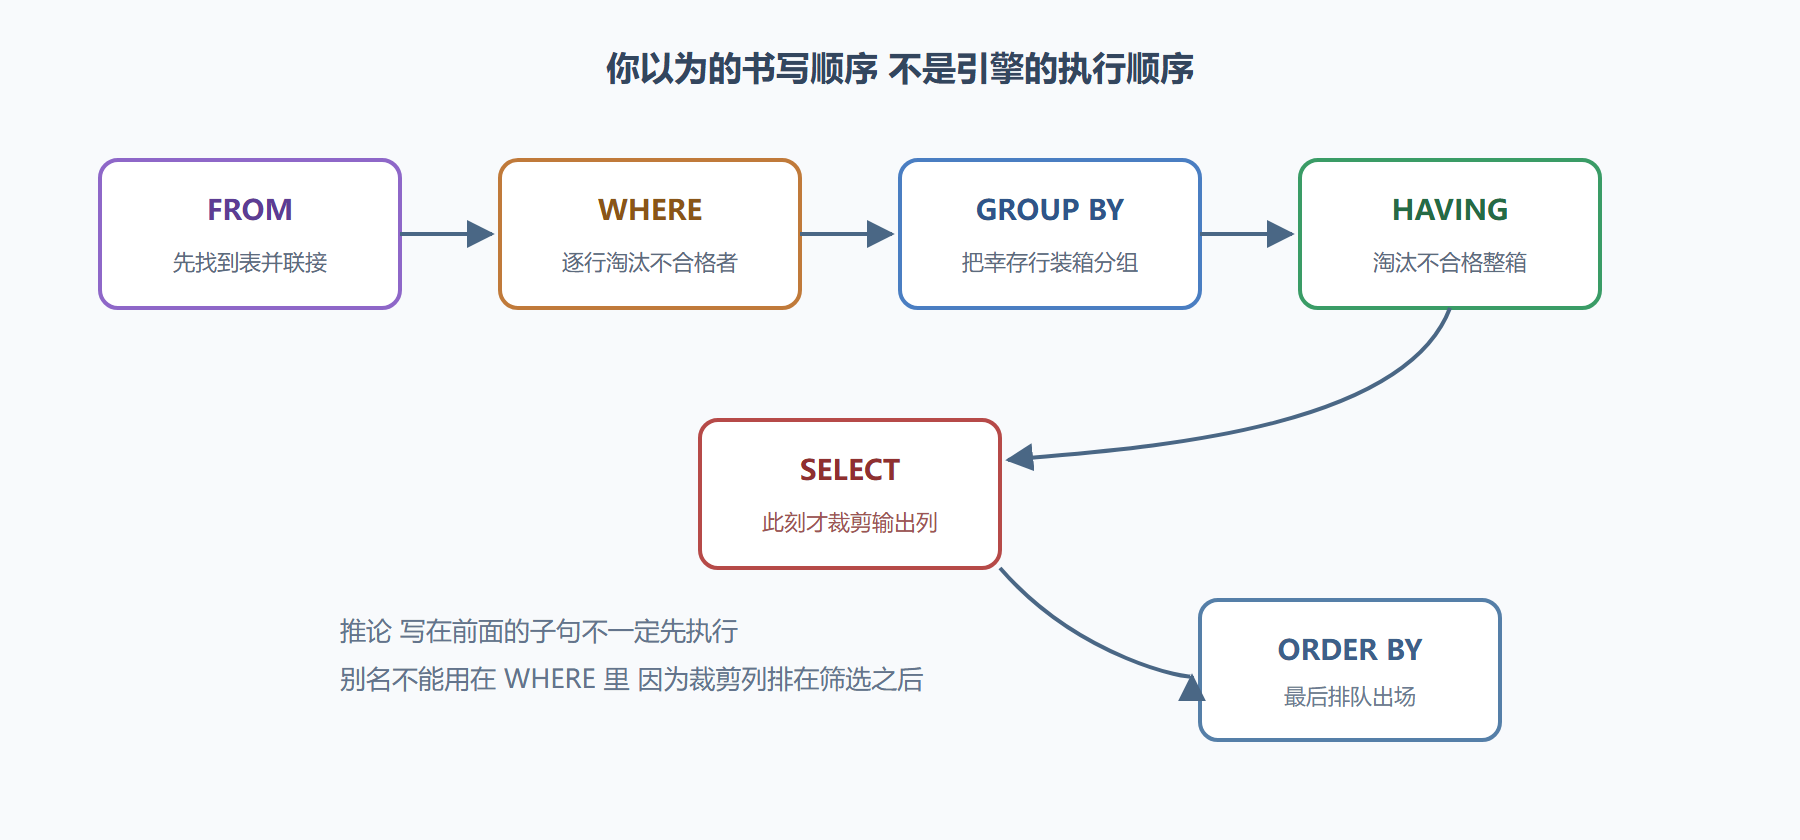
注意 WHERE 和 HAVING 的分工:前者过滤原始行,发生在分组之前;后者过滤分组后的统计结果。中文记忆法——WHERE 挑 row 行,HAVING 挑 group 组。子查询嵌套别超过两层,超过就该拆成多个具名查询串联(下一章你会看到这同时也是性能纪律)。
图题:一条 SQL 在引擎内部的执行次序
五、练起来:两个当场可做的实验
照着做比读十遍有效。实验一:随便打开你库里一个现成查询切到 SQL 视图,手动删掉所有多余括号运行——体会 Access 语法的宽容度。实验二:手写一句 SELECT TOP 5 * FROM 订单 ORDER BY 成交金额 DESC; 找出本月五张最大单——一步就体会到 TOP 配 ORDER BY 的实用组合。
有两件事现在说破,能少走弯路
第一件:Access 的 SQL 里存不了注释。 你在某句复杂查询旁写的 -- 说明文字 一保存就被引擎吐掉,下次打开消失得干干净净。这不是 bug 是现实——查询对象的定义里没有注释这个槽位。替代姿势有二:把说明揉进查询名("销售额_不含作废单_含税"),或者把复杂逻辑搬进具名查询分层接力,每层名字自解释。真要长篇论述就写进数据字典。
第二件:没有存储过程和真正的视图。 Access 的查询对象勉强相当于视图(存储的 SELECT 语句),但参数化程度低、无流程控制,批量业务逻辑请直接放 VBA。从正统数据库转过来的朋友常在这里碰壁:不是 Access 藏起来了,而是它压根没实现——这也解释了为什么第 5 章要把 DAO 写法当作正餐而不是甜点。
理解了这两条边界,你对"哪些活儿交给 SQL、哪些交给代码"就有了清晰的分诊台:单条提问归 SQL(哪怕嵌两层子查询),有过程有分支有事务的业务流归 VBA,两边隔着一条清楚的路。
把这两条边界吃透之后,你在新项目上的技术分工表其实已经能画出来:数据整理与统计提问交给查询对象层层接力;带条件分支、循环、事务的流程交给模块化 VBA;两边之间用"查询做零件、代码当总装"的协作方式衔接。这条分界线画得越早,后面三章(乃至你未来接触任何数据库平台)的认知迁移就越顺——毕竟 WHERE 与 HAVING、内联接与外联接这些概念本身就是跨平台的通用语。
本节要点打包
- 设计视图与 SQL 同构互译,SQL 视图是免费的能力放大器。
- SELECT 四大件 FROM、WHERE、GROUP BY 加 HAVING 各管一段;执行次序与书写次序不同。
- Access 方言速记:日期用井号、通配符星号问号、串接用 &、链式联接要加括号。
- 子查询一层封顶,复杂逻辑拆成具名查询接力更清爽。
语言的攻防只是开始。下一节拿出三件进阶兵器:参数化复用、行列转换、批量动作。