1.1 JSP是什么——定义与核心思想
1.1 JSP是什么——定义与核心思想
本节摘要:JSP(JavaServer Pages)是一种基于文本的服务器端模板技术:开发者把 Java 代码嵌进 HTML 页面,容器在运行前将其翻译成 Servlet 类再编译执行。定义里藏着三个关键词——模板文本、脚本片段、翻译执行,理解了它们,你就拿到了读懂青梧书肆全部页面的钥匙。本节处于全书认知链的最底端,第 2 章的请求旅程、第 3 章的语法清点都建在这套图景之上。
学习目标
阅读完本节,你应当能够:
- 用两句话向同事说清 JSP 是什么,不借助任何幻灯片;
- 指出一个 JSP 文件在容器中的两种存在形态及其切换时机;
- 解释 JSP 与 Servlet 的分工与共生关系,并说出"翻译"发生在哪个环节;
- 看到一个 JSP 页面时,能区分其中哪些内容会原样发给浏览器、哪些会在服务器上执行。
先把概念摆正:从交接现场的一个页面说起
上一章末尾你 clone 下了青梧书肆的代码库,第一个被打开的文件大概长这样:
<%@ page language="java" contentType="text/html; charset=UTF-8" pageEncoding="UTF-8" %> <!DOCTYPE html> <html> <head><title>青梧书肆 · 今日推荐</title></head> <body> <h1>今日推荐</h1> <% // 这段代码在服务器上执行 String[] books = {"朝霞集", "桥梁史话", "夜航西飞"}; for (String b : books) { %> <p>《<%= b %>》</p> <% } %> </body> </html>
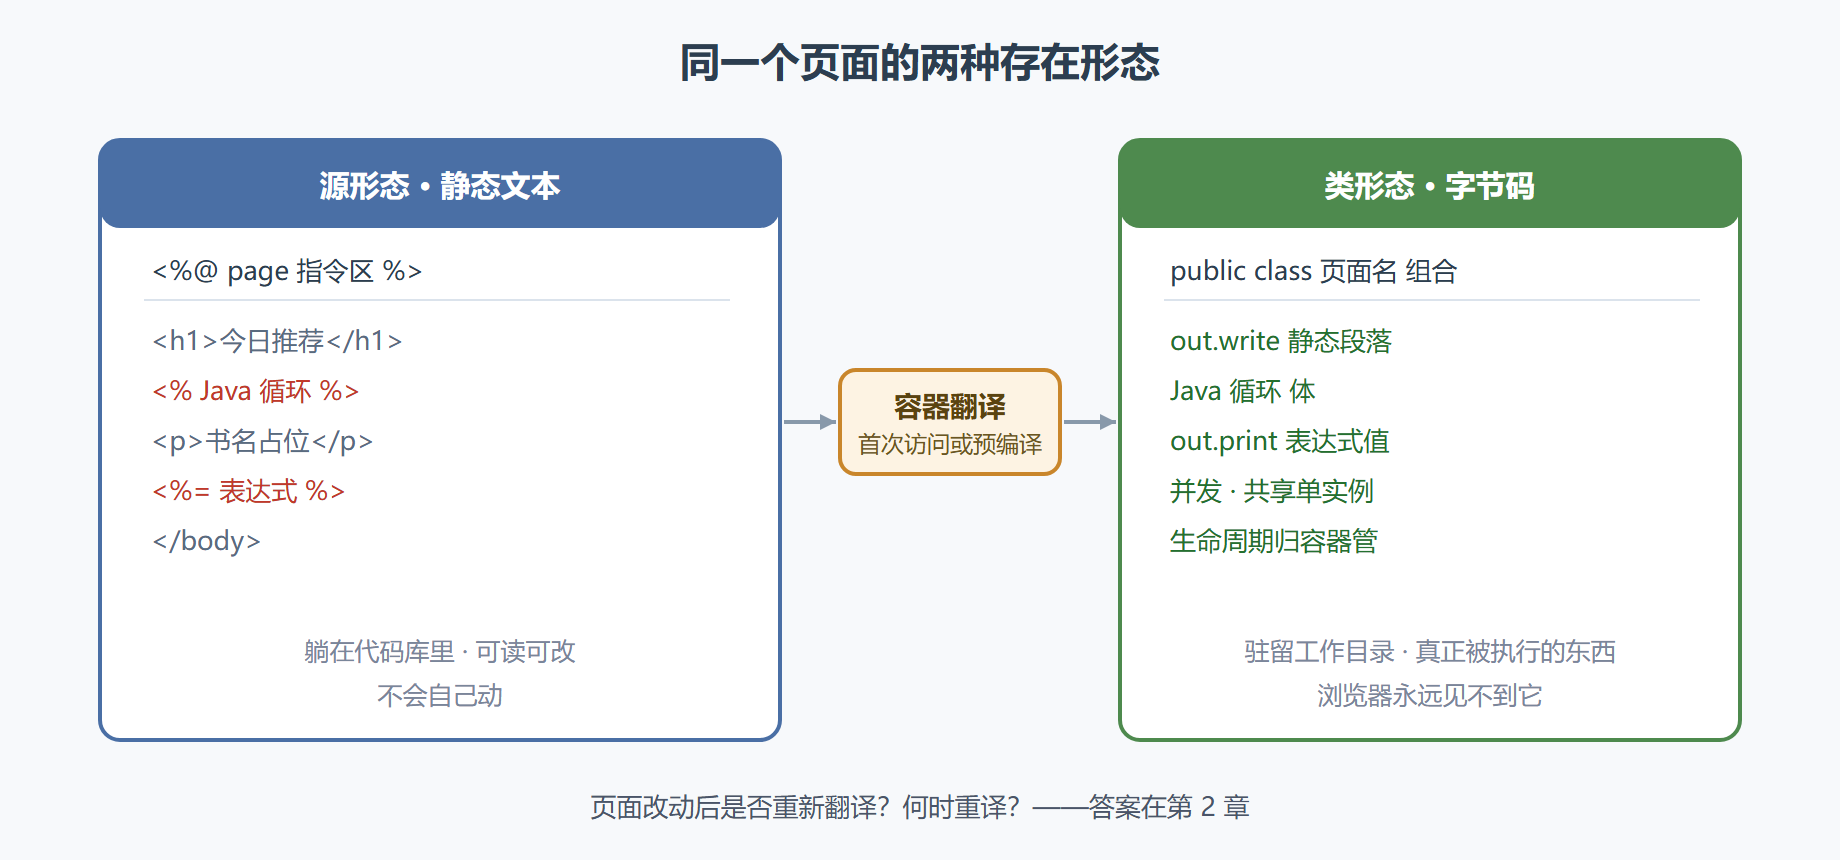
一个能看懂 HTML 的人盯住这个文件,很快会产生疑问:<% %> 包起来的部分算什么?它和外面的标签是什么关系?答案是整个 JSP 技术的基石:这个文件本质是一份模板,容器会把它整体翻译成一个 Java 类。静态的 HTML 部分(比如 <h1> 标题)被翻译成一条条"把这段文本写进响应流"的语句;<% %> 里的部分则原封不动地搬进这个类的服务方法体内,成为真正执行的逻辑;<%= %> 里则变成"把这个表达式的值写进响应流"。浏览器收到的永远是翻译、执行之后生成的纯 HTML。
所以 JSP 的精确定义可以压成两句话:它是允许在 HTML 中嵌入 Java 片段的页面模板格式;它在运行期先被翻译为 Servlet 类再编译执行,最终输出动态内容。三个关键词各司其职:模板文本负责外观骨架,脚本片段负责数据加工,翻译执行负责把两者捏合起来交给虚拟机。
核心机制:翻译这一步改变了什么
为什么非要绕一圈先翻译成类?直接解释执行页面文本不行吗?对比一下同时代的其他方案,答案就浮出来了。1990 年代末流行的 CGI 方案每来一个请求就拉起一个新进程,开销大到难以承受;一些脚本语言方案虽然进程常驻,但逐行解释页面文本,性能天花板低。JSP 选择把页面"物化"成 Java 类,换来三样东西:编译后的字节码由虚拟机直接执行,速度与任何 Java 程序无异;首次翻译的结果缓存在容器的工作目录里,后续请求零重复劳动;页面里的代码从此享有 Java 的完整类型系统、异常体系与标准库。
// 翻译产物示意(简化):上面的页面大致变成了这样一个类 public final class TodayHtml extends HttpJspBase { public void _jspService(HttpServletRequest request, HttpServletResponse response) { JspWriter out = ...; // 响应输出流 out.write("<!DOCTYPE html>\r\n<html>\r\n"); // 模板文本 → 写出语句 String[] books = {"朝霞集", "桥梁史话", "夜航西飞"}; for (String b : books) { out.write(" <p>《"); out.print(b); // 表达式 → 打印值 out.write("》</p>\r\n"); } out.write("</body>\r\n</html>"); } }
对照这份示意代码,你能看清三种成分的去向。有个细节值得停下来想一想:既然每个页面都是类,那么它天然继承了这个类的所有属性——线程模型是共享实例并发服务的、生命周期由容器托管、出错时会抛异常而不是打印半截 HTML。老站点的许多怪现象,根子都在这层身份上。
图1-1 同一页面的两种存在形态
翻译图景的一个延伸读法
带着"页面即类"的眼光,你还能读出老代码里的时间痕迹。不同年代的页面在翻译产物的形状上有细微差别:早期页面的输出语句零碎、一行模板文本就可能拆成多条写出调用,那是因为当年的页面作者在 HTML 里逐段插脚本,模板文本被切得极碎;后来经过整理的页面,静态段落大段连贯,输出语句数量骤减。读产物时留意这个特征,能帮你判断一段页面"被整理过没有"——整理过的页面改动风险低,没整理过的原始页面改动时要更小心,因为你看到的源码结构可能远比产物复杂。这类读法没有写在任何规范里,纯粹是"知道页面会变成什么样"之后的副产品,但接手老站时它经常能提前一步指出哪里是雷区。
三个高频追问
接手期间你大概率会被同事问到三个问题,这里一并备好答案。第一问:既然页面终归要变成类,为什么不直接写 Servlet?答案在分工而非能力——直接写 Servlet 拼页面,模板文本全靠字符串常量承载,改一个标题都要重新编译部署;页面把外观还给文本,把编译的麻烦交给容器,这是它存在了二十多年的理由。第二问:页面是每次请求都重新翻译吗?不是,翻译只发生在首次或变更后,后续请求直接执行现成的类——把 1.1 的两种形态与 2.1 的缓存判断连起来,这个问题自动消解。第三问:模板文本有性能代价吗?有,但被缓冲输出摊薄了;真正要提防的是把超大静态内容塞进页面,那会让类的字节码膨胀、加载变慢——静态资源交给静态资源该待的地方,这条纪律第 8 章还会再算一遍账。
把这三问备在工具包里,评审会上至少省掉半小时的往返解释。概念的传播成本,也是维护成本的一部分。
与 Servlet 的共生关系:一段历史遗留的双簧
接手老项目的人常听到一种说法:"JSP 就是简化的 Servlet。"这话对了一半。从运行结果看确实如此——每个页面最终就是一个 Servlet 类;但从设计意图看,两者是被刻意分开的两种角色。Servlet 天生适合写控制逻辑:接收请求、校验参数、调用业务、决定跳转到哪,全流程都是代码说了算;可一旦要用它拼 HTML,满屏的字符串拼接能把人逼疯。JSP 反过来:写 HTML 如鱼得水,写复杂逻辑则让页面迅速腐烂。
于是行业摸索出标准搭配,也就是你接下来两章要反复遇到的主题:Servlet 当控制器,JSP 当视图,JavaBean 承载数据。青梧书肆下订单的路径就是典型——请求先进下单 Servlet,业务处理完再"转发"给结算页面做展示。这条共生关系还有个更隐蔽的含义:凡是 Servlet 拥有的能力,JSP 视图理论上也都能用(毕竟它就是个类),这正是当年"整站逻辑写在页面里"这种悲剧的技术根源——门一直是开着的,只是希望大家自觉别走进去。
把本节的三点装进口袋,就够走完全书了。其一,页面即模板,执行的是翻译后的类;其二,翻译产物决定了页面的线程模型与错误行为;其三,JSP 与 Servlet 是按角色分工的同族兄弟,不是竞争者。至于一次点击究竟如何触发"命中页面—检查缓存—翻译编译—执行输出"的全过程,下一节我们把镜头架到容器内部,逐帧回放这段旅程。