2.1 请求处理全流程拆解
2.1 请求处理全流程拆解
本节摘要:请求处理流程指一次 HTTP 请求从到达容器到响应写回浏览器的完整链路,核心环节依次是地址匹配、翻译缓存判断、按需编译、五阶段生命周期执行、输出回写。它是第 2 章的地图页:本节先建立全链路骨架,下一节再深入链路上真正承载状态的角色。掌握这张图,是排错时"先定位断点、再动手改码"的前提。
一次点击,容器里发生了什么
第 1 章末尾那个时钟页面已经证明:页面是活的代码,时间在走。但"活"的细节当时被一笔带过了——你在地址栏敲下回车到页面出现之间,容器做了一整套决策。现在把青梧书肆"加入购物车"的那半秒钟拉成慢动作,逐帧看。
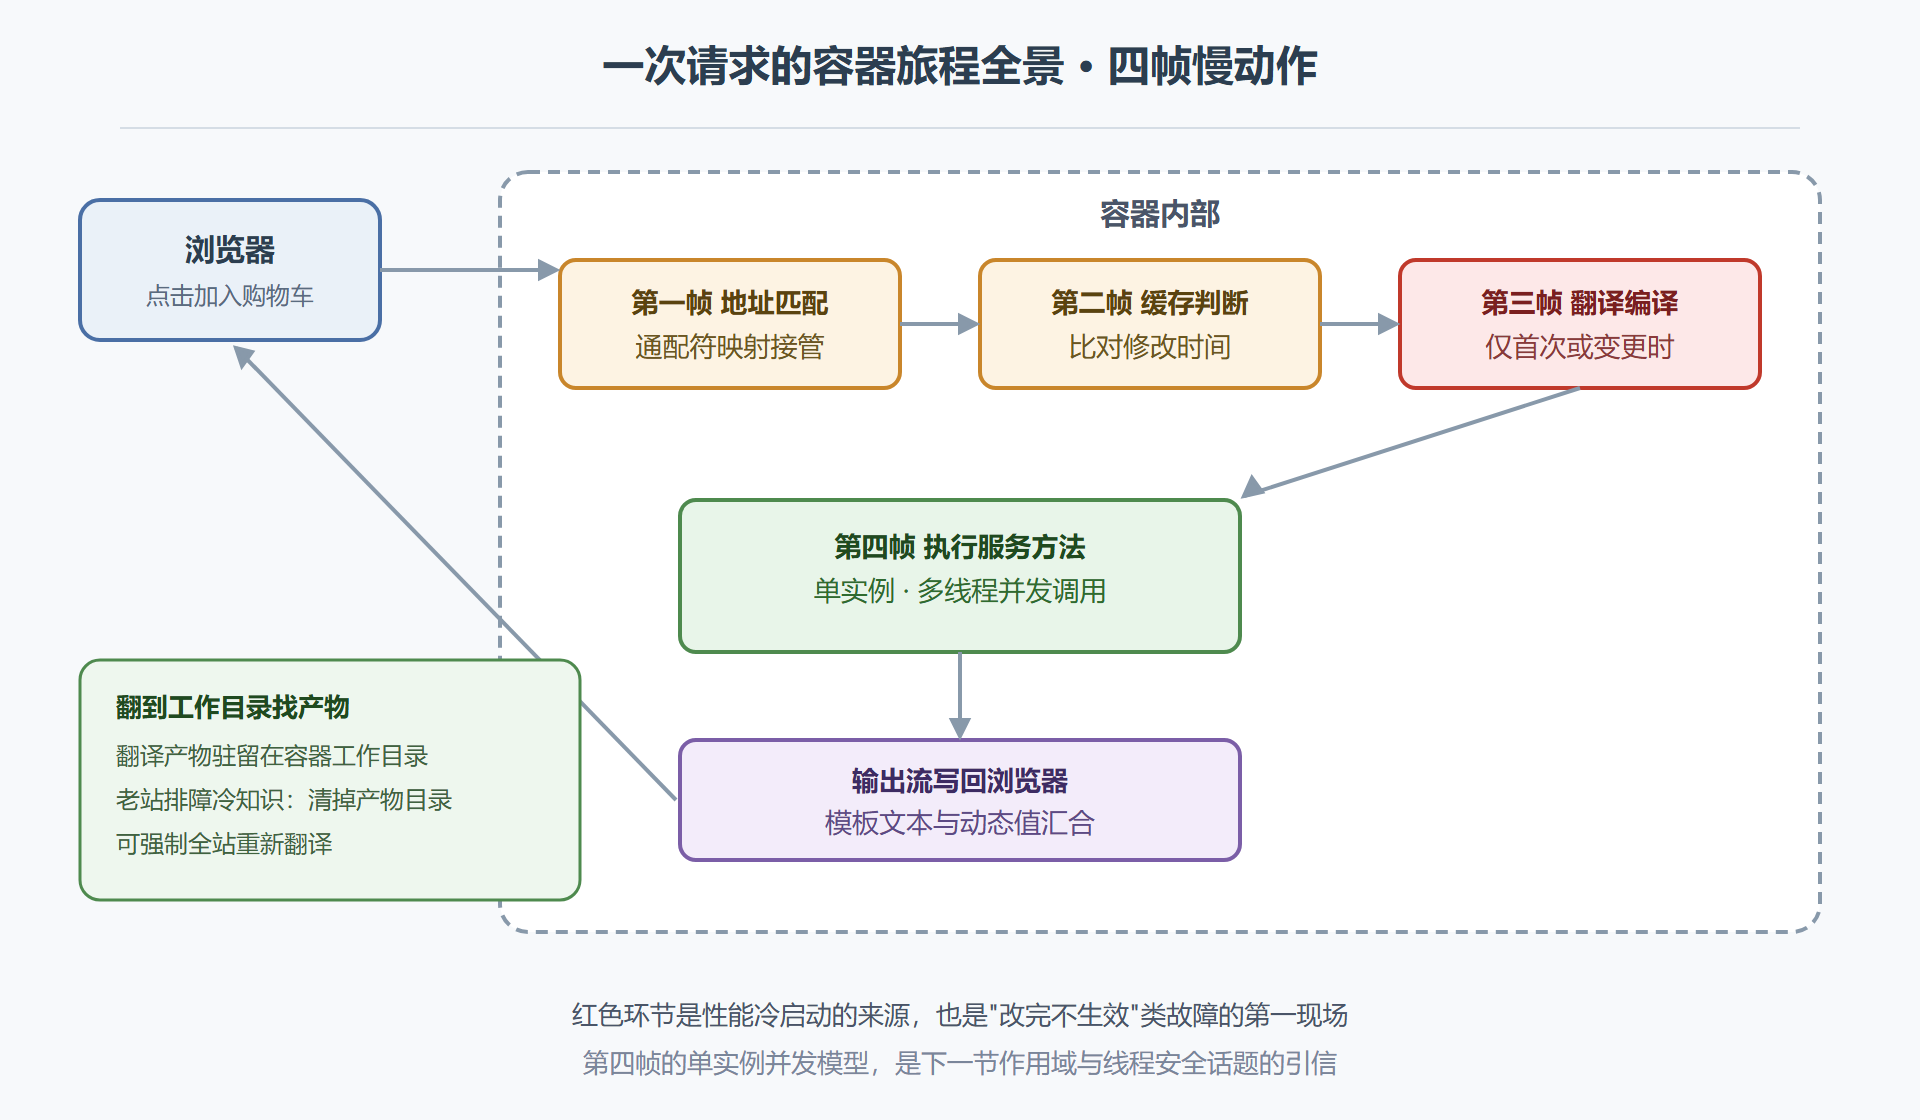
第一帧,地址匹配。浏览器发出对某个以 jsp 结尾路径的请求,容器收到后要决定谁接手。它不需要你为每个页面注册映射:容器内置了一个专门处理页面的 Servlet,早已用通配符把所有 jsp 结尾的地址包揽下来。这就是为什么老站里你找不到"每个页面对应哪条路由"的配置——根本没有,约定即配置。这也是断代线索之一:看见工程里大量手工注册的页面映射,说明那是容器映射机制成熟之前的产物。
第二帧,缓存判断。接手的引擎先问:这个页面对应的类已经存在吗?源文件后来改过吗?判断手段朴素得惊人——比对源文件的修改时间与翻译产物的生成时间。没改过,直接复用现成的类;改过或从未翻译过,进入翻译编译流水线。
第三帧,翻译与编译。1.1 节看过翻译产物的样子,这里补上时间维度:这一步只在首次访问或源文件变更时发生。它解释了老站运维的两条祖传经验——"新部署的站点第一下特别慢"(冷启动,若干页面同时排队翻译);"改了页面不用重启"(时间戳变了,容器自动重译)。
第四帧,执行与输出。类就位后,容器走五阶段生命周期的最后一环,调用页面服务方法;方法体里模板文本变成写流语句、脚本片段原样执行,输出流一路写到浏览器。
图2-1 一次请求的容器旅程全景
五阶段生命周期:类的入场与退场
翻译编译产出的是字节码,字节码要经过装载、初始化才能服务,退场时还有销毁环节。五个阶段各有各的纪律,值得单独一张状态图。
两个常被忽略的纪律。其一,初始化只发生一次:如果你在页面声明区里放了昂贵的初始化逻辑,它只会在第一个请求时执行,后续请求复用结果——老站里有人拿这个特性当缓存用,理解它你才能看懂那些奇怪写法的意图。其二,服务态是并发的:同一个类实例同时服务所有请求,每来一个请求就有一个线程进到服务方法里。这句话是下一节的作用域与线程安全话题的全部地基,现在先把它的分量掂出来:你在页面上写下的每一行代码,都可能是几十个线程同时执行的同一行代码。
案例:改了页面为什么不生效
一次真实排查,四段式走完。
背景:运营要求把图书详情页上"库存紧张"的提示文案改掉,你改了页面文件、刷新浏览器,页面上还是旧文案。重启容器之前,你决定按本章的链路图先推理一遍。
操作:链路四帧逐帧核对。地址匹配没问题——URL 没变过;缓存判断是头号嫌疑:容器靠修改时间戳决定要不要重译,如果部署工具把文件拷贝过去时保留了旧的修改时间,容器会认定"没变更";于是先确认文件确实到了容器那边、再检查文件时间戳。
结果:真相是运维的同步脚本用了保留时间戳的拷贝参数,新文件带着旧时间戳躺进了部署目录,容器的时间戳比对永远得出"未变更"。把拷贝参数里的保留开关去掉,重新同步,页面立即更新。
解读:这个案例的价值在于它把"改了不生效"从玄学还原成了链路上的一帧故障。容器不做内容比对,只信时间戳——这是性能换来的代价。同理,老站运维流传的"删工作目录大法"(清空翻译产物目录强制全站重译)之所以屡试不爽,正是因为它直接把第二帧的缓存清了,逼容器从头走流水线。
变式:反过来,如果你在开发时改一行就想看效果,却又频繁遇到"没生效",可以先确认容器是否关掉了变更检测(有些生产配置会显式关闭开发期热更新,此时任何修改都不触发重译)。判断标准很简单:删产物目录后立即生效的,是缓存问题;删了也不生效的,是配置问题或改错了部署目录——后者在多环境部署的老站里相当常见,你以为在改 A 环境,实际请求打到 B 环境。
排错的四个断点
把链路图变成排错清单。任何"页面不对劲",按四个断点依次过:
- 到达断点:请求到容器了吗?看访问日志有没有这条记录。没有,是网络、端口、防火墙的事,与代码无关。
- 匹配断点:地址对上了资源吗?404 都在这里发生,重点核对应用前缀、文件名、欢迎页配置。
- 执行断点:执行时炸了吗?500 加日志里的异常栈在这等你,栈的第一行通常直接指向页面行号。
- 输出断点:跳转与内容对吗?乱码多半在输出编码,跳转怪象(地址变没变、刷新重不重复提交)是下一章 2.3 节的主菜。
💡 关键直觉:排错的本质是把"页面不对"翻译成"链路第几帧不对"。四个断点问一圈,多数故障自动现形——这也是老练维护者和新手的第一差距。
从链路看两类经典误判
有了链路图,老站运维群里两类高频误判可以当场拆穿。第一类是"改了没生效就是缓存坏了,重启解决一切"。重启当然有效——它顺带清了翻译缓存,但那是拿炮仗打蚊子:真凶可能是时间戳、可能是改错了部署目录、也可能是多应用前缀下投错了目标。重启掩盖了病因,下次必然复发。正确动作是先走四帧定位,再决定动哪一层。第二类是"报错行号指向页面,就认定页面有错"。链路的第三帧里,异常栈指向的是翻译产物,产物行号与源文件行号的对应关系受页面写法影响——尤其嵌套标签多、脚本片段长的老页面,行号漂移时有发生。看栈先看异常类型,再回源码找语义对应的段落,别被行号牵着走。
这两类误判的共同根子是把链路当黑盒。地图在手,黑盒就变成了可以逐帧检查的机器——本章后两站会继续往地图上补地标。
链路视角下的日志观
链路图还能反过来解释"日志应该打在哪"。每一帧的信息价值不同:地址匹配帧值得记录请求到达与命中的资源(排障第一入口),缓存判断帧只在触发重译时记一条(冷启动追溯的依据),执行帧的异常必须连栈带上下文记全(第 7 章排障链的原料),输出帧记响应状态与耗时(性能趋势的数据源)。老站点日志的通病是只有执行帧的异常、缺其余三帧——出了事只知道"炸了",不知道"谁来了、走了哪条路、花了多久"。青梧书肆的日志整改就是按四帧补齐的:给访问入口加访问日志、给重译加变更日志、给响应出口加状态与耗时。补齐之后你会发现,很多过去要靠"问用户"才能还原的事故,日志里自己会讲故事。日志是链路的影子,链路想清楚,日志自然打得对。
本节要点回顾
- 链路四帧:地址匹配、缓存判断、翻译编译、执行输出,任何请求故障都能定位到某一帧;
- 按需编译:容器只信修改时间戳,首访慢是冷启动,改了不生效先查时间戳与部署目录;
- 五阶段纪律:初始化仅一次、服务态高并发,页面代码天然运行在多线程环境;
- 四断点排错法:到达、匹配、执行、输出,顺序过一遍,问题域快速收窄。
链路的骨架已经立起来了,但骨架上流动的数据放在哪、活多久、谁能看见,这些状态管理的核心问题,正是下一节四大作用域与九大隐式对象要回答的。