8.1 预编译连接池与缓存关键点
8.1 预编译连接池与缓存关键点
本节摘要:JSP 站点最划算的三笔性能账是:预编译把页面翻译编译的成本从高峰期挪到部署期;连接池让数据库连接循环复用而非现借现还;缓存策略让重复劳动只做一次。本节先教你怎么测出第一组基线数字、怎么从数字反推病灶,再逐笔算清这三笔账——性能优化的纪律是先测再改,处方永远开在诊断之后。
第一次全站压测的数字
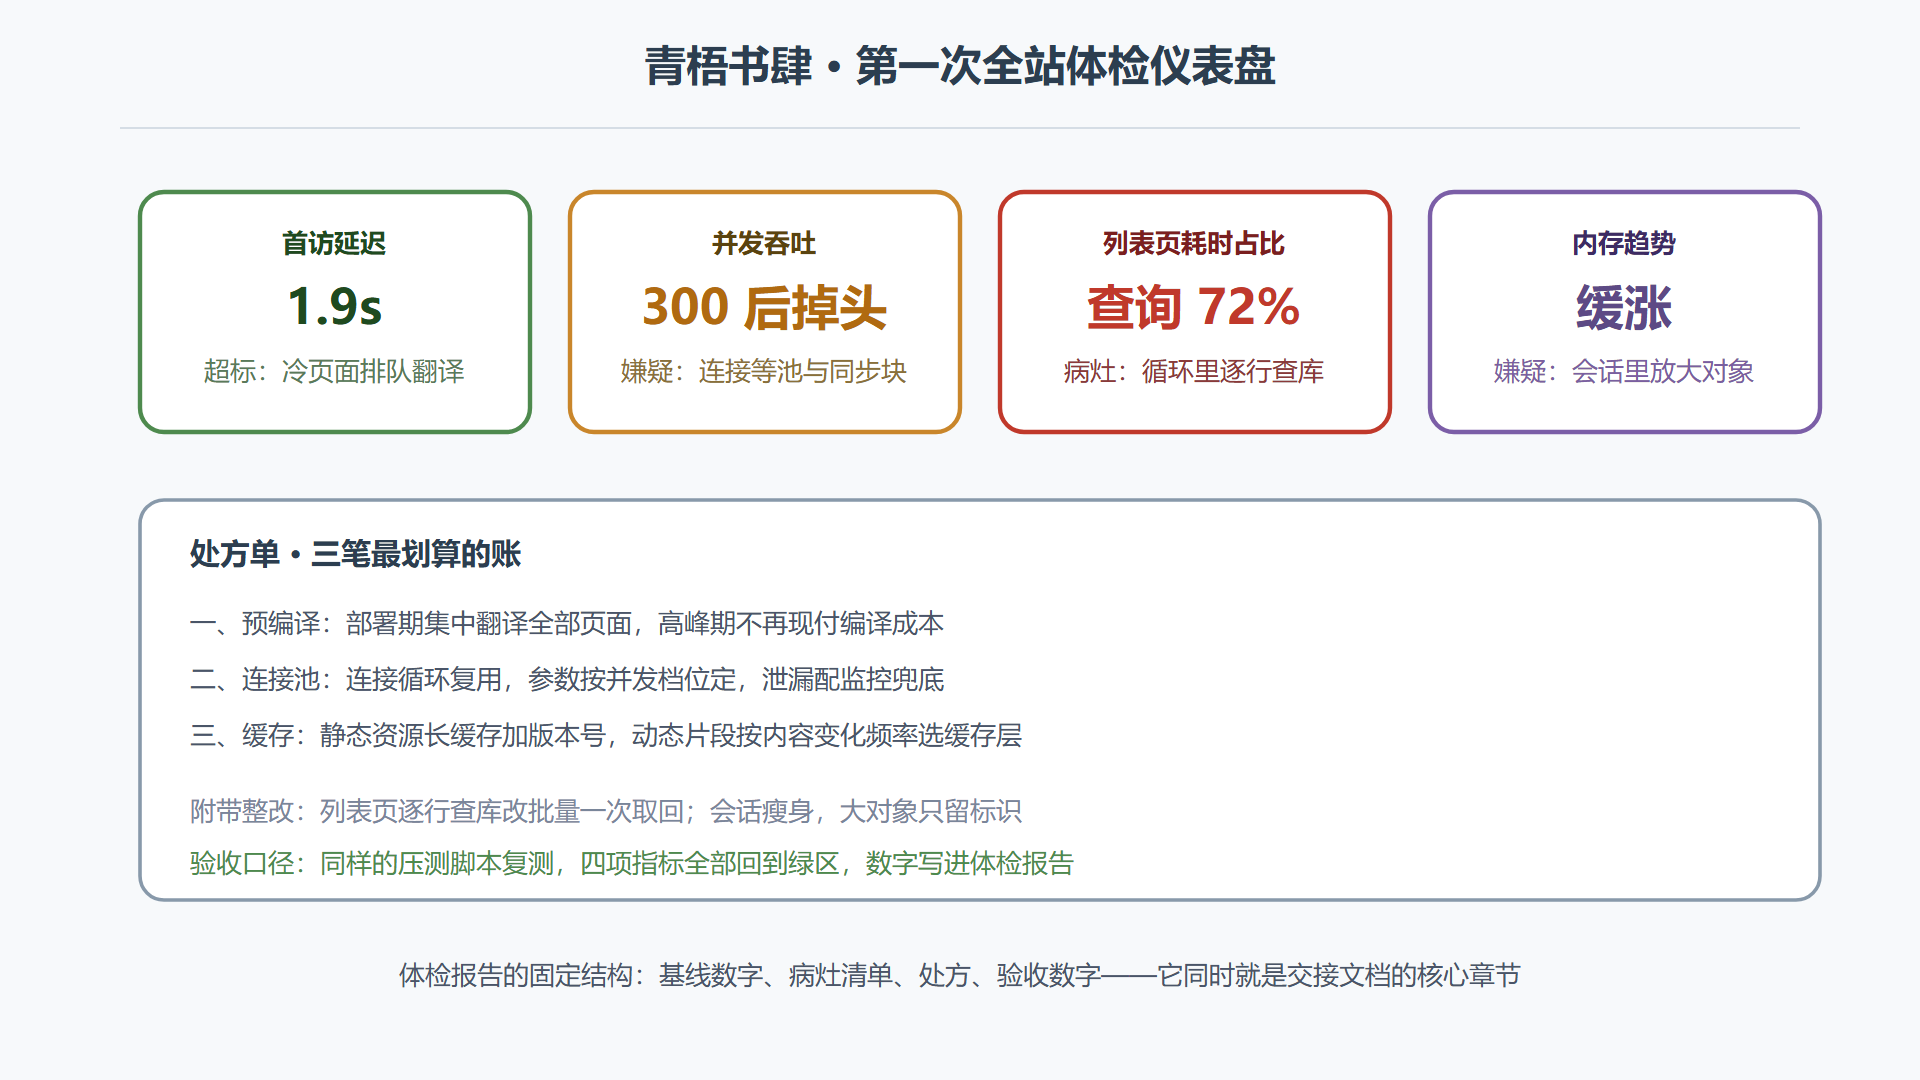
体检先上仪器。对青梧书肆做全站压测,需要拿回四个数字:首访延迟(冷启动页面第一次被打开的耗时,反映翻译编译成本)、稳态延迟(预热后正常请求的耗时)、并发吞吐(单位时间能扛住多少请求不劣化)、错误率(压力下的失败比例)。测法不复杂:选流量最大的十个页面,预热一轮后分档加压,每档记录四个数字。青梧书肆的第一次体检就抓到了典型病灶——稳态延迟尚可,但并发上到三百后吞吐不升反降、错误率抬头。
数字到手,按图索骥。首访慢指向翻译编译;吞吐上不去、线程堆着,常见是连接等池或同步块;内存缓涨慢漏,回头查 2.2 节的作用域滥用;单页耗时高,用链路追踪把耗时拆到查询、渲染、远程调用三段,看谁占大头。病灶定位的纪律是每一步都有数字背书——"我觉得慢"不是诊断,"查询段占了七成耗时"才是。
图8-1 全站体检报告仪表盘
预编译:把编译成本挪到部署期
2.1 节讲过,容器默认按需编译:页面第一次被访问才翻译。开发期这是便利,生产期这是隐患——发布之后的第一波流量会齐刷刷撞上编译流水线,高峰发布更是灾难。预编译的思路是把这笔成本预付:部署阶段用构建步骤把全部页面提前翻译编译成类,用户到达时类已就位,首访延迟直接对齐稳态延迟。
青梧书肆的预编译收益在数字上很直观:首访延迟从近两秒压到与稳态一致。但有边界要交代清楚:预编译只治"翻译编译"这一种慢。如果你的页面稳态也慢——查询慢、渲染慢、远程调用慢——预编译帮不了你,那是后面两笔账和 8.2 节规范的事。顺带一个纪律:页面改动后容器重编译依赖时间戳(2.1 节的老朋友),预编译流程要纳入构建脚本统一执行,否则改完页面忘了重跑,行为又退回按需编译。
连接池与缓存:两笔最划算的账
连接是最稀缺的资源。没有池的时候,每个请求现建连接、用完销毁——建连本身要几次网络往返,数据库还要为认证买单,并发一上来连接建立的开销比查询还贵。池化之后,连接循环使用,请求只是从池里借、用完还,建连成本从"每请求一份"摊成"启动时一份"。配置抓三个参数:池子大小(按并发档位定,不是越大越好,数据库端的连接数是硬约束)、借出上限与等待超时(防止故障时请求无限排队)、闲置回收(把漏还的连接定期追回)。4.3 节那句"连接不泄漏"在这里补上兜底:池的借还监控曲线是泄漏最灵敏的探测器,借出数只涨不落就是泄漏现行。
缓存的原则一句话:重复劳动只做一次。按劳动的类型分层安排。静态资源(样式、脚本、图片)交给浏览器与前端缓存长存——配合文件名带版本号的做法,内容更新时换文件名,缓存头可以放心开到最长,做到"永不失效、变更即换新"。动态片段按变化频率选择缓存层:不变的全站公告用应用级缓存,低频变化的书目分类用带过期时间的片段缓存,实时数据(库存、价格)不缓存或极短缓存。判据始终是内容变化频率与一致性代价的权衡——缓存不是越猛越好,卖超了库存的缓存事故比慢一点更贵。
案例:列表页的逐行查询
背景:体检报告里最刺眼的一条:图书列表页查询段占总耗时七成。链路追踪显示该页一次请求触发了五十一条查询——列表本身一条,另外五十条是每本书单独查一次库存。
操作:这就是经典的"逐行查询"反模式。改造分两步:数据访问层新增一次批量查询,拿整页书的主键清单一次取回全部库存;控制器把库存整理成按主键索引的映射放进请求作用域;视图的循环里改成从映射取值——第 5 章的改造让视图已经没有脚本,这个改动只动了控制器与服务层,这正是分层的红利。
结果:该页查询数从五十一降到二,页面稳态延迟降了近七成,并发吞吐的上限随之抬升。
解读:逐行查询是视图驱动开发的典型后遗症——当年写页面的人顺手在循环里加了查询,单用户时代毫无症状,并发时代每行一次往返就是五十次网络开销。它也是视图改造最该顺手排查的病灶:看到循环就问一句里面有没有查询。第 5 章改列表页时我们就揪出过一例,体检阶段再全面扫一遍。
变式:批量取回也不是万能公式。一页五百条主键的批量查询对数据库同样是负担,分页大小本身要合理;真正"每行都不同源"的极端场景,考虑冗余字段或读模型,把 join 的成本从请求期挪到写入期——这已经是架构级处方,留到站点真需要时再动。
💡 关键直觉:性能优化的三笔账本质是同一个思想——别在高峰期做可以提前做的事。编译挪到部署期,建连挪到启动期,重复计算挪到缓存期。每一次"挪",都是拿部署与启动时的从容,换高峰期的余量。
压测本身的三个坑
体检数字要可信,先给压测本身排雷。其一,压测环境失真:本地压测的数字再漂亮也不算数——数据库与应用同机、网络零延迟、数据量不对,全都让结果过于乐观。预发环境加生产同量级的数据集,是最低配的仿真。其二,预热缺失:冷页面第一次被压测命中的延迟会把均值拉爆,也说明不了稳态问题;正确姿势是先低压力跑一轮预热(顺带完成按需编译),再开始正式计量。其三,只看均值不看分布:平均一百毫秒的接口,可能是一百次八十毫秒加一次五秒——尾部延迟才是用户真实体感,报表必须带上分位值。三个坑排完,你拿到的数字才有资格写进体检报告;带着水分的基线,比没有基线更误导决策。
性能账本的年度复核
体检不是一次性动作,性能账本需要年度复核。三笔账各有复核要点:预编译账,确认构建脚本仍在编译全部页面——中途有人往工程里加了新页面却没进编译清单,首访延迟就会悄悄回潮;连接池账,把借还曲线的年度极值翻出来,对照池子大小参数看是否需要扩容——业务量涨了池子不涨,等待超时会越来越频繁;缓存账,抽查缓存头的实际生效情况——中间加了一层代理或改了静态资源路径,长缓存可能已经悄悄失效,用户在默默重复下载。年度复核半天能做完,产出追加进体检报告,让报告从"一次性文档"变成"有历史的活档案"。性能退化从来不是突然发生的,是无数个"顺手改一下"累积出来的——年度复核就是把这些小改动的账定期算一次。
本节要点回顾
- 基线四数字:首访延迟、稳态延迟、并发吞吐、错误率,先测再改,处方开在诊断后;
- 预编译付在部署期:治冷启动不治稳态慢,纳入构建脚本防止退化;
- 连接池三参数:池子大小、等待超时、闲置回收,借还曲线是泄漏探测器;
- 缓存按变化频率分层:静态长缓存配版本号,动态片段看频率,实时数据慎缓存;
- 循环里不查库:逐行查询改批量取回,视图改造与性能体检两头都要盯。
病灶治完只是保住当前版本。下一站把这些经验沉淀成规范,让站点在多人、多版本的岁月里不再退化。