2.2 单机架构:线程、内存与磁盘 IO
2.2 单机架构:线程、内存与磁盘 IO
本节摘要:单机内部有三本账:线程账(谁在干活)、内存账(共享缓冲区、私有内存怎么分)、磁盘账(数据页与日志走什么通道刷下去)。巡检、容量规划、参数调优,翻来覆去用的都是这三本账。
从一次例行巡检说起
每月一次的例行巡检,交付工程师在客户机房登录机器后敲的第一批命令,问的其实都是这三个问题:线程健康吗、内存吃紧吗、磁盘跟得上吗。要读懂巡检输出,得先知道单机里有哪些角色、内存怎么划分、IO 走哪条路。本节就按这三本账展开,学完你能把巡检输出里的每一行都对上号。
线程账:一台实例里的排班表
openGauss 采用线程池模型:一个实例对应一组受管理的线程,而不是每个连接都独占一个操作系统进程。这对高并发场景是关键差异——上万连接来时,线程池可以复用工作线程,避免进程爆炸。核心线程角色如下:
- 监听与分发线程:接受连接,把会话派发给工作线程;
- 工作线程:真正执行 SQL 的劳力,受线程池上限约束;
- WAL 写入与后台写线程:把日志缓冲与脏页有序刷盘;
- 检查点线程:周期性推进检查点,控制崩溃恢复时长;
- 自动清理线程:回收 MVCC 产生的旧版本空间(第 3 章的主角之一);
- 统计信息收集线程:维护优化器依赖的统计与监控数据;
- 回放线程(备机):接收并回放主机的日志,第 5 章的主角。
排障时最常用的一问:现在谁在忙?用系统视图看会话与等待状态:
-- 谁在跑、跑了多久、卡在什么等待上 SELECT pid, usename, state, wait_event_type, wait_event, now() - query_start AS running_for, left(query, 60) AS sql_head FROM pg_stat_activity WHERE state <> 'idle' ORDER BY running_for DESC;
输出里 wait_event 一列就是线程账的实时快照:等待 IO 说明磁盘账有问题,等待 Lock 说明并发冲突,等待是空闲则可能是客户端没取结果集。
内存账:共享区与私有区
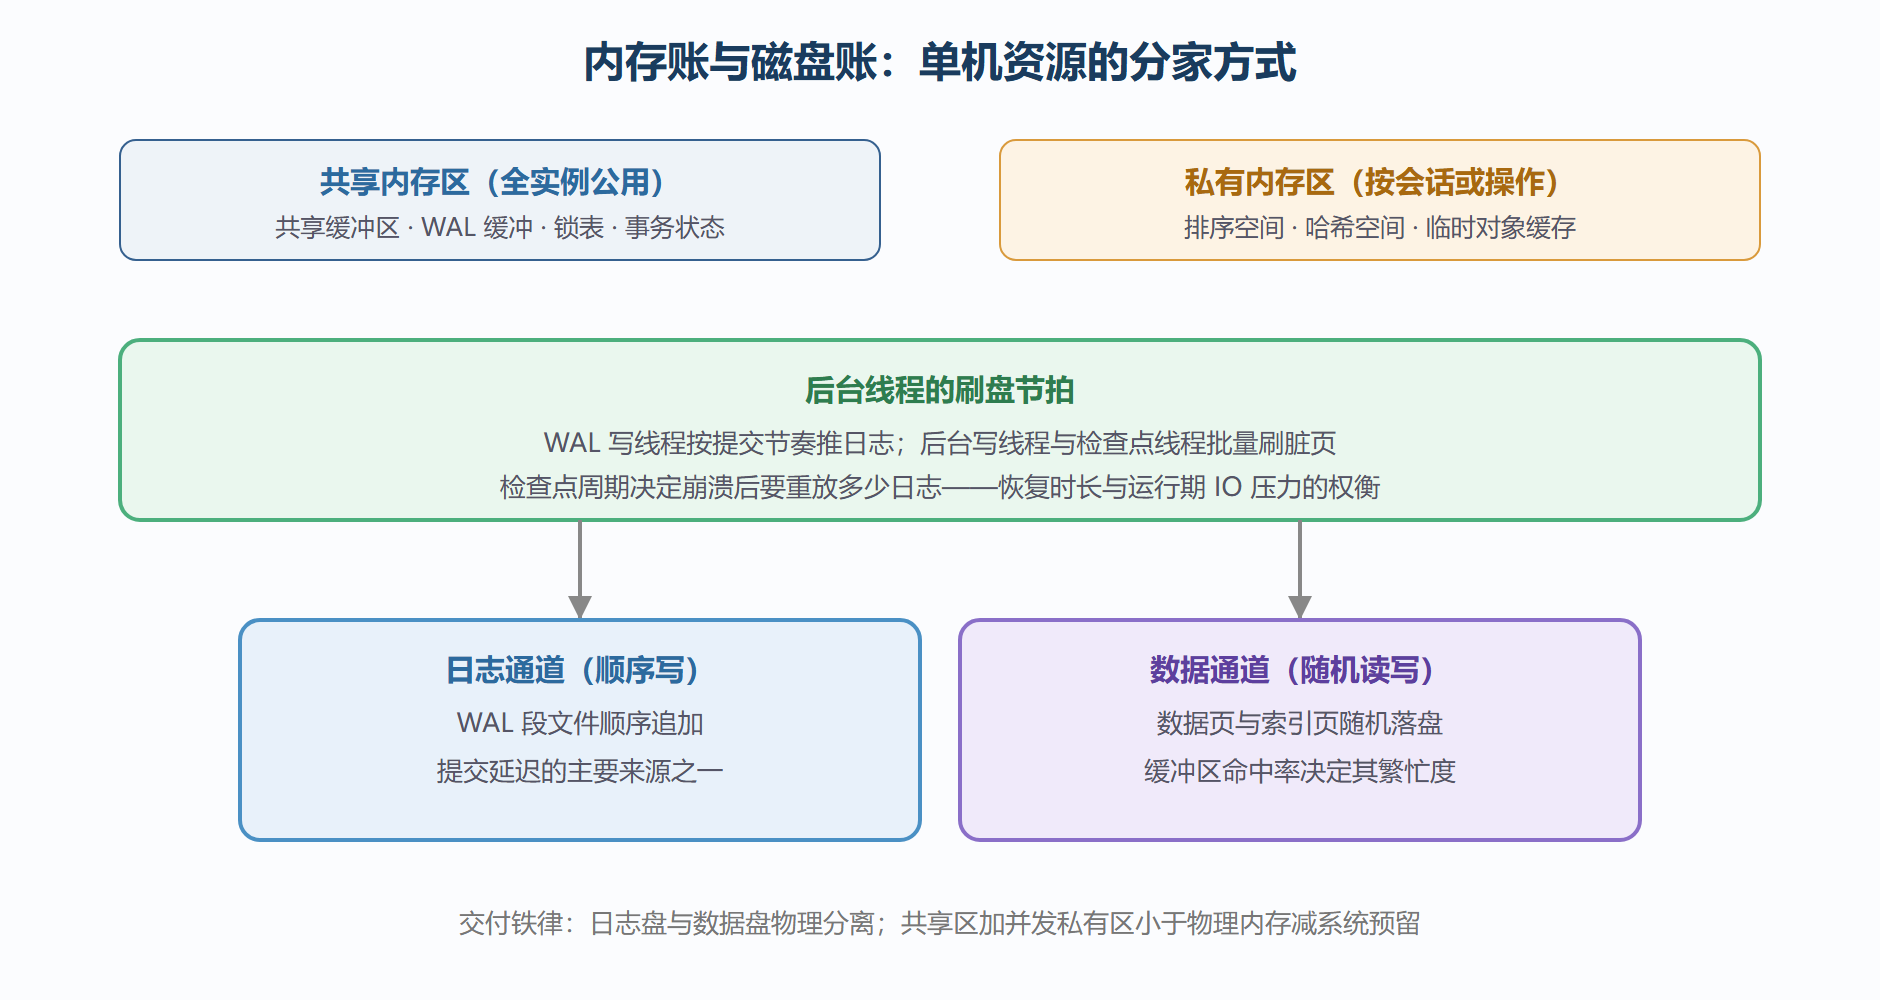
openGauss 的内存分两大块。共享区归全实例公用,最大头是共享缓冲区——数据页先读进这里,命中就不碰磁盘;此外还有 WAL 日志缓冲、锁表、预写日志相关的共享结构。私有区按会话或操作分配,包括排序、哈希连接的溢出空间与临时对象。两块的比例直接决定性能画像:共享缓冲区太小则命中率低、IO 频繁;排序空间太小则大批量查询频繁落盘;都给太大则操作系统缺页颠簸。数据库实例的常驻内存加上并发会话峰值内存,必须小于机器物理内存减去系统预留,这条不等式是容量规划的底线。
图:单机内存三层体系与磁盘 IO 双通道
磁盘账:双通道与两种写法
磁盘读写走两条性质完全不同的通道。日志通道是顺序写:WAL 段文件追加式前进,顺序写对机械盘和固态盘都友好,它是事务提交延迟的主要构成——同步提交模式下,每次提交要等日志落盘确认。数据通道是随机读写:缓冲区淘汰脏页、读未命中的数据页,负载形态由业务决定。由此推出装机铁律:日志盘与数据盘物理分离,避免随机 IO 把顺序写拖下水;重要系统再给归档单独一盘,让备份流量也不掺和。
巡检时验证两本账的常用口径:
-- 缓冲区命中率(长期低于九成五就要查工作集是否超出内存) SELECT sum(reads) AS total_reads, sum(hits) AS buffer_hits, round(sum(hits)::numeric / nullif(sum(reads) + sum(hits), 0) * 100, 2) AS hit_ratio FROM pg_statio_user_tables; -- 检查点相关参数与上次检查点时间 SHOW checkpoint_timeout; SELECT pg_last_xact_replay_timestamp(); -- 备机上还能反映回放进度
容量规划演练:把三本账算一遍
背景:新上一套订单库,业务方给的指标是峰值三千并发连接、热点数据约六百 GB、每秒约两万笔提交。算账过程:第一,线程账——三千连接走线程池,配置线程池上限为核数的若干倍,而不是三千个工作线程;第二,内存账——机器 256 GB,操作系统与监控预留约两成,共享缓冲区给约一百二十 GB 覆盖热数据头部,剩余留给私有区峰值;第三,磁盘账——两万笔提交按每笔日志量估算出日志带宽,配置 NVMe 日志盘独立于数据盘。上线后压测验证:缓冲区命中率九成九,提交延迟稳定在毫秒级,与账面一致。变式:若业务改为大批量夜间导入,日志带宽估算要按批量重算,检查点参数也要相应放宽,让批量期间刷盘更平缓。
线程池的两个高频疑问
疑问一:线程池上限设多大合适?没有万能数,但有一条算式化的思路——工作线程的并发上限乘以单会话平均内存占用,不能击穿私有内存的预算;同时线程上下文切换的开销在核数超额明显时陡增。经验区间是核数的一到四倍,最终值靠压测定:观察 CPU 利用率与吞吐曲线的拐点,吞吐不再上涨而延迟开始上翘处就是合理上限。疑问二:连接数和线程数什么关系?连接是逻辑会话,线程是物理劳力,线程池的意义就是让两者解耦——三千个连接可以共享几百个工作线程。由此推出告警口径:连接数告警看的是会话表的占用率,线程告警看的是排队长度,两个指标含义不同,混用会导致误判。
内存账的两条不等式与一个误区
两条不等式前面出现过,这里补上推导与误区。不等式一:共享缓冲区加日志缓冲加锁表等共享结构,加并发峰值时的私有区总占用,小于物理内存减操作系统与监控预留。违反的后果是缺页颠簸,性能断崖式下跌且极难排查——因为它不报错,只变慢。不等式二:单会话排序或哈希的内存上限,乘以并发执行这类算子的会话数,同样要并入私有区预算。常见误区是把不等式一算满格——给共享缓冲区分配到物理内存的七成以上,看似命中率优先,实则挤掉了私有区的余量,大批量报表一来就触发颠簸。稳妥的分配区间是五到六成给共享区,其余留给私有区峰值与系统,具体比例用你们业务的报表并发校准。
磁盘选型的实测方法
三盘分离定了盘的"身份",盘型与参数还要实测说话。基准测试三步:第一步,测顺序写带宽,反映日志通道的极限;第二步,测随机读写 IOPS 与延迟分布,反映数据通道的画像,注意看延迟的分位而不是均值——机械盘与固态盘的均值差距不大时,长尾差距可能仍然悬殊;第三步,测持续写稳定性,长时间顺序写看有没有出现周期性掉速(消费级固态盘的通病,缓存写满后速度腰斩)。实测结果留档,作为这台机器的"体检报告"——日后性能投诉时,拿实测基线对照当下表现,盘是不是老了、缓存策略是不是变了,一目了然。装机阶段省下的这一小时测试,日后要用十次故障复盘来偿还。
巡检脚本的雏形
把三本账的巡检固化成一个脚本的输出骨架,每次跑完一屏读完。线程账两行:活跃会话总数与等待事件分布的前三名;最长事务的时长与归属账号。内存账三行:缓冲区命中率的最近一小时均值、排序溢盘的当日次数、私有内存的峰值占用。磁盘账四行:数据盘、日志盘、归档盘各自的使用率与外推剩余天数、IO 延迟的最近峰值与基线对比。脚本的本质是把"巡检要看的九个数"变成一次回车——值班同学不需要记口径,只需要会看红灯。初版脚本不求自动化告警,先让人看得懂、跑得勤,跑稳了再接告警平台。这套渐进式的做法,比一步到位的"智能运维平台"更适合多数团队起步。
本节要点回顾
- 线程池是第一特征:连接多不等于线程多,等待事件视图是线程账的实时读数;
- 内存两分法:共享区看命中率,私有区看溢出,两条不等式守住容量底线;
- 磁盘双通道:日志顺序写、数据随机读写,物理分离是装机铁律;
- 检查点是枢纽:它同时决定恢复时长与运行期 IO 平滑度,第 7 章调优会回到这里;
- 巡检三问:线程忙不忙、命中高不高、日志盘满不满。
单机的账算清了,镜头拉远:一台不够用时,主备、一主多备、分布式各自怎么组织?下一节把形态演进讲透。