4.2 优化器与执行计划
4.2 优化器与执行计划
本节摘要:优化器用代价模型给每条候选路径算分:扫描方式、连接顺序、连接算法、数据搬运量都折算成估算代价,挑最低者生成执行计划。计划一旦读歪,调优就是盲打——本节给一套逐行阅读法与五个高频陷阱。
优化器不是在找最优,是在找估算最省
先立一个反直觉的认知:优化器从不运行你的查询来比较快慢,它在几毫秒内根据统计信息"估算"各路径的代价,选估算最低的。这个设计的推论极其重要——统计信息是优化器的世界观,世界观错了,选择必然歪。为什么不做穷举实测?一条五表连接的候选路径就有数千种,逐条试跑的代价远超查询本身。代价模型的输入只有三样:系统目录里的统计信息(行数、分布、相关度)、可用索引清单、可用的内存与并行配置。输出是一棵执行计划树。理解了输入输出的边界,"刷新统计信息治百病"这句现场谚语就有了理论根基:你没法改变代价模型,但你能喂给它准确的世界观。
执行计划逐行阅读法
拿一个最小例子建立阅读手感:
EXPLAIN SELECT o.order_no, u.user_name FROM orders o JOIN users u ON o.user_id = u.id WHERE o.created_at >= '2024-01-01' AND o.amount > 100; -- 典型输出(节选): -- Hash Join (cost=112.50..8764.20 rows=4230 width=64) -- Hash Cond: (o.user_id = u.id) -- -> Bitmap Heap Scan on orders o (cost=110.00..8600.00 rows=4230 width=40) -- Filter: ((created_at >= '2024-01-01') AND (amount > 100)) -- -> Bitmap Index Scan on idx_orders_created (cost=0.00..109.00 rows=4300 width=0) -- -> Hash (cost=22.50..22.50 rows=1000 width=36) -- -> Seq Scan on users u (cost=0.00..22.50 rows=1000 width=36)
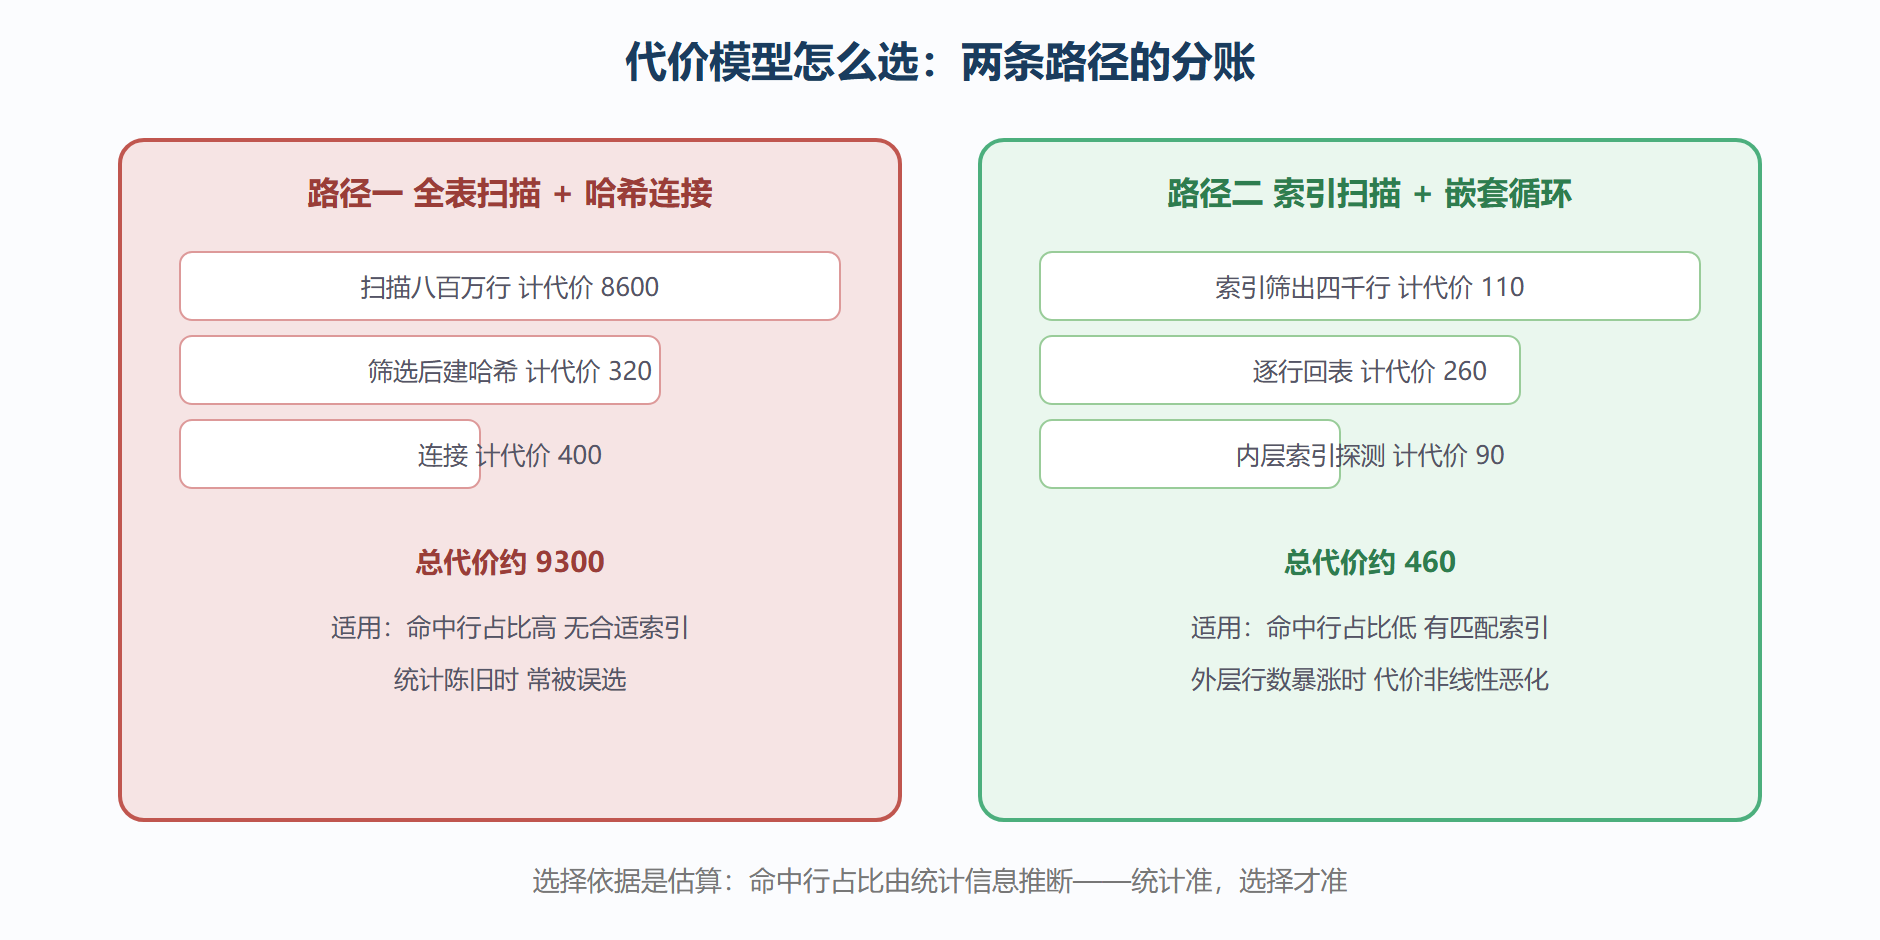
阅读顺序自上而下、由外而内:第一行是总入口,cost 左值是启动代价、右值是总代价,rows 是估算输出行数;缩进每深一层就是被调用的子节点,数据自下而上流动。这张计划的人话翻译:先用索引把一月以后金额过百的订单筛出来(位图扫描),同时对 users 全表建哈希表(小表一千万行以内全扫很正常),再把两边按 user_id 哈希连接。判断好坏的锚点不是"有没有 Seq Scan",而是三个配比:估算行数是否与业务直觉同量级、最贵节点的代价占总代价的位置、连接算法与小表一侧是否匹配。
图:同一条查询两条候选路径的代价构成对比
五个高频陷阱:计划歪掉的常见姿势
陷阱一,统计信息过期。批量导入后不刷新统计,优化器仍按旧行数估算,选中早已不合算的路径。规范:大批量导入或大规模删除后立即手动刷新,日常交给自动收集。陷阱二,隐式转换废索引(上节已述)。陷阱三,函数包列:对列套函数的条件写法(按日期函数过滤时间列)让索引失效,改写为范围条件即可。陷阱四,连接顺序突变:多表连接时中间结果估算失真,导致大表被过早连接,用引导提示或子查询固化合理顺序。陷阱五,内存不足算子溢盘:排序与哈希的内存配额过小,大作业落盘慢十倍——这是参数问题不是 SQL 问题,去第 7 章调 work 相关内存参数。
案例复盘:一次"计划漂移"的会诊
背景:某账单查询接口白天稳定两百毫秒,每月账期首日飙到八秒。取实际执行对比:慢时段计划显示对账单表全表扫描,快时段是索引扫描——同一条 SQL、两种计划。追因:账期首日凌晨跑批向账单表灌入当月数据,自动统计收集在跑批后、业务高峰前尚未完成,优化器拿着旧统计把新数据量估算小了三成,恰好跨过了"索引是否合算"的临界点。处置三件套:跑批脚本末尾追加统计刷新、为该表提高收集精度、接口对超时慢查询记录计划快照便于复盘。结果:次月账期首日稳定。这个案例的方法论价值:性能"漂移"通常是估算跨过了某个临界点,修复的对象是统计供给的时机与精度,而不是 SQL 文本。
统计信息的供给侧管理
既然统计信息是优化器的世界观,供给侧管理就值得单独讲。自动收集的机制:内核按表的变更比例触发自动收集,适合大多数稳态表。它照顾不到的三种场景需要人工介入:大批量导入后的立即刷新(变更比例的计算往往滞后于业务节奏);直方图需要更细粒度的大表(默认采样对倾斜分布估计不足,指定更高采样精度);关联列的扩展统计(两列强相关时,独立统计会严重高估或低估组合条件的选择性)。管理动作固化成脚本,挂在数据交付流程的尾部——"数据到位,统计到位"应当像"搬完家具关门窗"一样成为条件反射。监控侧再配一条:把每张核心表的最近收集时间纳入巡检,超过阈值的表自动提醒。统计信息的供给保障,是优化器调优里投入产出比最高的一件事。
计划固化与提示:什么时候该干预优化器
优化器偶尔也会"选错且屡教不改"——统计准确、索引齐全,它仍然固执地选一条次优路径。这时面临两个干预选项。计划提示:在语句级别给优化器提示连接顺序或扫描方式,见效快,但把优化责任从内核挪到了代码,语句一变就失效。结构改写:用子查询、条件重写等结构性手段引导优化器,更稳定但需要理解优化器的判断逻辑。决策顺序建议:先改写后提示;提示只作为过渡手段,注释里写清"为什么需要提示、什么条件下可以移除",否则提示会在代码里沉积成无人敢动的化石。极端情况下还有 plan 固化类机制兜底,但那是最后的手段——固化 Plans 的维护成本,会随业务变化逐年上涨。
计划阅读的进阶:读懂数据倾斜
普通的计划阅读之外,倾斜场景需要多看一眼。分布倾斜的表(某些键值占据绝大多数行)会让基于均匀分布的估算系统性失真:优化器以为某个值只占百分之一的行,实际占六成,计划在真实参数下崩坏。识别信号:同一查询在不同参数值下性能天差地别——快如闪电与慢如蜗牛并存,这是倾斜的典型指纹。应对手段按优先级:对倾斜列收集更精细的统计(提高采样或建扩展统计),让优化器看见分布的真实形状;应用侧对已知的热值走专用查询路径;实在不行用提示固化合理计划。倾斜是很多"玄学性能问题"的最终答案——当你用尽常规手段仍解释不了计划时,往倾斜方向查,常有收获。
一次完整的计划诊断记录
把方法串成一个可模仿的诊断记录。现象:账务汇总查询白天一秒内,晚间八点后恶化到七秒。取证:取恶化时段的实际执行账单,发现连接算法从哈希连接变成了嵌套循环,外层估算行数从八百涨到五万。追问:为什么晚间估算暴涨?对照数据分布——晚间的批次作业刚灌入当天的对账数据,中间结果表的统计停留在导入前,优化器按旧统计认为外层只有几百行,于是选了"小表驱动的循环探测",真实执行时外层是五万行,内层索引被探测五万次。处方:批次作业尾部追加统计刷新;同时给这条查询所在的事务加计划快照记录,便于下次直接对照。验证:次日晚间同查询回到一秒二。整个诊断的每一步——取账单、比估算、查统计、定处方、做验证——都是本节与上节方法的直接套用,读者可以按这个格式整理自己环境里的每一次诊断。
本节要点回顾
- 代价模型三输入:统计信息、索引清单、内存配置——喂准统计是第一杠杆;
- 阅读三锚点:估算行数量级、最贵节点位置、连接算法与表大小匹配;
- 存在 Seq Scan 不代表错:小表全扫、高占比命中都是合理选择;
- 五陷阱清单:统计过期、隐式转换、函数包列、连接顺序、算子溢盘;
- 计划漂移看时机:先问"统计信息在性能变化前发生了什么",再动 SQL。
路径选好了,谁来跑?下一节进入执行引擎,看看每个算子怎么干活、真实时间去哪了。