5.2 备份与恢复实战
5.2 备份与恢复实战
本节摘要:备份的价值只在恢复时兑现:全量基础备份加 WAL 归档可以恢复到任意时间点,但策略配置、恢复演练、异机存放三件事缺一不可。本节给出策略选择表、完整恢复演练流程,以及一次"备份是好的、恢复却失败"的教训复盘。
一段历史:为什么老 DBA 都有恢复强迫症
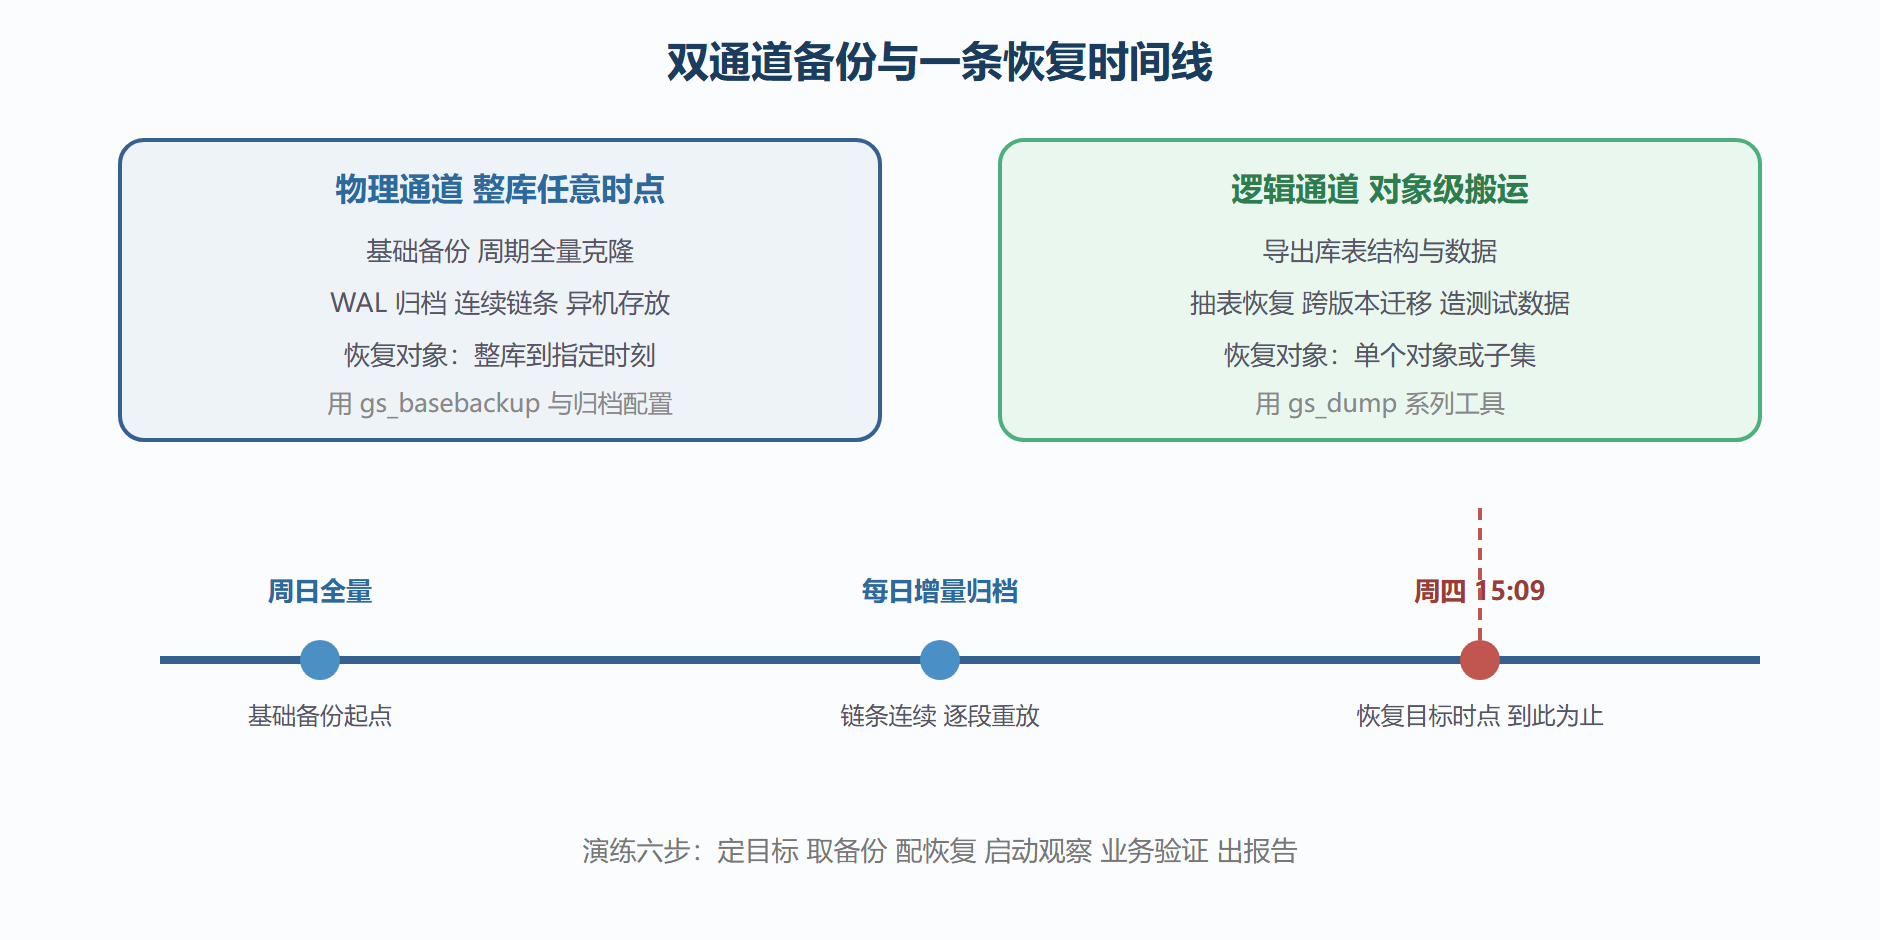
数据库行业流传一句老话:没有验证过恢复的备份,等于没有备份。这句警告的背景是无数真实事故——备份任务每天显示成功,事故当天恢复时才发现归档断了两周、或备份集缺表空间、或恢复出来的库根本起不来。openGauss 的备份体系把物理备份(基础备份加日志归档)与逻辑导出(按库按表导出对象与数据)做成两条并行通道,各有分工。物理备份管"整库回到任意时刻",逻辑导出管"抽几张表、跨版本搬运、给开发造测试数据"。两通道都要配、都要验,这是策略层的第一共识。
策略表:三个变量定一套备份方案
| 变量 | 选项 | 适用与代价 |
|---|---|---|
| 基础备份频率 | 每日 / 每周 | 频率高则恢复快、归档链条短,占空间与 IO;大库常用每周全量加每日增量 |
| 归档保留期 | 七天 / 三十天 | 越长越能回溯到久远时点,占存储;受监管行业按合规要求定 |
| 恢复目标 | 最新时点 / 指定时点 | 最新时点应对硬件故障;指定时点应对误删除——把库恢复到事故前一秒 |
归档配置是物理备份的中枢:开启归档模式后,每段写满的 WAL 都会复制到归档目录,恢复时用基础备份加归档重放。归档目录必须异机存放——与数据目录同盘的归档在盘坏时一起陪葬,等于没归档。检查归档连续性是日常巡检项,断档就是恢复链条断裂。
# 查看归档配置与最近归档状态(示意查询) gsql -d postgres -c "SHOW archive_mode;" gsql -d postgres -c "SELECT archived_count, last_archived_wal FROM pg_stat_archiver;" # 执行一次基础备份到指定目录 gs_basebackup -D /backup/base_$(date +%F) -X stream # 逻辑导出单库(与物理备份并行的第二条通道) gs_dump -f /backup/logic_app.sql -d appdb -F p
恢复演练全流程:把"应该行"变成"验证过行"
季度恢复演练的标准脚本如下,全程在演练机执行,不碰生产。
第一步,圈定恢复目标:演练场景设为"周四下午三点十分误删了一张核心表",目标恢复到三点九分。第二步,取最近的基础备份(比如周日的全量)到演练机。第三步,配置恢复参数:指向归档目录、声明恢复到指定时间点、声明恢复完成后进入正常服务。第四步,启动恢复并观察日志:数据库会先重放基础备份内的日志,再依次取归档重放,直到时间点后自动停下并转正。第五步,业务验证:核对表行数、抽查关键记录、跑只读冒烟用例。第六步,出具演练报告:耗时、归档用量、发现的问题、改进项。
# 恢复阶段的关键配置(写入演练机恢复用配置文件,示意) # restore_command = 'cp /archive/%f %p' 从归档目录取日志 # recovery_target_time = '2024-06-13 15:09:00' 恢复到指定时点 gs_ctl start -D /restore/data # 日志中观察:recovery stopping before commit ... reached recovery target
图:备份恢复体系的双通道与恢复时间线
教训复盘:一次失败的恢复
某系统磁盘故障后按预案恢复,基础备份完好、归档文件齐全,恢复却在半路报归档缺失。追查发现:三周前一台代理服务器迁移,归档目录路径随系统配置变更悄悄变了,归档表面仍在成功——成功到新路径,而所有演练文档都指向旧路径。恢复链条断在三周前,无人知晓。三课写进交付规范:其一,归档路径变更必须走变更单并触发一次恢复演练;其二,巡检不能只看"归档任务成功",要核对归档落点与恢复文档的一致性;其三,季度演练的演练机配置从文档生成而不是从记忆生成——文档与现实的偏差,正是演练要抓的另一类"隐患"。
备份策略的成本核算
备份不是免费的,策略定级前把三笔成本算清楚。存储成本:全量备份的体积乘保留代数加归档的增量累积——四 TB 的库按周全量保四周,仅备份本体就是十六 TB 起,归档再往上加。窗口成本:全量备份期间的数据读取会与业务争 IO,四 TB 的全量在共享盘上可能持续数小时,限速与错峰是必选项,备份专用存储通道是重要系统的标配。恢复成本:RTO 的承诺要能被"全量恢复加归档重放"的实测耗时兑现,备份越老、归档链越长,恢复越慢——这就是"全量频率与恢复时长成反比"的原理。三笔账算完,你会理解为什么行业里普遍是"周全量加日增量加实时归档"的折中结构:它是在三个成本之间取的工程平衡点,而不是哪本书的教条。
逻辑导出的三个实战细节
逻辑导出看着简单,细节决定它在关键时刻靠不靠谱。细节一,一致性边界:导出期间业务在写,导出的就是"开始时刻的快照",跨表关联的一致性由快照保证——但前提是你的导出模式开启了一致性快照,别用错参数。细节二,大表溢出:单表导出超过内存或文件系统的单文件上限时要分片,按主键范围切片导出,切片边界要无缝衔接——对账时按片核对。细节三,版本跨越:用旧版本工具导出的文件未必能直接灌进新版本,跨版本迁移时优先用目标版本自带的工具执行导出导入;实在要跨,先在小规模样本上验证。这三个细节都属于"出事才知道疼"的类型,把它们写进备份规范的成本几乎为零。
恢复演练的进阶场景
基础恢复演练通关后,加练两个进阶场景,覆盖更真实的故障形态。场景一,误删单表的时间点恢复:整库恢复到指定时刻再抽取误删的表回灌生产——比整库回退的爆炸半径小得多,练习重点在"恢复到时刻后如何只取一张表"的操作细节。场景二,归档部分损坏的恢复:模拟某几段归档文件损坏,练习在缺口处停止、评估可用恢复点、与业务方沟通"最多能恢复到几时几分"的完整决策过程——真实事故里,"恢复到最接近的完好点"远比"完美恢复"常见。两个场景练熟,团队对备份体系的信心就从"应该行"升级为"最坏情况也试过"。演练记录同样归档:它们是审计与客户尽调时最有说服力的材料之一。
备份系统的告警与自证
备份体系自己也要有监控,否则它会静悄悄地烂掉。四条必备告警:备份任务失败或超时(最基本,但常有项目只配了失败没配超时——卡死的备份比失败的更隐蔽)、归档连续性中断(上一段归档之后超过预期时间没有新归档)、备份体积异常(比上周缩水三成以上,往往意味着数据集意外变小或任务没跑全)、恢复演练逾期(演练日历到期未执行,自动提醒)。再加一条自证机制:每次备份完成后自动做一次可恢复性抽检——从备份集抽取一小段做恢复验证或校验和核对。这四加一配齐,备份体系才算有了自愈的眼睛。某单位的事故复盘里有一句扎心的话:"备份监控只配了成功通知,失败通知配在另一个没人看的群里"——告警的去向与告警本身同等重要。
恢复演练的数据核对方法
恢复完不代表恢复对了,核对方法决定演练的可信度。三层核对法:对象层,比对新旧库的表数量、索引数量、各表行数——工具自动完成,任何差异都是红字;内容层,按关键业务表抽样比对(按主键抽千分之一的行做字段级对照),抽样要覆盖最大表、最老数据、最新数据三类;业务层,跑一遍只读的业务校验用例(对账脚本、汇总报表),数字对上才算业务确认。三层全绿,这次演练才算真正通过。有一层经常被省略——业务层,但它恰恰是唯一能让业务方放心的证据。把三层的核对工具与脚本固化进演练手册,每次演练按表执行,核对结果归档。演练的可信度就是这么一层层堆出来的。
本节要点回顾
- 双通道并行:物理备份管整库任意时点,逻辑导出管对象级搬运与测试数据;
- 归档是中枢:异机存放、连续性巡检、路径变更走变更单;
- 恢复时间线:基础备份起点加归档链条加目标时点,三要素缺一不可;
- 演练六步:定目标、取备份、配恢复、启动观察、业务验证、出报告;
- 备份的验证标准只有一个:演练机上能否按文档独立恢复成功。
增量与存量都有保障了,极端场景呢?下一节把容灾层级与切换决策摆上桌。