7.2 监控与诊断
7.2 监控与诊断
本节摘要:监控的目标不是"什么都采",而是"故障发生前三十分钟有人知道"。本节按系统资源、数据库内核、业务体验三层搭建仪表盘,给出每层的关键指标与阈值依据,再配一条值班工程师的第一响应路径。
一次成功的"未遂故障"
某周五晚上八点,值班群收到告警:主库磁盘使用率预计七十二小时后写满。值班工程师点开趋势图,发现是周六凌晨的归档任务叠加业务增长让增速变陡,评估后当晚挂载扩容盘、调整归档策略,周一早上业务方对整个过程毫无感知。这就是监控的理想形态:告警抢在故障前面,处置在业务无感时完成。它依赖两件事:指标分层(知道看什么)、阈值有依据(知道多严重算严重)。本节就把这两件事讲透。
三层仪表盘:各答一个层次的问题
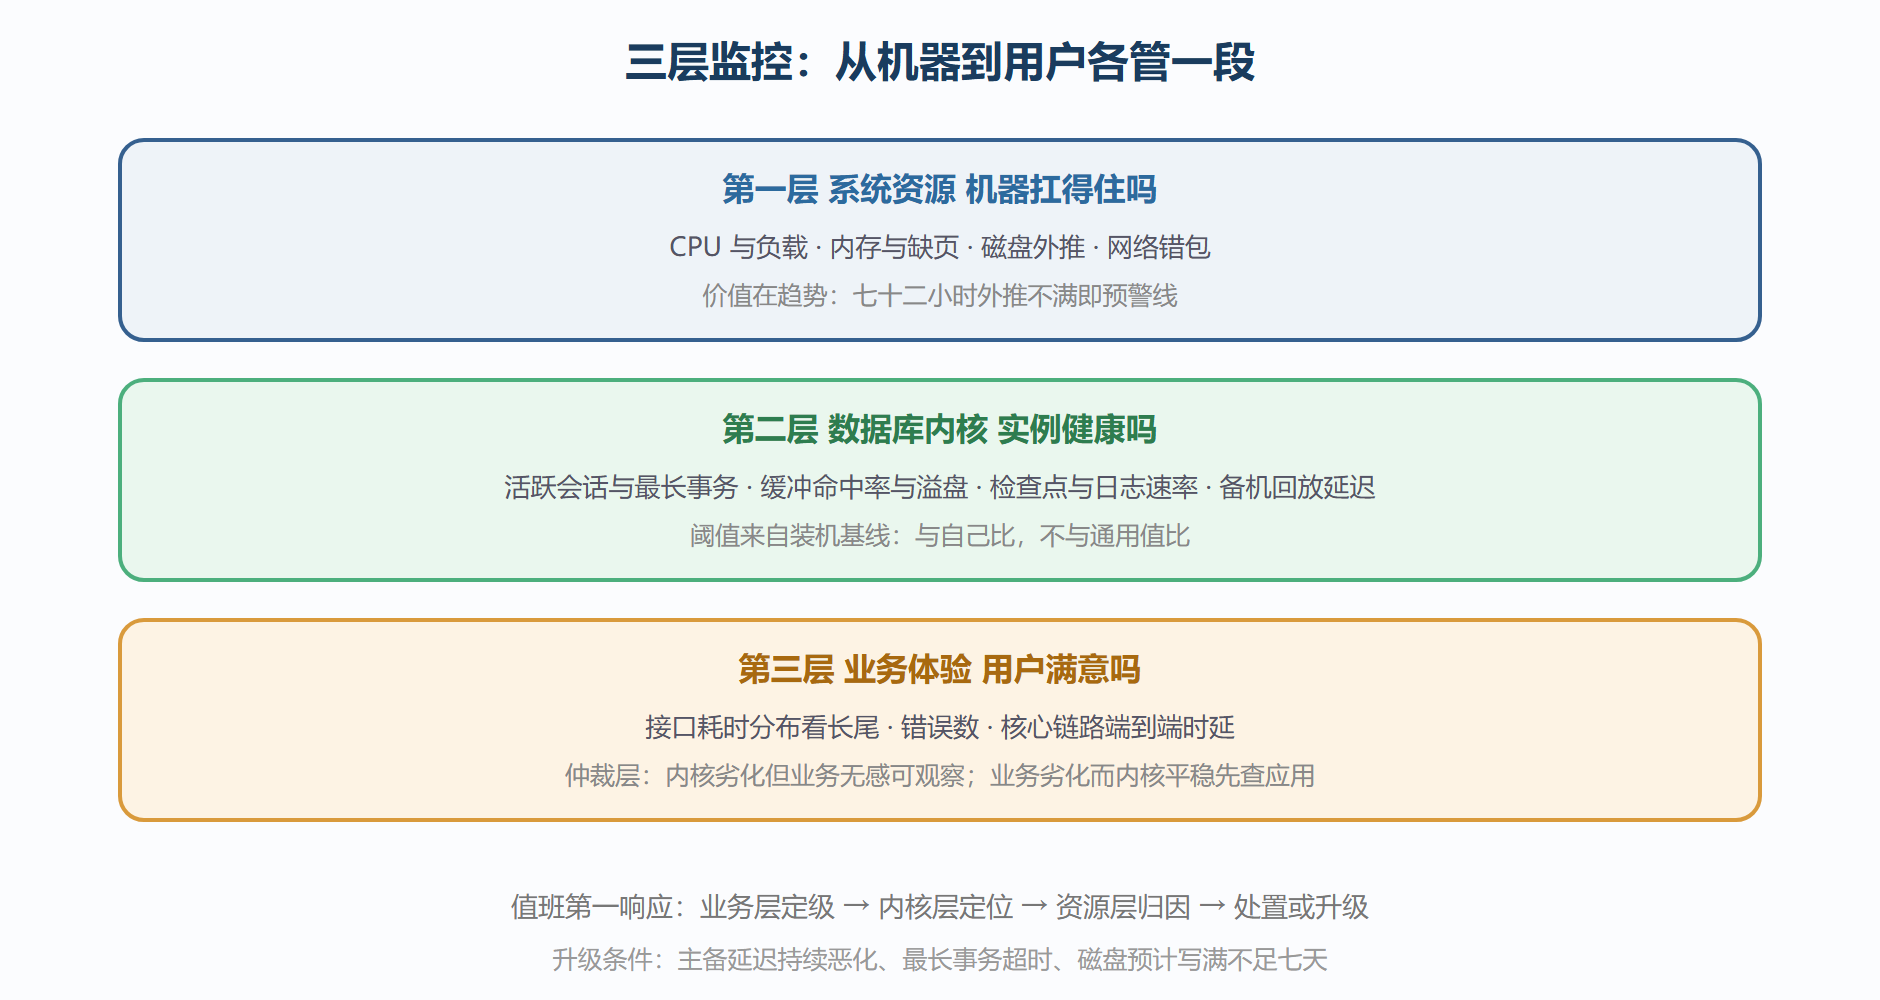
第一层,系统资源层,回答"机器扛得住吗"。采集 CPU 使用与负载、内存使用与缺页、磁盘利用率与 IO 延迟、网络带宽与错包。这一层的价值在趋势而非瞬时值:磁盘使用率的线性外推是最简单有效的容量预警,缺页率抬升往往早于性能投诉数天。阈值依据:磁盘按"七十二小时外推不满"设预警线;IO 延迟按盘型设基线(NVMe 与机械盘差一个量级),连续超基线即告警。
第二层,数据库内核层,回答"实例健康吗"。核心指标与第 2 章三本账一一对应:线程账看活跃会话数与连接使用率、最长事务时长;内存账看缓冲区命中率、排序溢盘次数;磁盘账看检查点间隔、日志产生速率、归档延迟;加上主备链路的回放延迟(第 5 章设过双阈值)。这层的阈值在装机基线表里定,与容量规划同源——命中的是"你们自己的正常",不是通用推荐值。
第三层,业务体验层,回答"用户满意吗"。接口耗时分布(看长尾不看均值)、单位时间错误数、核心业务链路的端到端时延。它是前两层的仲裁者:内核指标轻微劣化但业务无感,可以只观察不动手;业务长尾抬升而内核指标平稳,说明问题可能出在应用或网络,数据库先自证清白再排查。
图:三层监控体系与值班响应路径
值班响应路径:告警来了的固定动作
第一响应的价值在于动作固定、不靠灵感。第一步,定级:业务层有没有受损?有,按故障流程拉群升级;无,进入排查通道。第二步,定位:打开内核层仪表盘,按三本账过一遍——会话堆积还是命中率跌了、检查点拖长还是日志速率异常、主备延迟是否恶化。第三步,归因:下钻系统层与数据库视图,把现象收敛成一句话("归档盘写入延迟抬升导致检查点变慢")。第四步,处置或升级:有预案的按预案执行(清理线程卡住、切流、扩容),没预案的带着收敛后的归因升级给二线——把"数据库好像有点慢"翻译成"归档盘 IO 延迟抬升三倍导致检查点间隔翻倍",升级效率天差地别。
诊断时最常用的几个视图,值得背下来直接敲:
-- 当前谁在消耗资源:活跃会话与等待事件分布 SELECT state, wait_event_type, count(*) AS cnt FROM pg_stat_activity WHERE state <> 'idle' GROUP BY state, wait_event_type ORDER BY cnt DESC; -- 最长未结束事务:长事务是膨胀与延迟的共同根源 SELECT pid, usename, now() - xact_start AS xact_age FROM pg_stat_activity WHERE xact_start IS NOT NULL ORDER BY xact_start LIMIT 5; -- 表级 IO 热点:哪些表在被疯狂读写 SELECT relname, heap_blks_read, heap_blks_hit FROM pg_statio_user_tables ORDER BY heap_blks_read DESC LIMIT 10;
告警纪律:别让狼来了三次
监控体系最常见的死法是告警疲劳:阈值拍脑袋导致天天误报,值班习惯性忽略,真故障淹没在噪音里。三条纪律保命:每条告警必须有对应的响应动作——收到后不知道做什么的告警删掉或降级为报告;每次误报都要修阈值或修采集口径,把误报当缺陷管理;告警分级后,紧急类只留"需要立刻动手机会窗在流失"的场景(主备断链、磁盘将满、实例不可用),其余进日报周报。一条实战检验标准:连续一个月,每条紧急告警都值得被打断——做到了,监控才真正活着。
监控数据的留存与对比分析
监控的价值随时间复利:单点读数只能看当下,历史序列才能看趋势与因果。留存策略:细粒度数据保两周(排障用),聚合到分钟级保一年(趋势与容量规划用),聚合到小时级保三年(年度容量评审用)。对比分析的三个经典用法:同比看周期(本周与上周同时段比,排除业务周期干扰)、环比看突变(变更窗口前后的指标阶跃,直接指向变更影响)、相关性看因果(磁盘延迟曲线与检查点曲线叠放,肉眼可见的因果链)。把三个用法做成固定的周报图组,团队对"正常波动"的直觉会越来越准——监控体系的终极形态不是告警,是团队对系统的肌肉记忆。
一次完整排障的记录模板
值班排查要有留痕,好记录是团队的复利资产。推荐五段式模板:现象(时间、告警、业务影响面)、定位(看了什么仪表盘与视图,按顺序列出,排除项也记)、归因(一句话结论加支撑数据)、处置(动作清单含参数前后值)、复盘(这条经验要不要变成告警规则或预案条目)。五段写下来通常不超过一页纸,但它让"我处理过了"升级为"团队学会了一个案例"。积累半年后,这份记录库会变成最个性化的排障知识库——比任何外部文档都贴合你们的环境。附一条软规则:复盘段落必须回答"下次如何提前发现",回答不了的就去补监控或补预案。
监控分层的一个完整实例
把三层仪表盘落到一个具体实例上,让抽象分层变成可抄的清单。第一层系统资源配四块图:CPU 使用率与负载双线、内存使用与缺页率双轴、各盘使用率外推线、网卡流量与错包数。第二层内核层配五块图:活跃会话数与等待事件分布堆叠图、缓冲区命中率趋势、检查点间隔散点、日志产生速率、主备回放延迟双阈值线。第三层业务层配三块图:核心接口耗时分布(均值与两条分位线)、错误数按类型堆叠、关键业务链路的端到端时延。十二块图看着多,其实每块都对应一两个采集项,接齐约两天工作量。验收标准:用这套面板回看一次历史故障,能否在三分钟内完成定级与定位——能,面板合格;不能,缺哪块补哪块。面板不是给老板看的大屏,是给值班用的工具,好不好用值班同学说了算。
诊断视图的组合技
单个视图看局部,组合使用才能出证据链。三组经典组合。组合一,等待事件分布加表级 IO:等待显示大量 IO 等待,再看表级读排行,两个视图交叉命中的那张表就是当前 IO 的主要消耗者——一条告警从"有 IO 等待"收敛到"这张表的这个查询",用时不超过两分钟。组合二,最长事务加死元组比率:膨胀异常时查最老事务,两者时间线吻合,即可下"长事务阻塞清理"的结论。组合三,连接数曲线加应用发布记录:连接数阶梯式上涨的拐点对上某次发布,新增的连接泄漏点就在那次发布的代码里。组合技的要领是"时间轴对齐加维度交叉"——单一视图回答是什么,组合视图回答为什么。这三组组合建议直接写进值班手册的排障章节,配上前面的 SQL,构成可复制的标准动作。
本节要点回顾
- 三层分工:资源层管趋势,内核层管健康,业务层做仲裁;
- 阈值与自己比:内核阈值从装机基线表来,不用通用推荐值;
- 响应四步:定级、定位、归因、处置或升级,归因要收敛成一句话;
- 三个视图背下来:等待事件分布、最长事务、表级 IO 热点;
- 告警要修:无动作的告警删,误报当缺陷,紧急类只留真紧急。
看得见问题了,接下来是治——下一节讲参数调优的先后顺序,避免无效劳动。