3.2 表与索引组织:堆、B 树与设计纪律
3.2 表与索引组织:堆、B 树与设计纪律
本节摘要:同一批数据行,可以散住在堆里,也可以按聚集键码齐在 B 树上;非聚集索引是另行维护的导航目录,列存储是面向分析的第三种住法。本节讲清四种组织方式的机制与代价,并入建表设计纪律(命名、范式、索引取舍),目标是给你一套"新表落库前先过一遍"的设计清单。
堆与树:数据的两种住法
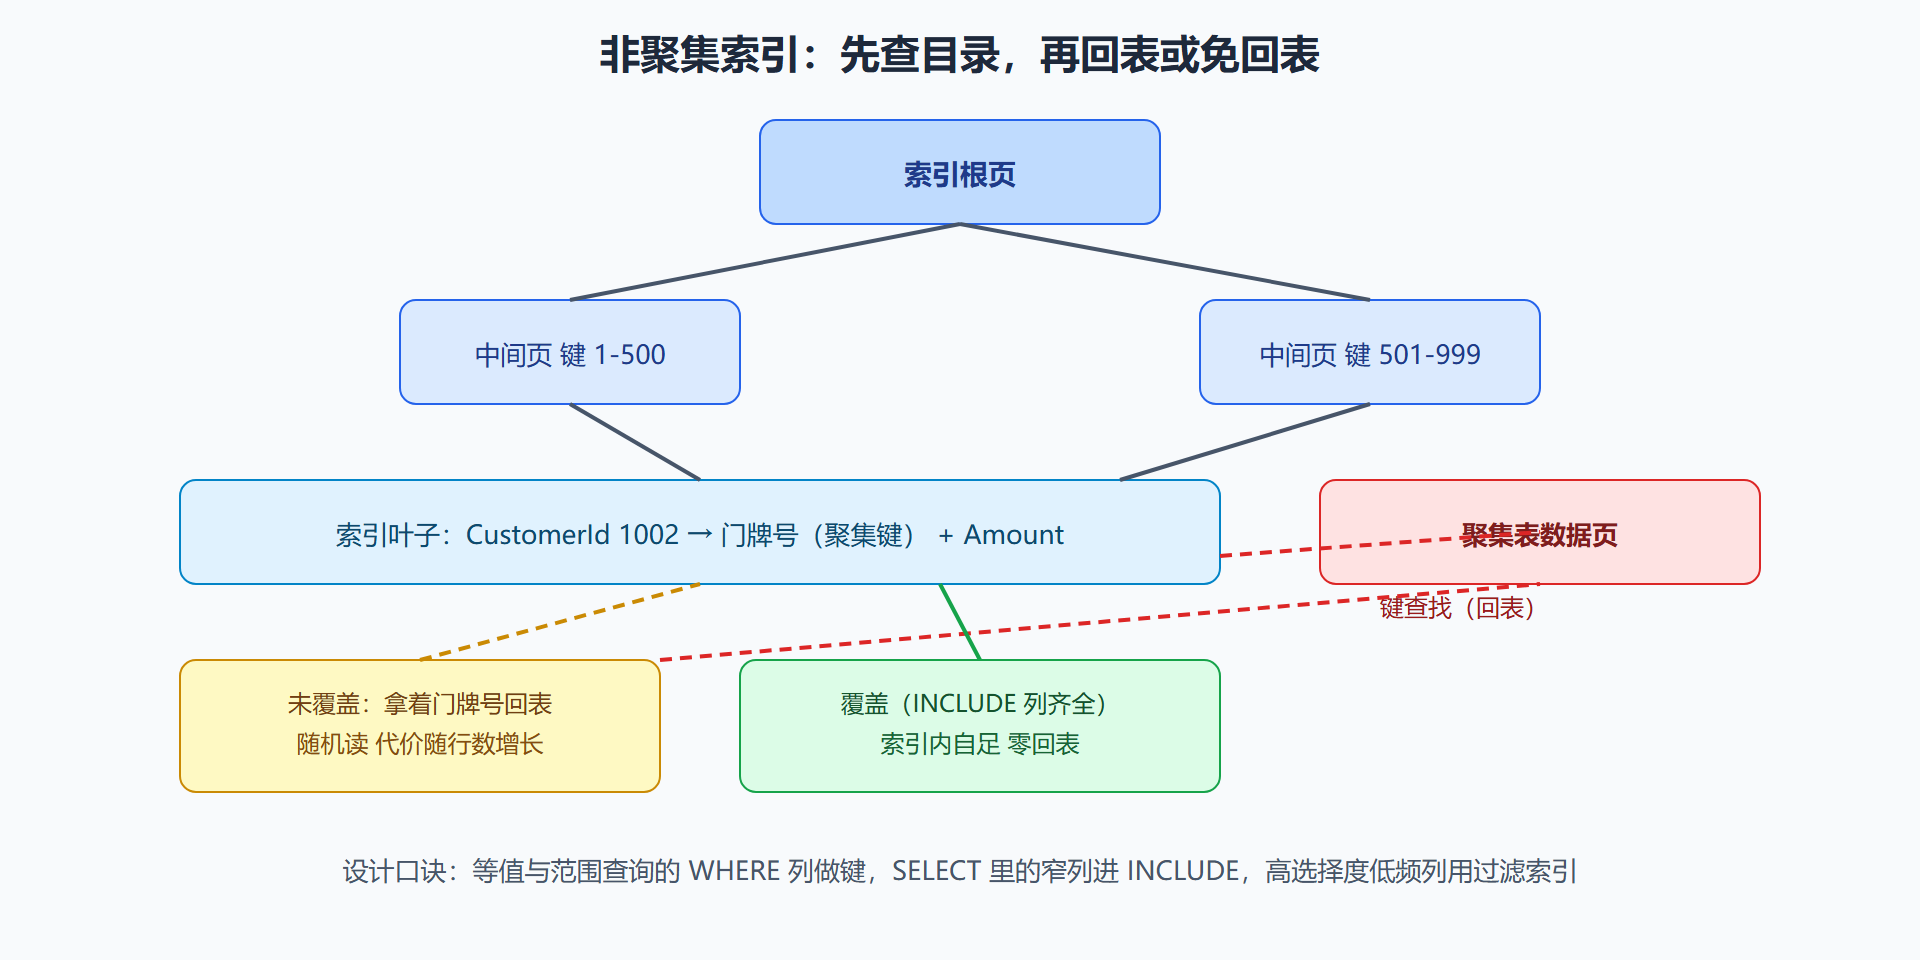
没有聚集索引的表叫堆:数据行按到来顺序散放,行在页里的位置用"文件号比页号比槽号"的物理地址(RID)标识。堆的写入快(往哪塞都行),但除了全表扫描没有任何快速通道,且更新大字段时行会"搬家"留下转发指针。给表建了聚集索引,行就按聚集键的顺序物理组织成 B 树:根节点与中间节点是路标页,叶子节点就是数据页本身。聚集键同时成了每行的"门牌号"——所有非聚集索引的叶子都存着这个门牌号,用来回表找数据。
选择的关键在聚集键。它最好是递增的(如自增 ID 或时间戳):新行永远追加到 B 树最右侧,页拆分少、碎片少。若是随机的键(比如 GUID 主键当聚集索引),每条新插入都可能落在树的任意位置,拆页频繁、碎片横生——这是新手最常踩的设计雷,实测写入吞吐能差出数倍。聚集键还要尽量窄:它会被复制进每一个非聚集索引的叶子层,键宽一字节,全库所有索引跟着宽一字节。
-- 三种住法落库对比 CREATE TABLE dbo.Orders_Heap ( OrderId BIGINT IDENTITY, CustomerId INT, Amount DECIMAL(12,2), CreatedAt DATETIME2 ); -- 堆:无索引,最快写入 CREATE CLUSTERED INDEX CIX_Orders ON dbo.Orders_Heap (OrderId); -- 变成聚集组织:按 OrderId 排布,范围扫描与点查都有通道 CREATE NONCLUSTERED INDEX IX_Orders_Customer ON dbo.Orders_Heap (CustomerId, CreatedAt) INCLUDE (Amount) -- 覆盖列:查询要的数都在索引里 WHERE Amount > 0; -- 过滤条件:只索引有效行,瘦一半
非聚集索引:导航目录的经济学
非聚集索引是独立于数据的一棵 B 树:键列有序排列,叶子层存"键值加门牌号"。查询走索引的过程是先查目录再回表(键查找),回表是随机读,代价高;把查询要取的列全部塞进索引(INCLUDE 包含列)就能免去回表,这叫覆盖索引。索引设计的核心经济问题在写放大:每个索引都是一份要同步维护的副本,表上索引越多,INSERT 与 UPDATE 越慢。判断口诀是"看读写下账":读多写少的报表表可以大方铺索引,高频写入的交易表只留必要通道。删索引前先看使用统计,别凭感觉:
SELECT i.name AS 索引名, s.user_seeks AS 走过次数, s.user_scans AS 全扫次数, s.user_lookups AS 回表次数, s.user_updates AS 被维护次数 FROM sys.dm_db_index_usage_stats s JOIN sys.indexes i ON i.object_id = s.object_id AND i.index_id = s.index_id WHERE s.database_id = DB_ID() AND i.name IS NOT NULL; -- 被维护次数上万而走过次数为零的索引,是挂名领薪的负资产(先观察一个完整业务周期再动手)。
第三种住法是列存储:按列切页、压缩存放,配合批处理模式执行,分析查询能快一个数量级以上,代价是单行更新代价高——通常用"聚集列存储加增量刷新"的姿势服务数仓场景,第 9 章展开。第四种是内存优化表(第 5 章讲它的并发控制),数据整体住内存,写入走无锁路径,适合高频小事务。
图 3-2 B 树索引与回表路径
落表纪律:一张新表的十分钟检查单
老教材把它叫数据库设计规范,我更愿意叫落表纪律,因为它是动作不是知识。命名:表用业务名词单数或复数统一风格,索引前缀区分类型(CIX 聚集、IX 非聚集、UQ 唯一),别让半年后的自己猜。范式:默认走到第三范式,消除传递依赖;刻意反范式(冗余列)必须有维护它的更新路径与理由记录。数据类型:能用 DECIMAL 不用 FLOAT 存金额,能用 DATE 不用字符串存日期,变长列给合理上限而不是一律 MAX。主键与聚集键:优先窄而递增的键,随机 GUID 当聚集键需给出专门理由。索引:每个高频查询形态对应一个索引,宁少勿滥,铺完用使用统计跟踪一个月。约束:业务唯一性交给 UNIQUE 约束而不是应用层检查,外键按团队运维成熟度取舍——要删也要留下"为什么没有"的记录。这张清单不保证设计最优,但能挡住八成的常见返工。
索引碎片的真相与整理阈值
索引用久了会碎,但"碎"有两种,对策完全不同。外部碎片是页的逻辑顺序与物理顺序错位、页间不连续——它拖慢的是范围扫描(多一次逻辑读就多一次页定位);内部碎片是页的填充稀疏(拆页后一半空着)——它放大的是同样数据占用的页数。两种碎片都能从目录视图里量化。整理动作也有两档:重组(REORGANIZE)在线、可中断、只整理叶级不更新统计,适合碎而不乱的日常维护;重建(REBUILD)离线(在线重建要企业版)或用在线选项、重置页填充、顺带更新统计,适合大修。工程口径按外部碎片的百分比定档:低于一成不处理,一到三成走重组,三成以上走重建,每周作业分批执行、宁窄勿宽。要警惕的误区是"碎片万能论"——碎片高但查询只走点查(单行查找),整理的收益约等于零;整理决策要看访问路径,不要只看数字。
填充因子的设置同样反直觉:它不是越低越好。调低填充因子等于预留空白页空间,降低拆页频率的同时放大读取页数——只有更新密集、中间插入频繁的索引才值得把填充降到八到九成,只追加的递增键索引默认满填充就是最优。
本节要点回顾
- 堆快写慢查,树有路标:无索引是堆、有聚集索引是 B 树,组织的本质是给数据修路;
- 聚集键三原则:递增、窄、稳定,随机 GUID 当聚集键是碎片制造机;
- 非聚集索引是副本经济:每个索引都拖慢写入,铺索引前先算读写账;
- 覆盖索引免回表:INCLUDE 塞齐查询列,键查找随机读直接消失;
- 使用统计是裁员的证据:维护上万次、走零次的索引,观察完整业务周期后再删;
- 列存储服务分析、内存表服务高频事务:四种住法各有主场,别用一种住法打全场。
数据怎么摆的学问齐了。但每一笔改动要怎么记账,才能在断电崩溃后一分不差地找回来?下一节进入事务日志与恢复机制——存储引擎的心脏。