4.3 统计信息与基数估计:优化器的眼睛
4.3 统计信息与基数估计:优化器的眼睛
本节摘要:优化器不碰数据就能估出"这个条件会命中多少行",靠的是统计信息——直方图加密度构成的数据画像。本节讲清画像怎么画、何时更新、新版基数估计器改了什么行为,以及四类系统性估错场景的识别与预防。把 4.1 的流程和 4.2 的办案串起来,最终都归结到这一节:证据质量决定判决质量。
优化器不是神仙,它靠猜
先摆正心态:优化器永远在猜行数——它不可能为每个查询真的扫一遍表。它猜的依据是统计信息对象:每个统计对象描述一列或一组列的值分布,核心是两件东西。直方图把首列的值域切成最多二百个台阶,记录每个台阶的边界值、等值行数与区间行数——谓词落在台阶里,估计就相对靠谱。密度回答"平均多少行共享一个值",服务于直方图覆盖不到的组合列与跨表推算。多列统计只有首列有直方图,其余列只有密度——这就是为什么复合条件下估数偏差大、为什么有时要手工建多列统计。
-- 打开一份证据卷宗 DBCC SHOW_STATISTICS ('dbo.客户表', 'IX_客户_城市') WITH STAT_HEADER, HISTOGRAM; -- STAT_HEADER 看 Rows 与 Rows Sampled:采样比例太低,画像本身就糙; -- HISTOGRAM 看 RANGE_HI_KEY 与 EQ_ROWS:新数据的值不在台阶里时, -- 估计会退化到密度或平均,这正是"估 1 实际 3000"类案件的作案手法。
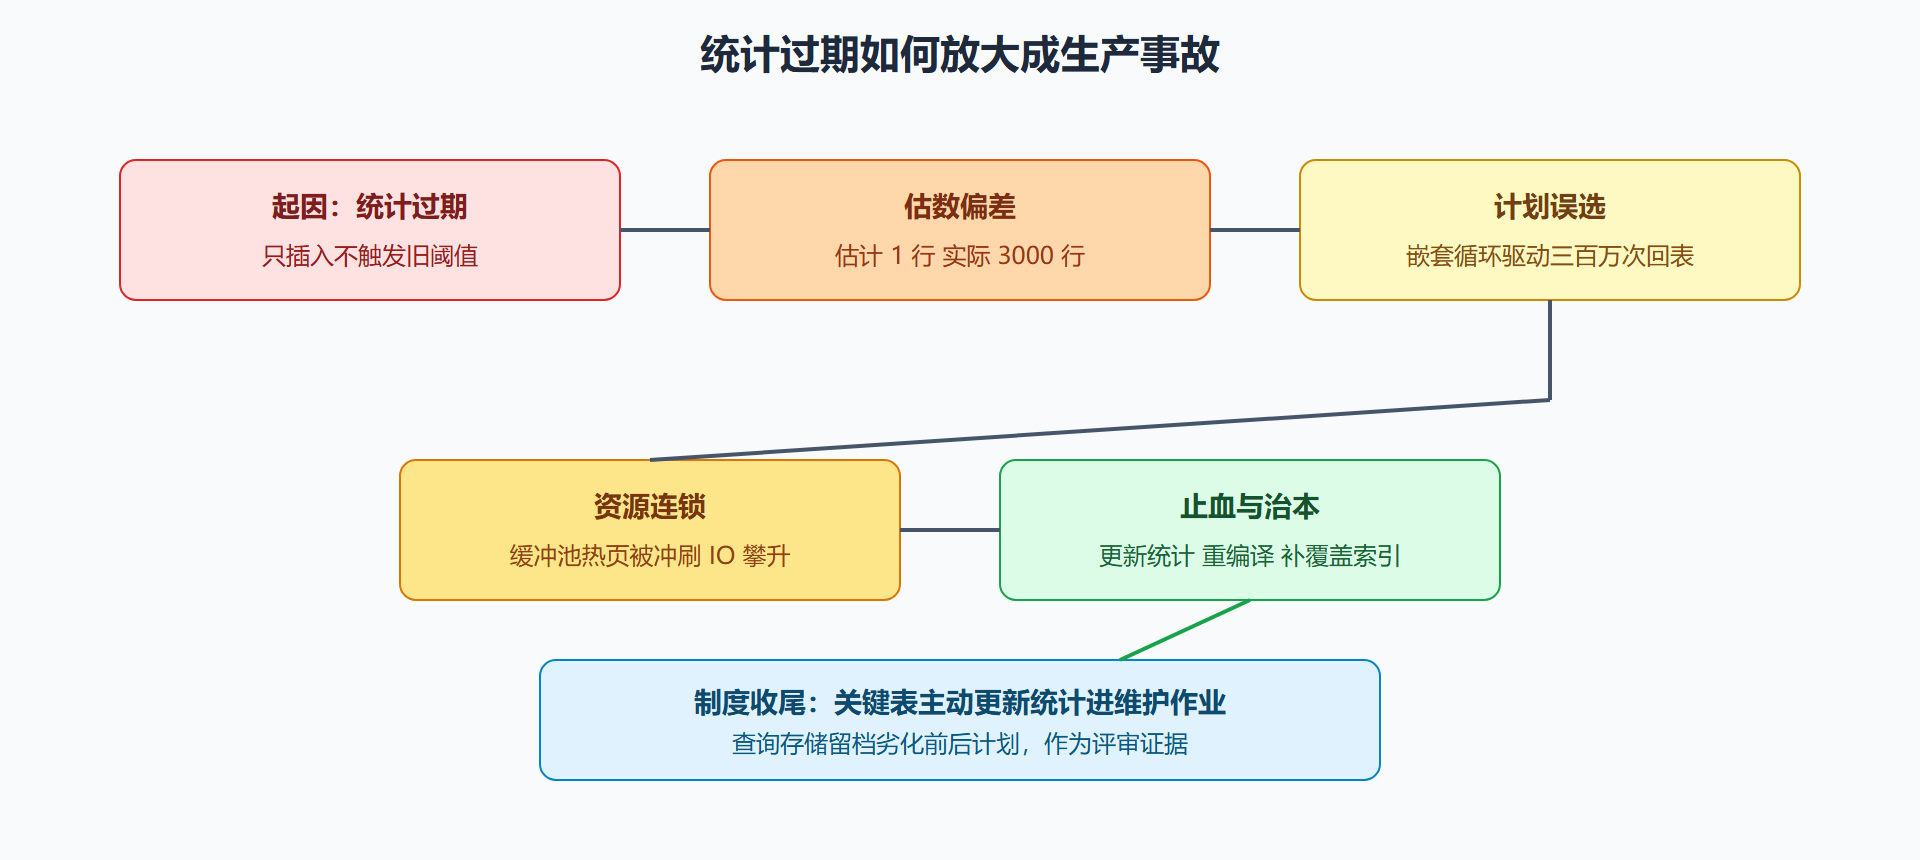
统计信息的更新靠两条自动规则兜底:查询引用时若列无统计则自动创建;修改行数越过阈值则自动触发异步或同步更新。旧阈值是"五百加两成的行数变化",对亿级大表意味着要改两千万行才更新一次——月度批量的表,月中统计必然过期。2016 版 130 兼容级别之后改为动态阈值:表越大,触发更新的比例越低,倾斜明显缓解,但依然不覆盖"只插不改"的增长型表和跨月分布迁移——所以生产实践里,关键表必须有主动更新统计的维护作业,自动更新只是安全网不是保障线。
四类系统性估错与各自的解法
第一类是上升局部性:查询条件命中刚插入的新数据,而统计还没画进直方图——月末查当月订单必然中招,解法是关键表高频主动更新统计,或对敏感语句加重编译。第二类是变量隐藏:局部变量与多语句表变量的行数,编译阶段不可知,估计器只能拍一个保守常数——存储过程里先取参数再查列表的写法是重灾区,解法是 OPTION RECOMPILE 或改写为内联表值函数。第三类是跨表推算与谓词合并:两个独立谓词的联合选择性按默认包含性假设相乘,真实数据若相关性强(城市与商圈高度相关),估数会系统性偏小——解法是手动建多列统计,或改写让优化器分开估。第四类是参数嗅探,4.1 已详述,本质是"一份画像服务所有参数"的必然矛盾,解法从重编译到参数敏感计划优化分档选择。
⚠️ 有一类"假性估错"要排除在外:计划里估计行数是编译时刻的产物,实际行数是执行时刻的事实,两者本来就允许在合理范围内不一致。办案标准要定量:偏离两个数量级以上、或偏离方向直接改变了计划形状(比如从查找变扫描、从循环变哈希),才判定为估错并追根因。
新基数估计器:换了脑子之后的脾气
2014 版重写了基数估计器(新 CE),与旧版的行为差异值得入册。新版取消了某些旧的上升局部性猜测(旧版会拿直方图最大值猜"最新数据"),对多表连接的包含性假设也从包含改为基础——整体更"冷静",但对上升型负载的某些查询,估数反而更悲观,出现升级后个别查询变慢的迁移阵痛。兼容级别是开关:改数据库兼容级别即切换估计器。迁移实战的规矩是:升级前用查询存储把关键查询的计划与耗时存底,升级后逐日对比,发现劣化先用计划强制回退止血,再针对劣化查询做统计与写法层面的适配,绝不一把升级了事。
图 4-2 一次估错的因果放大链
统计更新的工程选项
更新统计不是一条语句那么简单,选项组合决定质量与代价。采样率:默认采样在大表上可能失真,关键表定期全量扫描(FULLSCAN)最稳,代价是扫描全表的时间——用维护窗口换精度。持久采样率:对"每次都按比例采样但比例总不合适"的表,把采样率持久化,避免每次更新时重新估算。分区统计:按分区递增统计(2014 后)让数据加载只更新受影响分区的统计,夜间批量加载的大表受益明显——加载快了,统计也新鲜了,一举两得。
落地节奏建议四条:核心交易表的统计更新频率与业务节奏对齐(月末批量表就在批量后更新);报表事实表每次加载后立即全量更新(加载窗口内顺手做);自动更新阈值保持开启作为安全网;所有主动更新进代理作业并记录耗时趋势——耗时突增往往提示表倾斜或索引膨胀,统计作业意外成为体检哨兵,这是运维里少有的"一鱼两吃"。
最后补一个取证技巧:判断某查询是否吃了统计过期的亏,看计划缓存的编译时间戳与最近一次统计更新的先后——计划编译在统计更新之前,它的估计行数就是旧画像的产物,重编译后对比两次计划形状,过期的影响量化成前后两份计划,给业务方解释时一目了然。
一个动手实验:亲眼看估错的放大
在一个测试库上花十分钟能复现本章全部因果:建一张表插十万行,建索引后统计更新一次;再插五万行但不更新统计;查一条按新数据范围的查询,对比估计行数与实际行数——偏离立现;然后手动更新统计重编译,两次计划形状的差异就是"统计过期税"的实测值。这个实验的价值不在结论(结论本章已给),而在肌肉记忆:亲手造出一次估错的人,看到生产计划里的行数偏离会有条件反射级的敏感。建议把它固化成团队新人的一道练习题,比读三遍文档更有效。
本节要点回顾
- 统计信息是画像:直方图画首列值域、密度管组合列,画像质量决定估计质量;
- 自动更新是安全网:动态阈值缓解了大表倾斜,但只插不改的表仍需主动作业更新;
- 四类系统性估错:上升局部性、变量隐藏、相关性假设、参数嗅探,各有对应解法;
- 判错要定量:偏离两个数量级或改变计划形状才算估错,别把正常的估计误差当病;
- 新 CE 更冷静:兼容级别切换估计器,升级靠查询存储存底、计划强制止血、逐项适配收尾;
- 一句心法:执行计划里的怪形状,八成能在统计信息里找到第一因。
查询处理三章闭环了:流程、现场、证据。下一章进入并发现场——当两条查询同时改一行数据,锁与事务如何维持秩序,死锁又如何在秩序里滋生。