5.3 内存优化表的并发控制:乐观并发实战
5.3 内存优化表的并发控制:乐观并发实战
本节摘要:内存优化表(In-Memory OLTP)把数据整体放进内存、用无锁结构与乐观并发重写了写入路径:不拿锁、不留锁、提交时验冲突,撞车的事务整体失败重试。本节讲清这套机制的原理、写入冲突的应对模式,以及什么负载值得搬、什么负载搬过去是坑。它是传统锁体系的镜像教材——理解它,反而更能看清锁体系的取舍。
换一种并发世界观
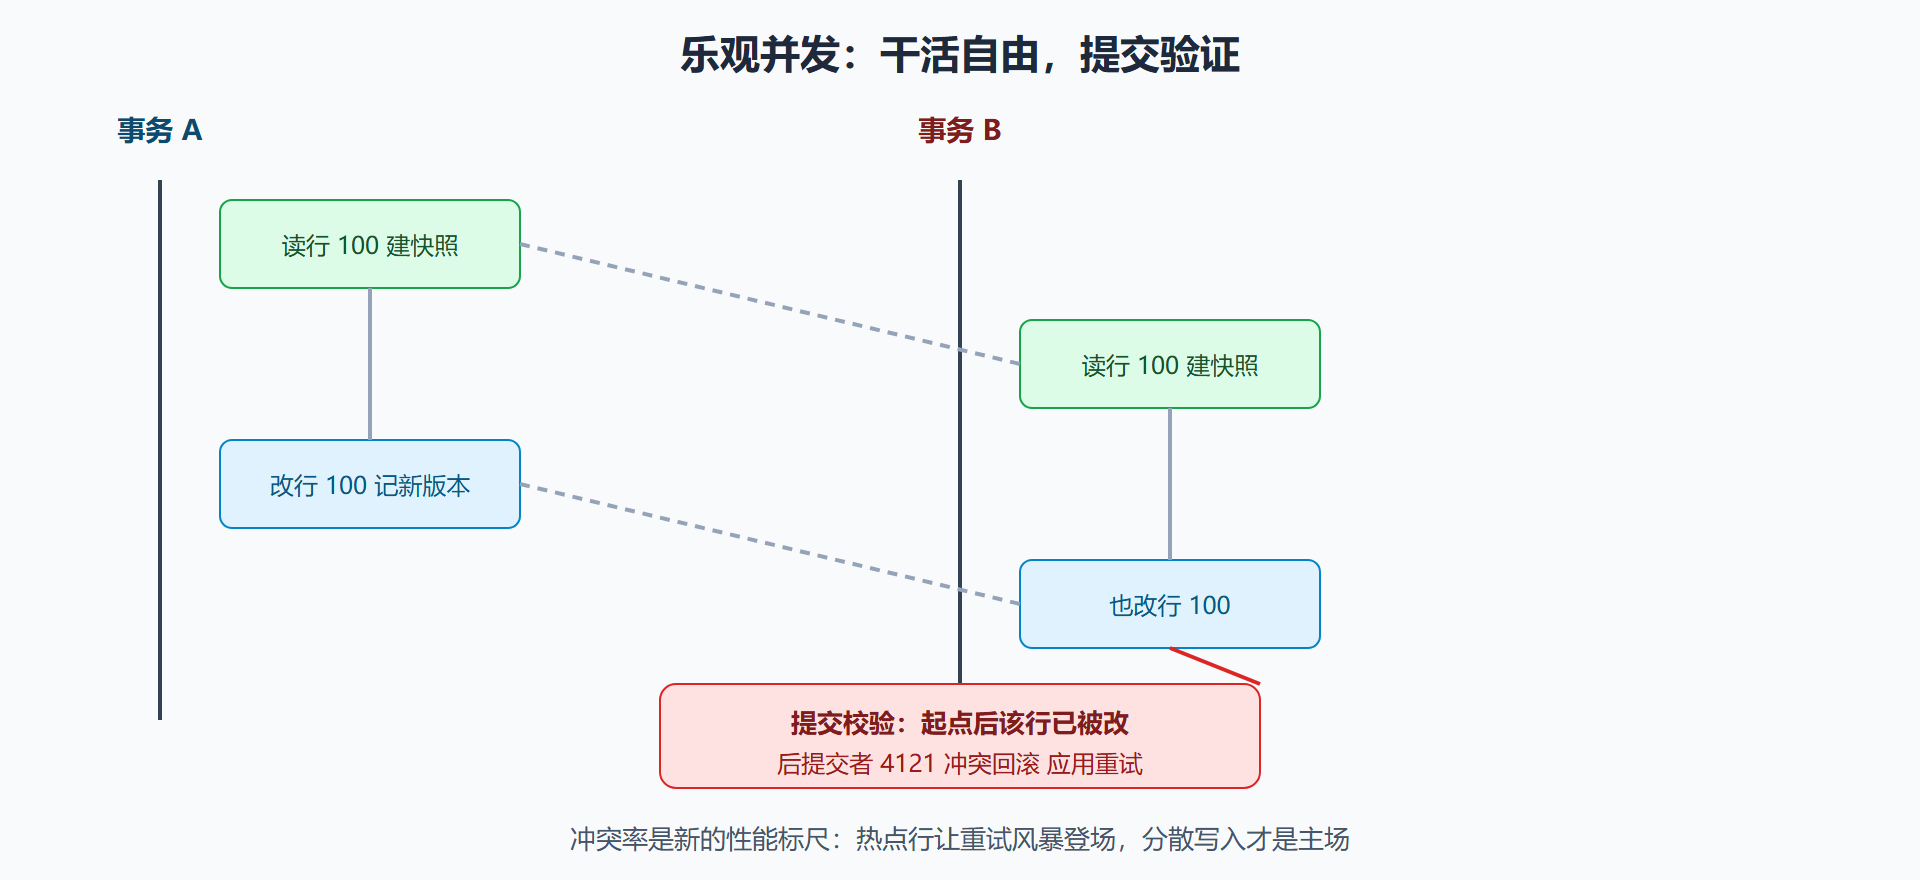
传统磁盘表走悲观路线:动数据前先把锁拿到手,宁可排队不可出错。内存优化表走乐观路线:干完活提交时才验证"我改的行这段时间有没有被别人改过",没冲突直接提交,有冲突整个事务回滚,由应用决定重试。支撑它的是行版本机制:每次更新不是原地改,而是生成新版本,老版本挂进链表由后台垃圾回收;提交校验沿版本链检查起点之后是否出现并发写。没有锁管理器介入、没有等待队列,高并发写入的吞吐能比磁盘表高出一个数量级——代价是把"排队等"换成了"失败重试",冲突率成为新的性能标尺。
这套机制对应用有硬性要求:冲突重试必须成为代码的一部分。写入热点的表(所有请求都挤同一行,比如全局计数器)在乐观体系下冲突率飙升,重试风暴反而拖垮吞吐;而写入分散的交易负载(订单、会话、库存多行)冲突率天然低,正是内存引擎的主场。
-- 建一张内存优化表:DURABILITY 决定断电后剩多少 CREATE TABLE dbo.Sessions ( SessionId BIGINT NOT NULL, UserId INT NOT NULL, LastSeen DATETIME2 NOT NULL, CONSTRAINT PK_Sessions PRIMARY KEY NONCLUSTERED HASH (SessionId) WITH (BUCKET_COUNT = 1048576), -- 哈希索引桶数按预期行数的1到2倍估 INDEX IX_Sessions_User NONCLUSTERED (UserId) ) WITH (MEMORY_OPTIMIZED = ON, DURABILITY = SCHEMA_AND_DATA); -- SCHEMA_AND_DATA:结构加数据都持久(日志照记,断电可恢复) -- SCHEMA_ONLY:只保结构,重启清空——适合缓存与暂存场景
索引与持久化:内存世界的两处不同
内存表的索引是另一套物理学。哈希索引以空间换绝对速度:桶数在建表时定死,估算错误(严重偏小)会造成哈希桶内长链,性能断崖——预估行数的一到两倍是经验口径,改桶数要重建索引,上线前务必用真实数据量演练。范围索引(B 树的内存变体)支持范围扫描与排序,通用于不确定点查的场景。持久化方面,内存表依然记事务日志(这是断电恢复的凭据),但恢复方式是把检查点文件流里的数据直接映射回内存,速度远快于传统重放;SCHEMA_ONLY 模式连数据日志都不留,等于用持久性换极致写入,缓存型负载专用。
图 5-2 乐观提交:从干活到验证的时序
搬迁决策:哪些负载值得搬
正面清单:高频小事务(会话、令牌、购物车、行情快照),单事务操作行数少、写入分散、要求毫秒级响应——内存引擎的甜点区。ETL 中转暂存:SCHEMA_ONLY 模式做入库缓冲,重启即清,省去清理作业。老系统的锁风暴救火:锁等待计数居高不下、且冲突集中在少数表,把这几张表搬进内存常能立竿见影。负面清单:大范围分析查询——内存引擎没有列存储那套批处理生态,分析负载请去第 9 章;写入天然热点的表——全局计数器、单行状态机,乐观冲突无解,这类需求该用原子更新或队列化改造;依赖大量 T-SQL 表面构造(某些旧式过程代码)的场景——原生编译过程性能最好但语法受限,解释执行的互操作又有跨引擎事务的代价,改造前先评估代码存量。
搬迁本身的工程纪律:先用内存优化顾问扫描库,看哪些表与过程能搬、有多少阻塞点;磁盘表的触发器、部分类型约束在内存表上不支持或受限;跨引擎事务(同一事务同时碰内存表与磁盘表)有额外的日志与锁代价,设计上尽量让单事务只涉一边。内存配额要入册管理——内存引擎的内存单独计量,Standard 版有上限,放任内存表长大是新的"内存不足"事故源。
内存 OLTP 的运维清单
内存表上线不是终点,四项运维要跟上。内存用量监控:内存优化数据的消耗单独计量,从资源池视图按库查,增长曲线要像对待日志文件一样纳入容量预警——它不参与缓冲池的换出,涨了就是真涨。检查点文件对:内存表的持久化靠数据与差异文件对,合并由后台自动完成,但磁盘预留要按数据量的两到三倍规划,文件对增长异常提示合并滞后。冲突率统计:从引擎计数器观察提交冲突率,持续上升说明访问模式在向热点集中,是负载形态变化的早期信号。交叉事务纪律:同一事务同时触碰内存表与磁盘表有额外的日志与锁代价,设计评审时把"单事务单引擎"作为默认原则,跨界必须给出理由。
还有一个实用建议:把内存表的迁移决策写进架构评审模板,包含负载画像(每秒事务、行宽、冲突预估)、回退方案(内存表不可直接转回磁盘表,要新建表搬数据)、以及演练记录。迁移不可逆的特征决定了它必须像手术一样术前评估,而不是像配置一样随手就改。
本节要点回顾
- 乐观并发三步走:建快照、自由改、提交时验版本,冲突方回滚重试,锁队列整个消失;
- 重试是代码的一部分:冲突错误号 4121 类必须被应用捕获重试,这是使用乐观体系的门票;
- 哈希索引看桶数:按预期行数一到两倍定桶,估错断崖,上线前用真实量演练;
- 持久化两档:SCHEMA_AND_DATA 走日志加检查点文件流,SCHEMA_ONLY 重启清空只做缓存;
- 搬迁看负载形态:高频分散小事务是甜点区,写入热点表与重分析负载别搬;
- 内存配额入册:内存引擎的内存单独计量、版本有上限,增长要监控。
悲观与乐观两种并发世界观都齐了。下一章把镜头从单机秩序转向企业级命题:机器会坏、机房会断,高可用与灾难恢复如何兜底。