9.1 列存储与数据仓库分析:从行到列
9.1 列存储与数据仓库分析:从行到列
本节摘要:分析查询慢,不是因为数据大,而是因为行存储让"只看一列"的查询被迫搬运整行。列存储索引按列切页压缩、配合批处理模式执行,聚合查询提速一个数量级是常态。本节讲清它的原理、增量更新的短板与混合索引策略,并用一次真实的报表提速案收尾。它是 SQL Server 扛混合负载(HTAP)的核心武器。
为什么分析查询爱列存储
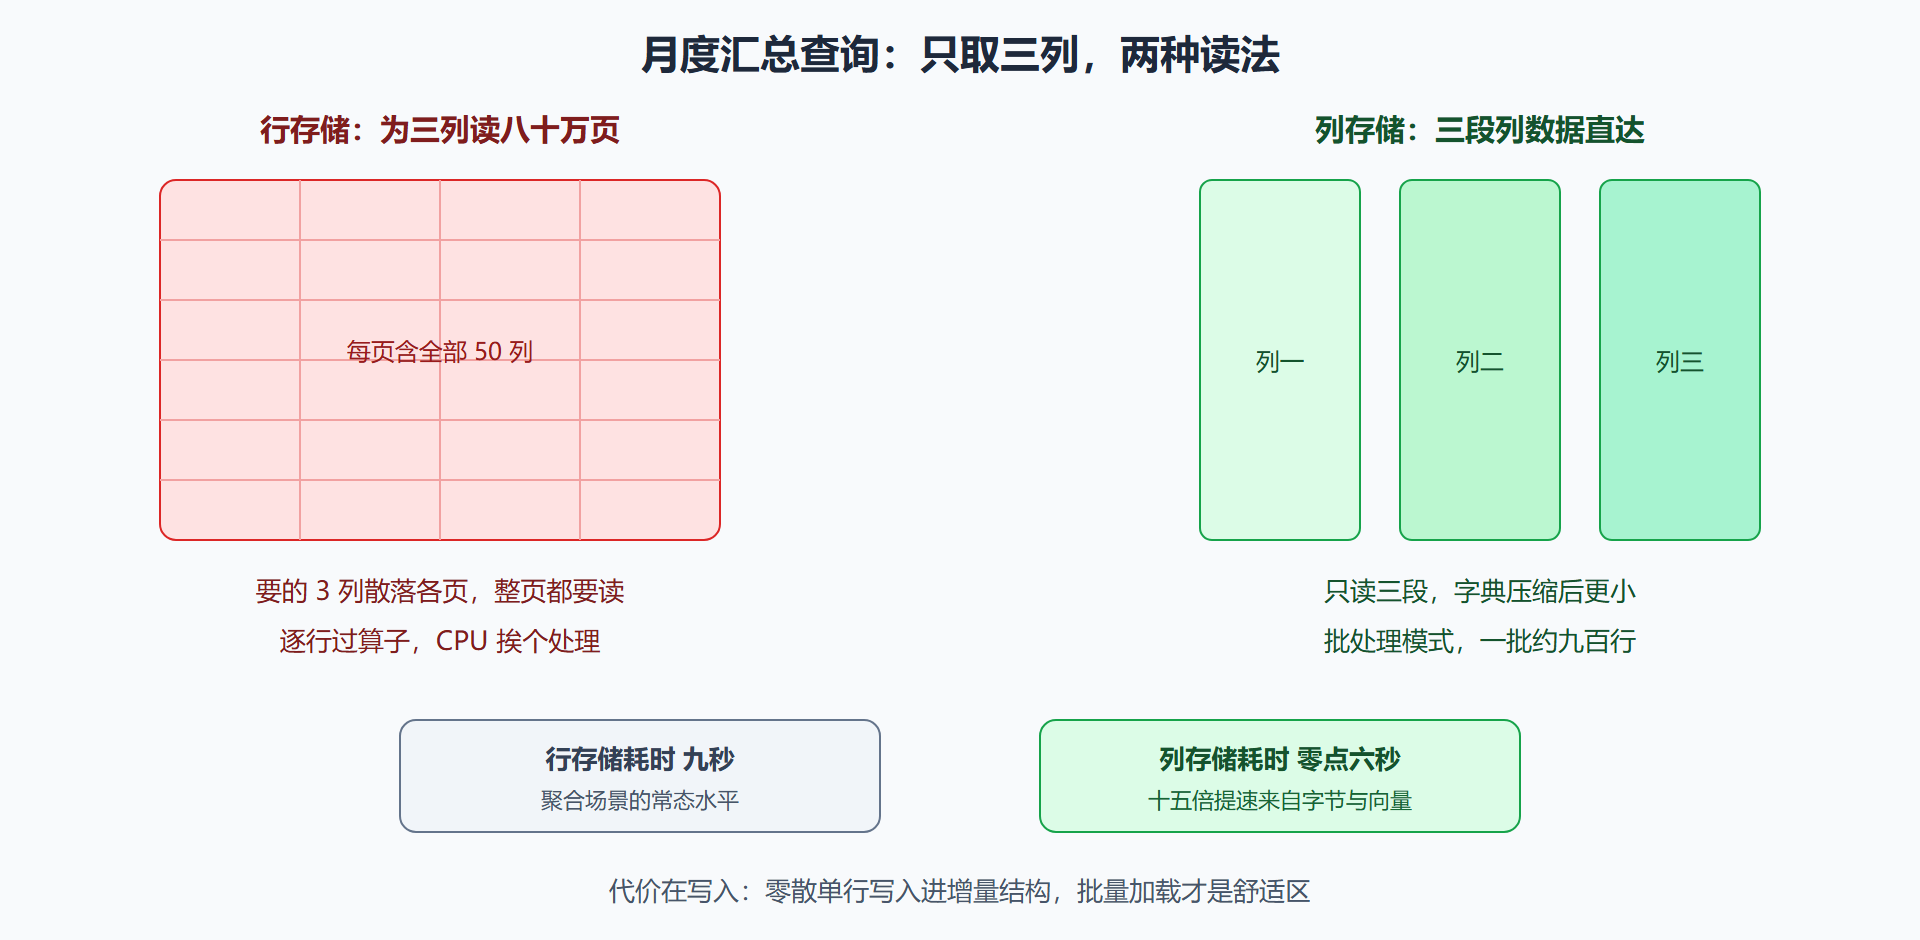
一笔销售流水有五十列,月度汇总只用到三列。行存储下,这三列的值散落在八十万页里,每一页都要整体读入缓冲池——读了一百倍于需要的字节。列存储把每一列连续存放:三列的汇总只读三段列数据,字节量骤降两个数量级。压缩是第二重红利:同一列里值重复度高(状态列、类别列),字典编码加位压缩后体积能缩到行存储的十分之一,I/O 进一步减少。第三重红利是批处理模式:行存储执行模式逐行过算子,列存储让算子按"一批约九百行"的向量处理,CPU 缓存友好、表达式求值开销摊薄。三重红利叠加,聚合报表提速十倍到百倍都属正常。
代价在更新侧。列存储按"行组"(约一百万行一组)组织,单行插入会先落到一个小的增量结构(deltastore),查询时再合并——零散写入多了,行组碎片化,压缩与扫描收益滑坡。批量加载(一次几万到百万行)则几乎完美。所以列存储的经典姿势是:加载走批量、查询走聚合、更新靠窗口整合(每日批量刷新而非逐笔直写)。
-- 聚集列存储:整表按列组织,纯分析表的形态 CREATE CLUSTERED COLUMNSTORE INDEX CCSI_销售事实 ON dbo.销售事实 WITH (DROP_EXISTING = OFF, MAXDOP = 4); -- 非聚集列存储:交易表上叠加只读分析通道(行存储主键组织不变) CREATE NONCLUSTERED COLUMNSTORE INDEX NCCI_订单分析 ON dbo.订单 (CustomerId, Amount, Status, CreatedAt);
混合负载的索引策略:一家不打架的方案
真正的生产问题不是"全切列存储",而是"白天交易、随时出报表"。混合策略有三层。第一层,交易表保留行存储主键组织,叠加非聚集列存储覆盖报表列——交易路径不受影响,报表查询自动走列存储通道。第二层,分析事实表直接聚集列存储,配合每日批量加载,夜间 ETL 与白天 BI 都在舒适区。第三层,列存储内再建行存储 B 树索引(2016 版后支持),让点查在事实表上也有精准通道。配套的维护动作是行组整理(REORGANIZE 命令合并碎片行组、剔除已删行),在维护窗口按月执行即可。这个组合让"库内 HTAP"从口号落成配置。
图 9-2 行存储与列存储:同一笔查询的两种命运
一次报表提速案的完整卷宗
背景:BI 平台的三张核心日报要在早晨六点前出完,数据量增长后拖到八点半,运营天天投诉。取证:三条查询全是多列聚合加分组,走行存储全扫,逻辑读千万级;表是两亿行的销售事实表,仅有一个主键索引。干预:事实表改聚集列存储(该表只被 ETL 批量刷新与 BI 读取,完全契合列存储舒适区),维度表的关联键保留行存储索引;维护作业加每月行组整理。结果:三张日报合计耗时从两小时十四分降到七分钟,库体积因压缩反而缩水六成,六点前出报从"赶"变成"稳"。解读:提速的本质不是"优化了查询"而是"换了存储范式"——同一查询在行存储形态下无论怎么加索引都到不了这个量级。变式:若该表还需要高频单笔更新(比如人工修数),方案要退一层——行存储主键组织加非聚集列存储,把列存储当只读分析通道;若分析负载真的巨大且允许延迟,下一站是把数据流式送往专用的分析平台,让交易库彻底减负——第 6 章上云路径与云端分析生态就是为此准备的。
行组健康度:列存储的体检表
列存储的性能衰减几乎都能从行组健康度读出。健康状态是"满员压缩行组"——每个行组装满约百万行、状态为压缩,扫描器按最大并行度满负荷吃行组。两种病变要盯:开放的增量行组(deltastore 里堆着小行组,零散写入的堆积物,查询要额外合并它们);已删除比例高的压缩行组(删除只打标记不回收,行组内的死行比例过半,扫描在为空气付费)。对应目录视图能按表列出全部行组的状态与行数分布。处方对应明确:增量堆积用重组命令把小行组压入压缩行组,死行过多用整理或重建回收,批量加载窗口调大最大并行度让行组尽量满员。把这张体检表并入第 8 章的月度维护作业,列存储的性能曲线就能长期走平——它不是"建完就完"的索引,而是一套需要按月喂养的存储形态。
补一个选型边界:列存储的批处理模式对部分运算符(某些旧式写法的游标表达式、特定函数)会退回逐行模式,聚合报表混入这些写法时提速会打折。验证方法还是执行计划——批处理模式会显式标注,发现退化就从写法侧改造,而不是怀疑列存储本身。
从交易库到集市:一份分层落地节奏
列存储落地不必一步到位,按三层节奏推进最稳。第一层,交易库内建非聚集列存储覆盖最痛的几张报表(两周内见效,风险最低);第二层,把重度分析表整体迁为聚集列存储、按批量加载重塑刷新链路(一到两个月,需要与 ETL 团队联调);第三层,数据量与并发再上台阶时,引入独立的分析库或云端分析平台,交易库只留非聚集列存储做轻量即席查询。每层都要用同一把尺子验收:目标报表的耗时、交易路径的回归耗时、存储占用变化。分层的好处是每一步都有退路——第一层不合适删索引即回,第三层才涉及架构,风险被切成了可控的小份。
本节要点回顾
- 三重红利:只读所需列、字典压缩、批处理向量执行,聚合提速一个数量级是常态;
- 代价在更新侧:零散写入进增量结构并造成行组碎片,批量加载是舒适区;
- 混合策略三层:交易表叠非聚集列存储、事实表聚集列存储、列存储内补 B 树点查通道;
- 行组整理按月做:合并碎片行组与清除已删行,维护收益不衰减;
- 换范式大于调查询:存储形态不对,加多少索引都到不了量级;
- 边界要认清:高频单笔更新与点查密集的表,列存储不是答案。
半结构化与关系网络的数据怎么进关系库?下一节把 JSON、图形对象与库内机器学习放进同一张工具桌。