3.1 指令集架构:芯片听得懂的语言
3.1 指令集架构:芯片听得懂的语言
本节摘要:指令集架构(ISA)是处理器能理解的全部指令的规范,是软件与硬件之间唯一的正式契约。本节给出 ISA 的精确定义与构成要素,对比 CISC 与 RISC 两大设计哲学,并解释 RISC-V 命名的含义与它作为开源指令集的特别之处。读完你能从"语言"的层面理解第 1 章那些架构名词,而不是把它们当作营销词汇。
直接定义:什么叫指令集架构
指令集架构是处理器对软件做出的承诺清单,白纸黑字规定三件事:有哪些指令(加、减、跳转、访存……)、指令的编码格式(哪个比特模式代表哪条指令)、程序员可见的寄存器与数据类型(有几个通用寄存器、多宽)。只要一颗 CPU 兑现这份契约,为它写的软件就能原样运行——这就是为什么 8051 内核换了十几家厂商、主频从 12MHz 到 40MHz,老程序照样能跑:ISA 不变,软件兼容。
要把 ISA 与"微架构"分开。ISA 是合同,微架构是兑现合同的具体施工方案:三级流水线还是五级、缓存多大、分支预测怎么设计,都是微架构的自由。同一份 ISA 可以有性能差异巨大的微架构实现,就像同一部法律下可以有不同的法院效率。工程师说"这颗芯片性能强",说的是微架构与频率;说"这软件能移植",看的是 ISA 是否一致。
一条指令的一生:从比特到动作
汇编语言是 ISA 的人类可读形式。看一条最简单的 Cortex-M 汇编:
ADDS R0, R0, R1 ; R0 = R0 + R1,并更新标志位
汇编器把它翻译成机器码——一个 16 位的比特模式(Thumb 指令集下形如 0001100000001000 之类的二进制串)。CPU 取回这串比特后,译码器按编码表拆解:前几位说"这是加法",中间几位说"第一个源寄存器是 R0",再几位说"第二个源是 R1、目标也是 R0",末位说"要更新标志位"。随后控制器驱动 ALU 完成加法,结果写回 R0,零标志与进位标志按结果落位。一条指令的一生:比特被取回、被拆解、变成电路动作——全程没有魔法,只有精确到比特的约定。
ISA 的指令按用途分四族:数据处理(算术、逻辑、移位)、访存(load 与 store,RISC 架构下数据进出寄存器必须走这两条指令)、控制流(跳转、条件分支、函数调用与返回)、特殊(中断返回、屏障、调试)。四族指令像四种词汇,C 编译器的一切输出都由它们组合而成。
CISC 与 RISC:两条哲学路线
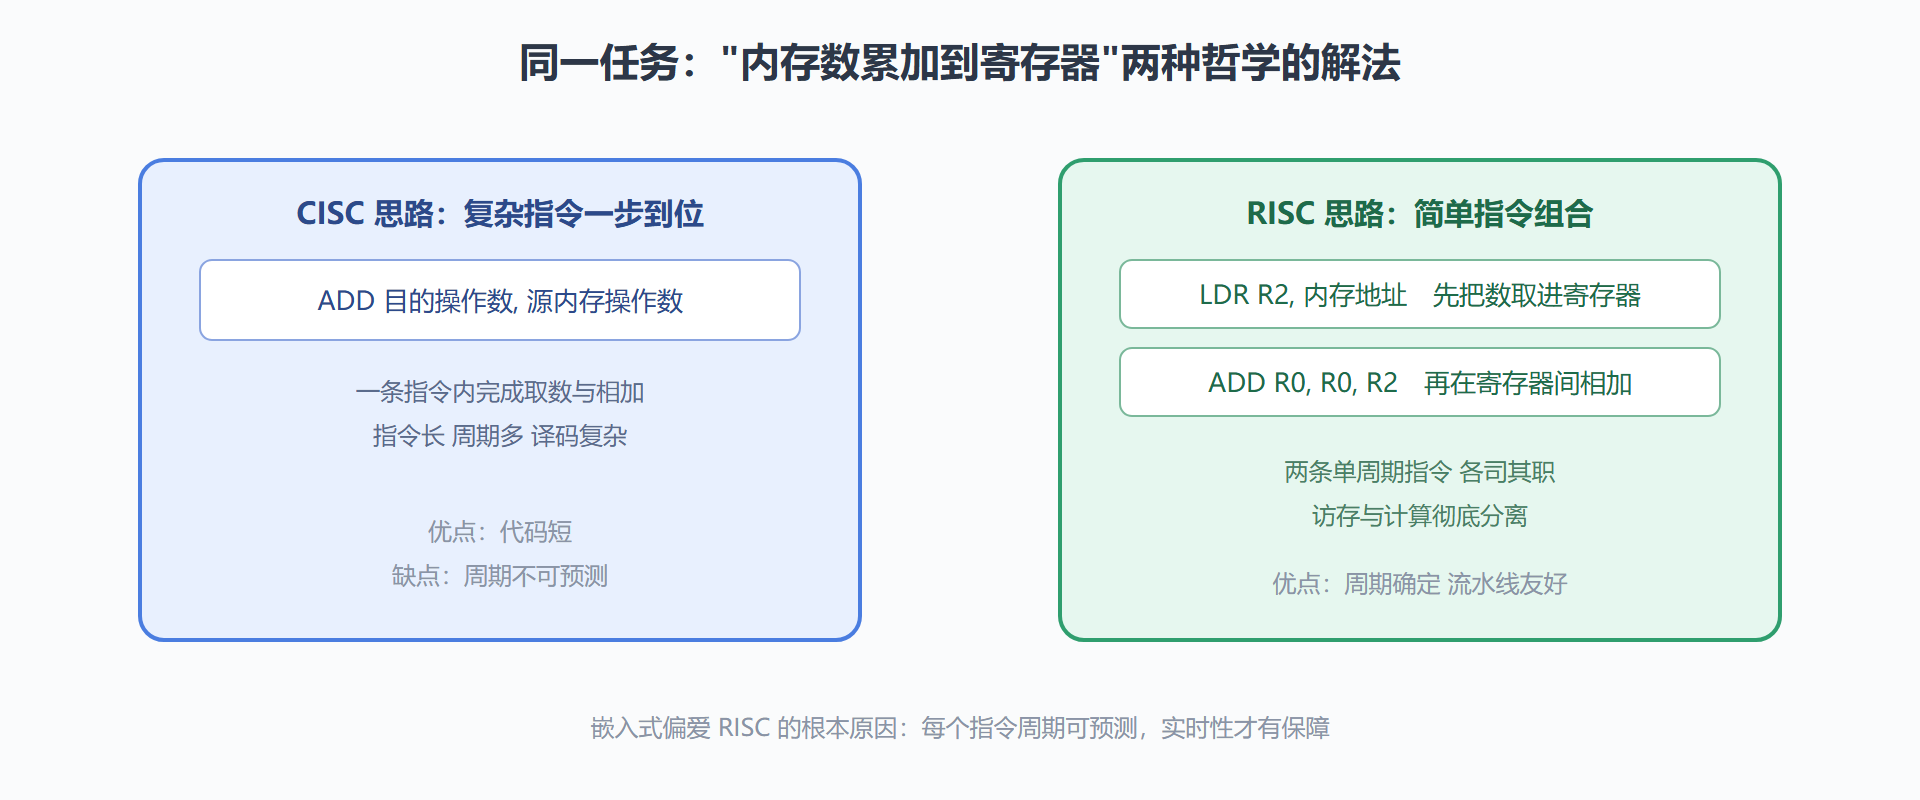
**CISC(复杂指令集)**的思路是"一条指令多干活":指令长短不一、功能丰富,一条串操作指令能顶一小段程序。代表是 x86 与 8051。优点是代码密度高、汇编好写;代价是译码电路复杂、执行周期不均匀,流水线设计困难。
**RISC(精简指令集)**的思路是"指令少而快":定长编码、大量通用寄存器、绝大多数指令单周期完成,复杂操作由编译器用简单指令组合。访存只有 load 与 store 两条路,其余计算全在寄存器间进行。代表是 ARM 与 MIPS。优点是译码简单、流水线友好、功耗效率高;代价是同样功能需要更多条指令,依赖编译器优化质量。
| 维度 | CISC | RISC |
|---|---|---|
| 指令长度 | 变长 | 定长 |
| 单条指令能力 | 强,可做多件事 | 弱,只做简单事 |
| 译码复杂度 | 高 | 低 |
| 流水线友好度 | 差 | 好 |
| 代码密度 | 高 | 略低(Thumb 类压缩指令弥补) |
| 代表 | x86、8051 | ARM、RISC-V、MIPS |
实践中的分界在模糊化:现代 x86 内部把复杂指令拆成微操作,外表 CISC、内核 RISC;ARM 的 Thumb-2 混编 16 与 32 位指令,兼顾密度与速度。哲学之争的遗产是设计意识的分化:嵌入式工程师关心的代码密度、周期确定性问题,正是两种哲学各自长处的来源。
图 3-1:CISC 与 RISC 完成同一任务的指令组织对比
RISC-V:名字里的信息与开源的分量
RISC-V 这个名字本身就是知识浓缩:RISC 是它的哲学出身(精简指令集),V 是罗马数字五——它是伯克利实验室的第五代 RISC 设计。它的特别之处不在技术而在分发方式:ISA 规范开源免费,任何人可以免费实现、免授权费商用。基础指令集保持极简(约 47 条基础指令),扩展能力像积木——需要浮点加 F 扩展、需要原子操作加 A 扩展、需要压缩指令加 C 扩展,厂商按产品需求裁剪拼装。这种"基本款加选装"的模式让 RISC-V 特别适合定制化场景,也解释了它在中国厂商中的快速铺开。
对学习者的现实建议:RISC-V 与 Cortex-M 在汇编层面高度同构(都是 load-store 架构、都是通用寄存器机器),学会一个,另一个一天即可上手。所以不必为"学哪个 ISA"焦虑——ISA 是语言,微架构是方言,工程思维才是正文。
汇编要不要学:一个务实回答
既然编译器代劳一切,汇编还有必要学吗?务实的答案是:要学,但学到"能读懂"即可,不必练到"能手写"。读汇编的三大场景贯穿职业全程:调试器单步时看懂执行流、性能分析时核对关键循环的指令构成、排查编译器优化导致的诡异行为(变量被优化掉、执行顺序被重排)。手写汇编的场景在今天只剩极窄的角落(启动文件、极致优化的数学内核),且那属于专门领域。学习路径建议:把本章与 3.2 节的最小汇编片段读懂,然后在调试器里对照自己的 C 代码看反汇编,一两个项目下来就能达到"流畅阅读"的水平——投入产出比极高的一项能力。
另外补一个阅读手册的坐标:芯片厂商的"汇编指令集手册"通常按指令字母序列条目,每条给出操作语义、影响哪些标志位、占用周期数。写不出某段 C 对应的汇编时,按"指令名查手册"即可,不必背——指令集手册是查的字典,不是背的课本。
从 ISA 视角回看选型
第 1.4 节的选型对比,现在可以从 ISA 层面补一笔:8051 的 CISC 遗产让它指令周期不均(乘除要多个周期),做精确时序要用硬件定时器补偿;Cortex-M 与 RISC-V 的单周期主流指令让"算一下耗时几个周期"变得可估计,实时分析有据可依。ISA 的哲学气质会一路渗透到应用层的时序设计——这是初学者很难从前置参数表里看出、却真实影响工程决策的暗线。
指令密度:Flash 预算的隐形变量
选型时还有个常被忽略的维度:同样的功能,不同指令集写出来的机器码长度不同,这叫代码密度。CISC 天然偏密(一条指令干多件事),RISC 用定长编码换取简洁,代码偏松——为弥补这一点,ARM 为 Cortex-M 设计了 Thumb-2 混合编码(16 位与 32 位指令混用),密度逼近老 CISC 内核;RISC-V 则用可选的压缩指令扩展(名字里带 C 的,如 RV32IMC)达到类似效果。密度为什么值得关心?因为 Flash 容量直接挂钩芯片单价:固件 30KB 与 60KB 在量产十万件时是两档成本。做协议栈、字体库、图形界面的项目,Flash 往往比主频更早成为瓶颈——编译输出的体积统计(size 一栏)应当成为每个嵌入式工程师的日常读物。
本节要点回顾
- ISA 是契约:规定指令、编码、寄存器三件事;ISA 不变则软件兼容,与微架构性能无关。
- 指令四族:数据处理、访存、控制流、特殊;编译器的一切输出由它们组合。
- 两种哲学:CISC 求单条指令强,RISC 求单条指令快而确定;现代设计互采所长。
- RISC-V 的分量在分发模式:规范开源、免授权费、可裁剪扩展,技术层面与 ARM 高度同构。
- 体系位置:语言定义好了,下一节看这门语言写成的程序如何在 CPU 里跑起来。