5.1 中断系统架构:硬件抢话筒的机制
5.1 中断系统架构:硬件抢话筒的机制
本节摘要:中断让 CPU 从"逐个询问外设"的苦役中解放出来:事件发生时硬件主动打断当前程序,处理完再无缝回来。本节讲清中断的完整硬件流程——挂起、裁决、压栈、跳转、返回——并量化中断延迟的构成。这是理解一切"及时性"问题的起点,也是第 5 章其余三节的地基。
一个反问开场:为什么不让 CPU 一直问
设想串口每来一个字节,CPU 都要主动查一次状态寄存器——这叫轮询。轮询的悖论在于节奏永远别扭:查得太勤,CPU 的时间全耗在"问了没有"上;查得太懒,字节到了没人取,被下一个字节覆盖,数据就丢了。轮询的本质缺陷是主动权错配:数据到达的时机由外部世界决定,而轮询让 CPU 被动追赶这个时机。中断把这个错配纠正过来——事件发生的那一刻,硬件主动打断 CPU,时机不再依赖 CPU 的勤奋程度。这就是为什么所有实时系统都以中断为骨干:及时性靠机制保证,不靠编程者的侥幸。
一次中断的完整旅程
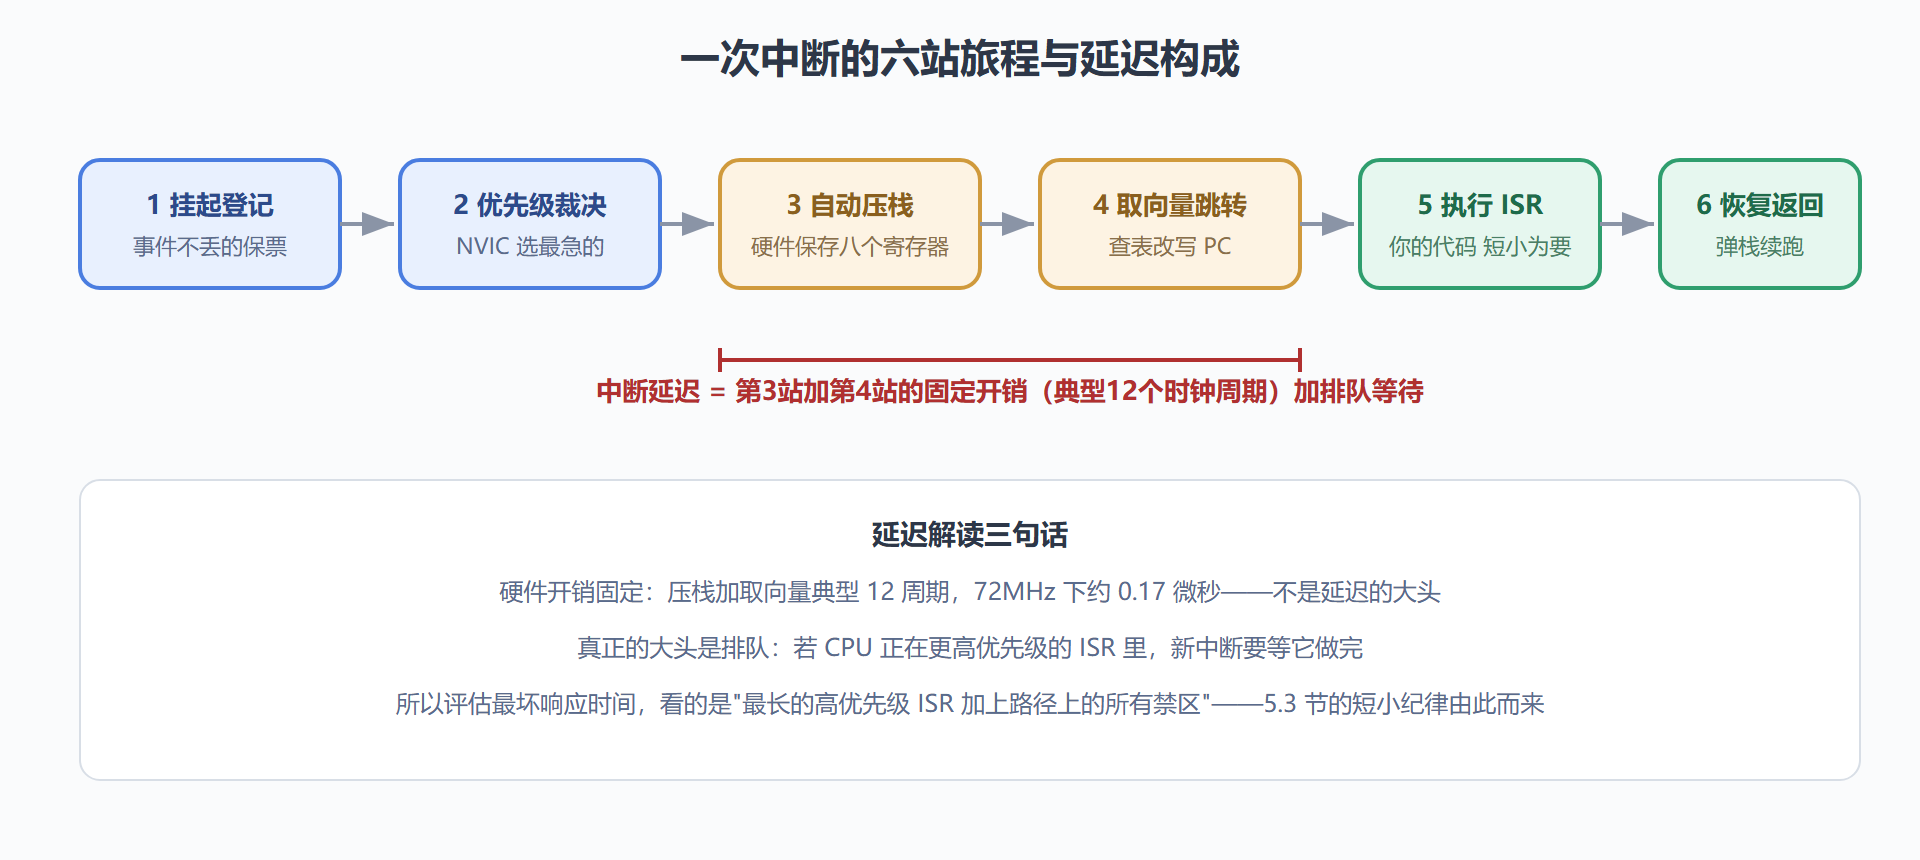
以 Cortex-M 为例,一个外部中断从发生到返回要经过六站,每一站都有明确的硬件职责:
第一站,挂起登记。 外设事件发生(比如定时器计数到顶),外设置起自己的中断标志;若该中断在 NVIC(嵌套向量中断控制器)里已使能,硬件在挂起寄存器里登记"有事待办"。挂起机制是个体贴的设计:CPU 短暂脱不开身时,事件不会丢——登记在册,腾出手来就处理。
第二站,优先级裁决。 若同时有多个挂起的中断,NVIC 按优先级选出最急的一个。若当前正在执行的中断优先级更高(或同级),新中断继续排队等待——裁决规则下一节细讲。
第三站,自动压栈。 CPU 把返回现场——PC、状态寄存器等八个核心寄存器——由硬件自动压入栈。这一步不花一条指令,纯硬件完成,是 Cortex-M 中断响应快的关键(早期架构需要软件自己保存现场,又慢又容易出错)。
第四站,取向量跳转。 CPU 从向量表中按中断号取出对应服务程序的地址,装入 PC——程序改道,开始执行 ISR。从事件发生到第一条 ISR 指令开始执行的总耗时,就是中断延迟。
第五站,执行服务程序。 你的代码登场:读数据、清标志、置通知。纪律要求短小(5.3 节展开)。
第六站,恢复返回。 ISR 执行中断返回指令,硬件自动把压栈的八个寄存器弹回,PC 回到断点,主程序从被打断的那条指令继续——仿佛什么都没发生过。
图 5-1:中断响应全流程与延迟构成
中断延迟:及时性的量化
延迟的构成值得单独算账。硬件固定开销部分(压栈加取向量)在 Cortex-M3 上典型为 12 个周期,72MHz 下不足 0.2 微秒——硬件不是延迟的罪魁。真正的不确定性来自排队:如果 CPU 正在执行一个更高级的中断,新事件的响应要等它结束。于是最坏响应时间的公式浮出水面:最坏延迟 = 路径上所有更高优先级 ISR 的最长执行时间之和 + 固定开销。这个公式是 5.3 节"ISR 必须短小"纪律的数学根源:你的 ISR 每多执行一微秒,所有低优先级中断的最坏响应时间就多一微秒。
另一个量化指标是咬尾中断(tail-chaining):连续发生的中断之间,硬件省去重复的压栈解栈,直接从一个 ISR 切到下一个,仅 6 个周期。这一机制让"中断风暴"下的系统也保持高效——高速数据流的连续中断(如每微秒一个字节的 DMA 传输完成中断)正是靠它撑住。
挂起与丢失:第一站的两种结局
挂起机制能兜住"CPU 暂时忙",但兜不住所有情况。两种典型丢失场景要刻进脑子:其一,同源事件连发——同一个中断源两次触发之间 CPU 没来得及处理,挂起寄存器只有一个位,第二次触发只是让位保持为 1,两次事件合并成一次。串口两字节连发、只有单字节缓冲又没及时取,第二字节就是硬丢失(硬件覆盖)。其二,事件在关中断窗口到达——软件主动关闭中断的临界区里,挂起可以登记,但响应要等开中断之后,窗口太长同样造成"事实上的迟到或丢失"。
所以工程上有句行话:中断不丢数据的条件是"处理速率大于等于事件到达速率",且关键区要短。速率兜不住的部分要靠硬件缓冲(UART 的 FIFO、DMA 搬运)——这正是第 6 章工具链里 DMA 的价值所在。
使能三要素:把中断打开的完整开关链
新手配置中断最常见的困惑是"为什么死活不进中断"。因为一个中断要生效,必须三处开关同时打开:外设侧,事件源使能(如定时器的更新中断允许位);NVIC 侧,对应通道使能并设好优先级;全局侧,CPU 的总中断开关(PRIMASK)处于开态。三链缺一,事件就在某一站默默停下。排查口诀:从源头到 CPU 逐站检查"标志位有没有置起来、挂起位有没有登记、使能位是不是都开了"——用调试器看寄存器,两分钟就能定位卡在哪一站。
向量表:中断系统的名册,以及它为什么能搬家
向量表值得单独认识,因为它是"事件到代码"的总接线板。向量表是一张按中断编号排列的地址表:第 0 号位置放着栈顶初值,第 1 号是复位入口,之后依次是各种异常与外设中断的服务程序地址。硬件响应中断时做的事,本质就是"查表跳转"。两个实用推论。其一,向量表可以搬迁:Cortex-M 提供向量表偏移寄存器(VTOR),把表搬到 RAM 里就能在运行时改写表项——固件升级(bootloader 与应用程序两套固件共存)靠的就是这招,bootloader 把向量表指给自己的表,启动应用前再指向应用的表。其二,默认表在 Flash 里,改写不了表项但可以在表项处放跳转指令,这是老式内核的变通。理解了向量表,第 3.3 节启动文件里"向量表就住在启动文件里"那句话就有了完整着落。
问题:定时器中断、外部中断、DMA 中断有什么本质区别?
触发源不同,使用姿势随之不同。定时器中断由芯片内部节拍触发,时间完全可控,是系统时基与准点任务的心脏;外部中断由引脚电平边沿触发,响应的是外部世界的异步事件,按键、报警线都走这条路,它还分上升沿、下降沿、双边沿三种敏感方式;DMA 中断由"搬运完成"事件触发,本身不代表外部事件,而是"批量数据到货"的内部通知,大数据量场景下用它把 CPU 从逐字节搬运中解放出来。三者共用同一套 NVIC 裁决与 ISR 纪律——机制一层,触发源千变,这正是中断架构的可扩展之处。
问题:中断嵌套和函数调用都是"栈上叠现场",会不会叠爆?
会,这正是嵌套深度必须受控的物理原因。每一层中断的硬件压栈加软件现场都占栈,嵌套三层就意味着三份现场同时住在栈上,再叠加各层 ISR 自己的局部变量。栈的容量在设计时就定了(链接脚本分配),溢出的表现是踩坏相邻内存——症状往往是"偶发的变量错值",与 5.4 节案例二同源但更难查。所以嵌套不是"支持就可以随便用"的特性:控制嵌套深度(优先级档位收敛)、给每层 ISR 定栈预算、用栈水位检测(填充法)做运行时监控,是三件配套的事。第 7 章的可靠性设计会把栈水位巡检列为标准自检项。
本节要点回顾
- 中断纠正主动权错配:及时性靠机制保证,轮询靠不住,中断是实时系统的骨干。
- 六站旅程:挂起、裁决、压栈、跳转、执行、返回;压栈由硬件自动完成是快速响应的关键。
- 延迟公式:最坏延迟 = 更高优先级 ISR 最长执行时间之和 + 固定开销;ISR 长一微秒,全系统响应慢一微秒。
- 挂起不等于永不丢:同源连发合并、关中断窗口迟到,是两种典型丢失,靠速率与缓冲兜底。
- 使能三要素:外设、NVIC、全局三处开关全开才生效,排查时逐站点名。
- 体系位置:单一中断的旅程讲完了,下一节处理多个中断共存的秩序问题——优先级与嵌套。