第 2 章 · 敌手画像与安全模型
第 2 章 · 敌手画像与安全模型
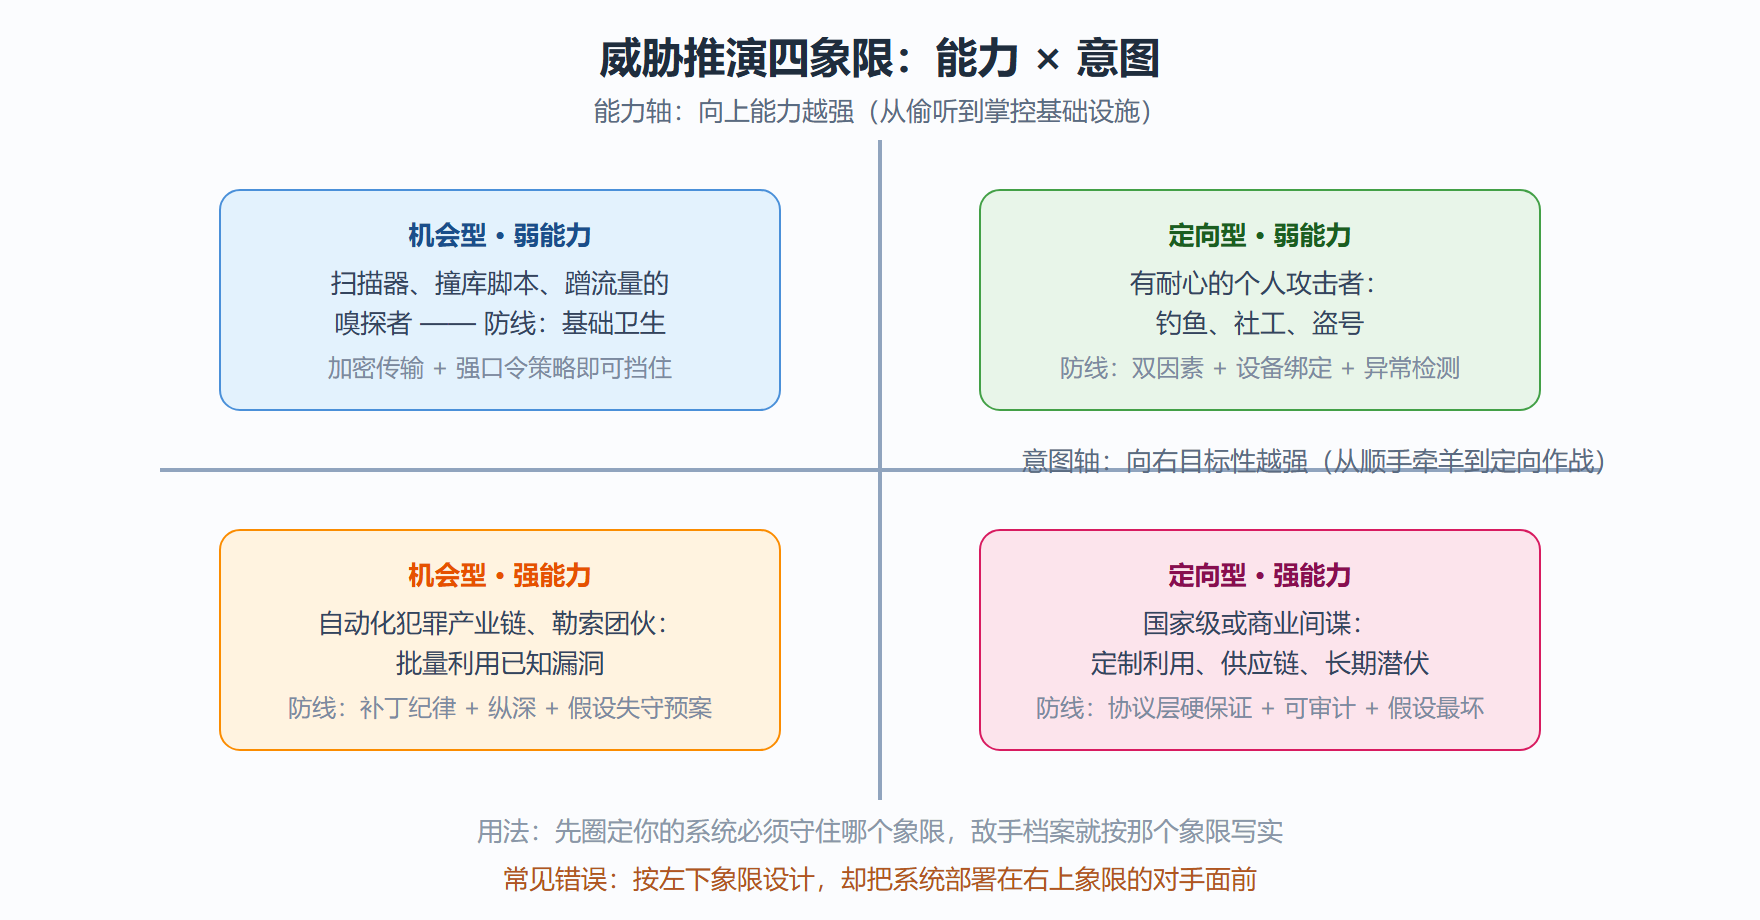
章节摘要:推演室的第一条纪律是先立敌手再谈胜负。本章回答三个问题:学术界用哪两个模型刻画敌手——符号世界的 Dolev-Yao 与计算世界的概率多项式时间敌手,各自把敌手"具体化"到什么程度;拿到一个真实系统怎么把威胁落成清单——本章给一张可操作的四象限推演清单;安全目标怎么从"我们很安全"写成"敌手在某某能力下无法让某某命题成立"的可证明命题。读完你能为任何系统立起一份自洽的敌手档案,并给安全目标配上可检验的表述。
学习目标
读完本章,你应当能够:
- 复述 Dolev-Yao 模型给敌手的四项网络能力与两项限制,并解释"密码学运算被视为黑盒"这条简化为什么既是威力也是风险;
- 说清计算模型与符号模型的分工:什么时候该用哪个,两者的结论能否互相替代;
- 拿到任意系统,按"资产、入口、能力、影响"四步产出一份威胁推演清单,并能指出清单里最容易被高估与被低估的条目;
- 把一句模糊的安全声明(如"聊天记录是安全的")改写成"对何种敌手、在何种假设下、哪个命题不可证伪"的形式化表述;
- 判断一个项目文档里的安全声明缺了哪个要素——敌手、假设还是命题——并给出补全建议。
核心概念速览
本章浓缩成一句话:**安全模型的本质是一份精确的"让步条款"——我们向敌手让渡哪些能力、保留哪些假设,然后在这个沙盘里证明协议仍然守住目标。**让步越多、证明仍成立,结论越可信;模型含糊,等于把谈判桌掀了。
子章节导航
- 2.1 Dolev-Yao 全能敌手:1983 年给出的符号模型至今仍是协议分析的第一语言。本节把敌手的四项能力(截获、篡改、注入、重放)逐条写实,讲清"敌手就是网络本身"这个设定的推演威力,也讲清它对实现层漏洞的天生盲区。
- 2.2 威胁建模推演清单:把学术模型翻译成工程动作。四步清单——列资产、找入口、定能力、估影响——配一个即时通信系统的完整示范,包括哪些条目常被高估(内部网络隔离)、哪些常被低估(备份与日志通道)。
- 2.3 把安全目标写成可证明的命题:安全目标的形态学。同一句"聊天安全",可以写成机密性命题、认证命题或前向保密命题,三者的敌手前提各不相同。本节给出命题改写的三要素模板,为第 5 章的机器验证准备素材。
子章节之间的逻辑关系
三节是"模型 → 方法 → 语言"的递进:2.1 给出理论上的敌手画像,2.2 把画像落到具体系统的推演方法上,2.3 把推演的结论升格为形式语言。倒过来读不通:没有敌手画像,清单里的"能力"一栏只能拍脑袋;没有命题语言,清单的结论只能是感想而非可验证的判断。
敌手画像(2.1) ──提供能力坐标系──> 推演清单(2.2) ──升格为──> 安全命题(2.3) │ │ │ 理论沙盘的边界 工程落地的动作 可证明/可验证的语言
图 2-1 威胁推演四象限:把"谁会来攻击"摊开到桌面
常见误设的安全模型与修正
立敌手这一步有一批高频错误,进入三节之前先摆上桌。每种误设的共同点是:模型没有错到一眼假,但它悄悄替敌手减了负,后续一切"评审通过"都建立在沙盘放水上。
| 常见误设 | 悄悄让步了什么 | 现实里的报账方式 |
|---|---|---|
| "内网是可信的" | 删掉了横向移动能力 | 一台失守的内网机器横扫全网 |
| "第三方永远在线且诚实" | 信任假设没有失效分支 | 第三方被接管,全体用户陪葬 |
| "随机数由系统保证" | 随机性假设藏进实现层 | 弱随机导致密钥可预测 |
| "用户不会被骗" | 把钓鱼排除在模型外 | 找回流程成为首选突破口 |
| "攻击者算力有限" | 偷换"有限"的参照系 | 云算力让离线爆破变成在线成本 |
对照本章三节:2.1 教你把能力写实(误设多数死于能力栏含糊),2.2 教你把入口列全(误设常是入口漏列的另一种说法),2.3 教你把假设写进命题(写进命题的假设才会被复审)。建模时拿这张表自查,比事后争论"当初怎么想的"便宜得多。
前置知识与后续延伸
前置是第 1 章的四要素拆解法——本章所有动作都是在给"信任假设"一栏做体检。往后看:2.3 节的命题模板在第 3 章用来给名案"验尸"(每个案例都是某个命题被证伪),在第 5 章直接翻译成 BAN 逻辑的推理规则与 ProVerif 的查询语句;2.2 节的清单方法论在 6.3 节部署守则里会退化成一份检查表。敌手画像这一课没有捷径,唯一的练习方式是给身边的系统反复立档。