5.2 ProVerif 建模推演实录
5.2 ProVerif 建模推演实录
本节摘要:ProVerif 是当代符号验证的主力工具:协议写成进程与事件,安全目标写成查询,验证器在无界会话数的前提下搜索反例。本节走完建模四件套——角色进程、公开通道、事件、查询——给出一个可照抄结构的简化认证交换模型,并演示同一个模型如何自动复现 3.1 节的会话拼接攻击。读完你能独立完成中小协议的首次建模,并牢记"模型错了工具不负责"这条铁律。
建模前的心理建设:工具只对模型负责
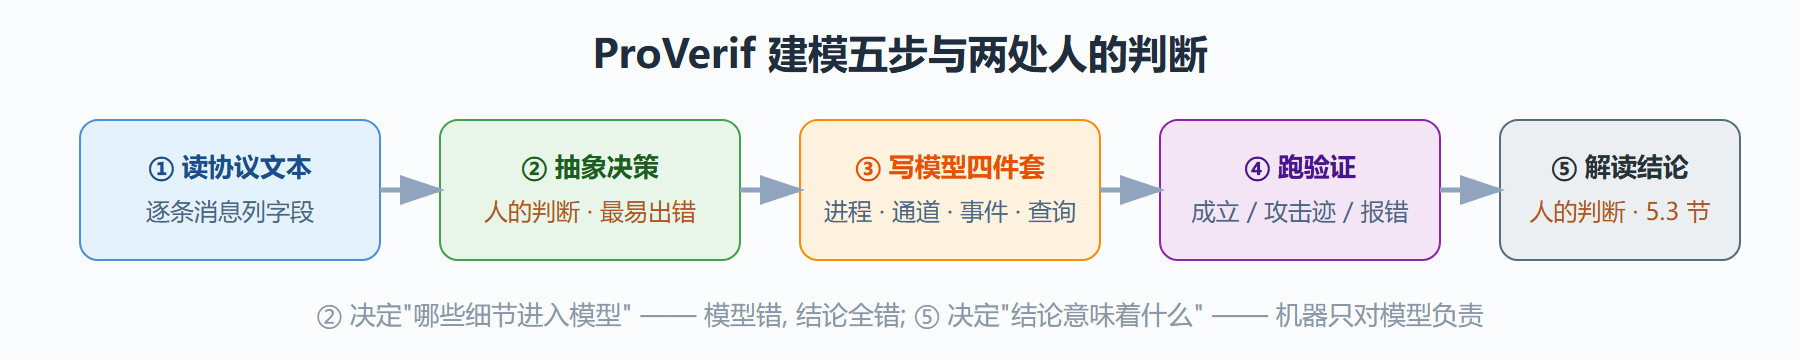
先把期望摆正。ProVerif 不读协议 RFC,不看不看实现代码——它只看你写的模型。你把"消息里包含什么字段"写成模型里的构造,它就忠实检查"在无界多个并行会话、敌手可任意拼接的符号世界里,你的查询是否可被违反"。由此推出两条使用纪律。其一,模型与协议文本的每一次出入都是潜在盲区:省略了一个身份字段,验证器就会对一个不存在的更弱协议给出结论——建模者漏掉的东西,工具不会替你补。其二,"验证通过"永远要带着模型声明一起发布:覆盖了什么敌手能力、抽象掉了哪些密码学细节、有没有界假设,三者写清楚,结论才可被他人复用。
建模四件套的分工如下。公开通道:一条所有消息都经过敌手的信道——这是 2.1 节"敌手即网络"的直接翻译。角色进程:每个角色一段代码,描述它收到什么、检查什么、发出什么。事件:在进程的关键节点埋下标记(比如"B 接受了会话密钥且认为是与 A"),供查询引用——事件是模型里的"行车记录仪"。查询:把 2.3 节的安全命题写成事件之间的逻辑关系,比如"若 B 接受了与 A 的会话,则 A 必然真的发起过这次会话"。
一个可照抄的简化模型
下面的模型把一个 NS 风格的公钥认证交换抽象到只剩协议逻辑:加密是符号化的(拆包即得内容),签名同理。所有算法细节被刻意抽象——符号模型不管算力,只管消息的拼接结构。
(* 符号化原语: 公钥加密与对应私钥 *) type pubkey. type privkey. fun pk(privkey) : pubkey. fun aenc(bitstring, pubkey) : bitstring. reduc forall x: bitstring, k: privkey; adec(aenc(x, pk(k)), k) = x. (* 事件: 行车记录仪, 埋在角色的关键决策点 *) event aBegins(pubkey). (* A 开始与对方会话 *) event bAccepts(key: bitstring, p: pubkey). (* B 接受会话, 认为对象是 p *) event aAccepts(key: bitstring, p: pubkey). (* A 接受会话, 认为对象是 p *) (* 查询: B 接受的会话, 对象必须真的发起过 —— 对应性命题 *) query k: bitstring, p: pubkey; event(bAccepts(k, p)) ==> event(aBegins(p)). (* 敌手初始掌握的材料: 自己的密钥对 *) free s: bitstring [private].
进程部分,角色 A 的骨架是:生成临时值,发出首消息,等待回执,标记事件;角色 B 的骨架是:收到首消息,解出对方身份与临时值,回第二条,等待第三条回执,标记接受事件。三条消息的收发各是一行构造与一行拆解,模型总长度通常不超过六十行——符号建模的成本主要不在代码量,而在"决定哪些细节进入模型"的判断。建模完成跑验证,三种可能的结果各代表不同的下一步:命题成立,说明模型内无反例;命题被违反,输出一条攻击迹(5.3 节专讲怎么读);工具报错或超时,多半是模型里类型不匹配或规则写岔了,修模型而非换工具。
用机器复现 3.1 节的著名漏洞
把 3.1 节的 NS 公钥三步协议按原样建模(保留它当年的原始消息结构:A 的身份只出现在首消息的密文里,后续消息不含对话对象标识),查询写成"若 B 接受与 A 的会话,则 A 必然开始过与 B 的会话"。验证器数秒内返回违反,并给出这样一条攻击迹:敌手先与 A 完成一次正常会话拿到临时值,然后冒充 A 向 B 发起会话,把 B 的回执原样转给 A,再转回 A 的应答——攻击迹的每一步都对应 3.1 节手推的每一步,机器用不到一分钟走完了研究者用人工走的路。
这个复现的价值是双向的。对工具:它证明了符号验证的实战能力——1996 年论文里人工构造的攻击,在 2000 年代的工具里成为自动输出。对建模者:它演示了模型忠实度的意义——若建模时"好心"地给后续消息补上身份字段(按修复后的协议),同一查询立即通过;模型忠实地保留了原始缺陷,工具就忠实地找到了它。工具不会告诉你"你的协议有问题",只会告诉你"你的模型与你的查询矛盾"——判断矛盾意味着什么,永远是人的工作。
图 5-2 建模流程五步:从协议文本到可发布的结论
抽象让步清单:建模时你到底省掉了什么
"模型错了工具不负责"听多了会抽象,把它落成一张清单。每次建模收工,照着下面四行自查一遍,并写进结论附注——这套动作五分钟,换来的是结论可以被同行复核。
| 抽象决定 | 省掉了什么 | 可能的后果方向 |
|---|---|---|
| 加密只建模为可拆包的黑盒 | 填充、报错差异、时序 | 实现层侧信道攻击不可见 |
| 随机数建模为理想新鲜名 | 随机数质量与熵来源 | 弱随机导致密钥可预测的整类事故不可见 |
| 通道建模为无丢失的敌手信道 | 物理丢包与乱序细节 | 通常保守(模型更强),结论仍有效 |
| 会话数建模为无界 | 资源限制下的行为 | 一般保守;个别依赖计数上限的协议需补界检查 |
| 密钥长度与算法参数不建模 | 参数裁剪与降级路径 | 6.3 节的降级操纵类问题需另行检查 |
清单里多数让步是保守的——模型里的敌手比现实更强,结论因此偏向安全;但有两行是乐观的:黑盒抽象把侧信道豁免了,新鲜名假设把随机数实现豁免了。这两处正是 3.3 节"实现层"事故的入口。所以模型声明里必须写明"本验证不覆盖实现层",这不是免责套话,是给后来者标出审计资源该去的楼层。
工具选择的边界感
ProVerif 之外值得知道两个名字与各自的位置。Tamarin 以支持有状态的协议见长——棘轮这类"密钥链随消息推进"的结构(4.2 节)在无状态近似下会丢掉关键性质,需要带状态的建模能力;它曾被用于对大型消息协议做完整的机器验证,代价是模型更重、跑得更慢。Scyther 以易上手见长,声明式语言简洁,适合教学与首轮筛查。选工具的判据不在"哪个更强"而在三问:协议有没有状态、会不会出现无界并行、结论要不要可复现的证明对象。三问答完,工具基本自选。而无论哪个工具,5.1 节的教训都原样适用:它们验证的都是模型,模型的理想化责任在人。
本节要点回顾
- 工具只对模型负责:模型漏掉的细节工具不会补,"验证通过"必须连同模型声明一起发布。
- 建模四件套:公开通道翻译"敌手即网络"、进程翻译消息序列、事件是行车记录仪、查询是安全命题。
- 抽象决策是最大出错点:进入模型的每个细节、抽象掉的每个细节,都是一次需要记录的人为判断。
- 机器一分钟走完人工十七年:NS 漏洞被自动复现,攻击迹每一步对应人工推演的每一步。
- 选工具按三问:有无状态、有无无界并行、要不要可复现证明对象——而非"哪个名气大"。
下一节处理验证输出的最后一公里:拿到一条攻击迹,怎么区分真缺陷与模型失误的假阳性,以及修补之后如何回归验证——机器找反例,人负责把反例变成工程决定。