1.3 微机系统关键性能指标
1.3 微机系统关键性能指标
本节摘要:性能不是单个数字而是一张多维账本——主频、CPI、MIPS、带宽、延迟各有适用范围;本节教你看懂账本、识破宣传话术,并用一次真实的选型测量演示正确归因的方法。
演化史看到最后,回到最实际的的问题:面对两套方案,怎么判断谁更快。本节是第 1 章的收尾,也是后续所有性能讨论的工具箱——第 3 章谈 Cache 命中率、第 4 章谈总线带宽,都要用到这里的度量框架。
主频数字的陷阱
把主频当性能是初学者最顽固的习惯。主频只回答"每秒有多少个时钟节拍",不回答"每个节拍干了多少活"。两台机器,A 机每节拍平均执行 0.5 条指令,B 机每节拍平均执行 2 条,同样频率下 B 机快四倍。把"每条指令平均消耗的时钟数"记作 CPI,性能的基本公式就是:
程序执行时间 = 指令条数 × CPI × 时钟周期 = 指令条数 × CPI ÷ 主频
三个因子互相牵制。指令条数取决于算法与编译器;CPI 取决于指令混合与微体系(流水线是否打满、访存是否命中);主频取决于工艺与功耗。优化任何一个都可能恶化另一个——为减少指令条数改用复杂寻址,CPI 往往上升;为拉高主频加深流水线,分支预测失败的代价也水涨船高。性能优化的本质是在三因子之间做交换,而不是单项最大化。
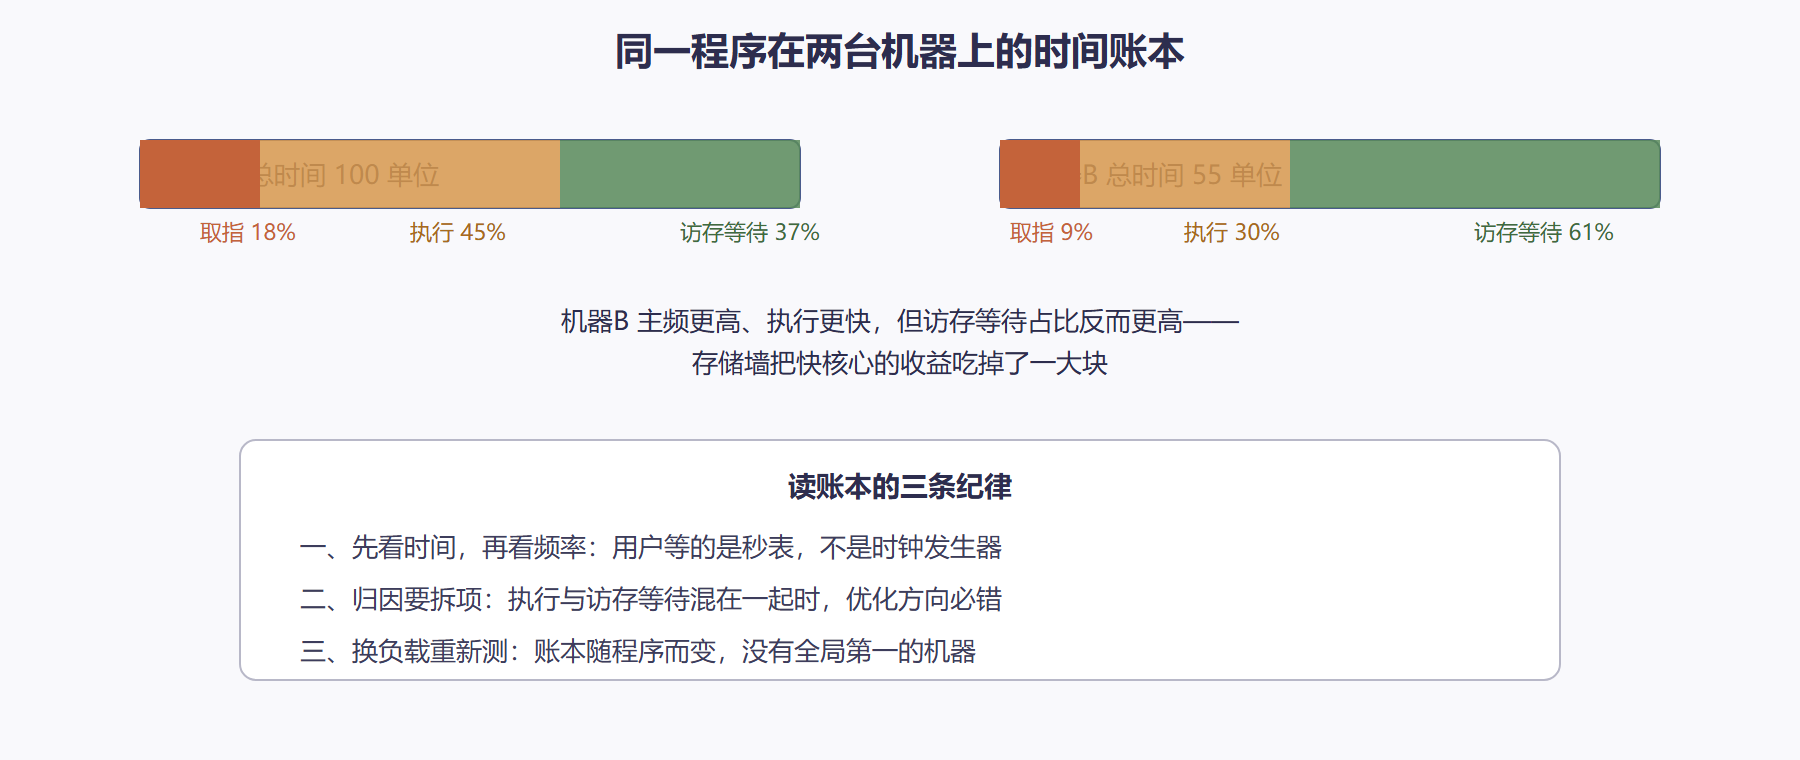
图 1-2:性能账本的多维透视图
指标家族与各自的脾气
| 指标 | 定义 | 擅长回答 | 容易骗人之处 |
|---|---|---|---|
| 主频 | 每秒时钟数 | 工艺与功耗水平 | 忽略每拍工作量差异 |
| CPI | 每指令平均时钟数 | 微体系效率 | 随指令混合剧烈波动 |
| MIPS | 每秒百万条指令 | 同构机器横向比较 | 不同指令不等价,可被"简单指令"灌水 |
| 峰值带宽 | 总线理论最大流量 | 互连上限 | 峰值永不可达,实际看效率百分比 |
| 延迟 | 单次访问耗时 | 实时与响应场景 | 平均延迟掩盖长尾,长尾决定实时性 |
| 基准测试 | 标准负载实测时间 | 端到端答案 | 负载不匹配则结论不可迁移 |
两处细节值得展开。其一,MIPS 之间的跨架构比较基本没有意义:一条复杂指令可能顶别人五条简单指令,MIPS 高只说明"指令条数多"。其二,延迟与带宽不能互相推算——总线带宽再高,第一次访问的延迟一分不会少;实时系统关心的是最坏延迟,不是平均吞吐。
一次完整的选型测量
背景:某数据采集项目要在两块候选板卡里选一块,厂商资料写着"主频提升显著"。操作:我们不比主频,先在同一负载下测端到端时间,再拆项归因。负载设计成两段:纯计算段(大数组定点滤波)与 I/O 密集段(中断驱动的串口收发)。结果:纯计算段 B 板比 A 板快约三成,与主频差距相当;I/O 密集段两板几乎打平,示波器还显示 B 板的中断响应抖动更大。解读:计算段受益于主频;I/O 段的瓶颈在中断路径与总线仲裁,主频帮不上忙,而 B 板为拉频率采用的深度流水让中断现场的保存恢复更拖沓。最终选了 A 板——这个项目的命脉是响应确定性,不是算力。变式:若负载换成批量搬运(如图像帧经 DMA 上传),结论会再次翻转,因为那时带宽成了主项。同一份账本,换一种负载就要重记一遍。
性能测量的第一戒律:先定义负载,再看数字。脱离负载谈性能,与脱离剂量谈药效是同一种错误。
把指标接回本课程
本节公式的三个因子,恰好对应后续三章的主战场:CPI 里的访存等待由存储层次决定(第 3 章),总线效率由仲裁与同步方式决定(第 4 章),中断与 DMA 的路径长短由接口设计决定(第 5、6 章)。读到这里,第 1 章的地基使命完成:你已经有了分层地图、演化视野和度量标尺。
一道手算题:把公式用起来
设一段程序包含四类指令,各类条数与 CPI 如下:算术类四万条、每条一拍;访存类三万条、每条三拍;跳转类两万条、每条两拍;特殊操作一万条、每条五拍。总时钟数=四万乘一加三万乘三加两万乘二加一万乘五,合计二十九万拍;总条数十万条,平均 CPI 为二点九。若主频两百兆赫兹,执行时间约一点四五毫秒。
现在做两次思想实验。第一次:换主频翻倍的新板,执行时间减半——其他因子不动,公式直接兑现。第二次:优化代码让访存类指令减少一半(两万条改由寄存器完成),重算总时钟数=四万加两万乘三加两万乘二加一万乘五,合计二十三万拍,平均 CPI 降至二点三,同频下提速约两成。两次实验的对比揭示了本节的核心:主频是花钱能买的,CPI 是动脑能省的,而指令条数是算法层的红利——三个旋钮捏在不同人手里。
第三本账:确定性
除时间与频率之外,还有一本常被忽略的账:确定性。同样的平均耗时,波动范围不同就是两种机器——一毫秒上下浮动百分之十的系统与偶尔飙到五十毫秒的系统,对交互场景是同一台,对实时控制是完全不同的两台。把确定性的来源拆开看:中断路径的抖动、总线被偶发占用、缓存的命中波动、后台任务的干扰,每一项都会写进延迟的长尾。所以成熟的选型报告总有第三张表:不同负载下的延迟分布,特别是最坏情况。本册第 5 章按最坏情况设计中断、第 6 章按最坏情况算总线占用,方法论都发源于这本账。
指标之间还会互相"劫持",给一个真实感的例子:把主频提高一成,执行段等比受益;但主频提高往往伴随总线同步调整,若访存等待的拍数跟着加一拍,访存密集程序的总时间可能不降反升。所以性能工程的第一课是控制变量——一次只动一个旋钮,其余锁死,测完再动下一个。看似笨办法,却是唯一能把因果讲清楚的办法,也是本节公式真正的用法。
高频追问三则
问:厂商为什么爱标峰值带宽与峰值算力? 因为峰值是物理上限,是确定的数字;有效值取决于负载,没法印在包装上。读宣传页的本能反应应该是"这数字的百分之几我能拿到"——总线上有仲裁开销,存储器有刷新与冲突,流水线有相关与停顿,实际效率能到五成就已属优秀设计。
问:自己设计基准负载要注意什么? 三条纪律:负载要贴近真实业务的比例结构,而不是跑分软件的合成分;要固定环境变量——同样的编译选项、同样的后台负载、同样的温度;要多次取中位数并记录波动幅度,波动大说明系统里藏着未受控的干扰源。
问:实时系统的性能怎么定义? 不看平均,看最坏。平均响应一毫秒、偶尔卡一百毫秒的系统,对工控与汽车电子是废品——它们要的是"最坏情况有上界且上界够小"。所以第 5 章的中断延迟、第 6 章的总线占用,都会按最坏情况来计算,这是实时工程与桌面工程的根本分野。
下一章进入处理器内部,去看时钟节拍里到底装了什么。