3.2 高速缓存Cache体系
3.2 高速缓存 Cache 体系
本节摘要:Cache 靠局部性原理把热数据圈在离核心最近的圈子里;映射方式、写策略、替换算法三套机关决定了命中率——它们不是玄学,而是可以手工推演的确定性规则。
上一站承认了"没有又快又大的材料",本站给出工程界的答案:用少量 SRAM 承接绝大多数访问。这一站是本章主线的正面战场,也是后续性能优化的理论底盘。
为什么需要 Cache
1.3 节的账本已经提示:访存等待是最大支出。处理器核心每拍能干很多活,主存却要几十纳秒才肯交货——落差接近两个数量级。Cache 的逻辑朴素得可爱:既然程序倾向于反复使用最近用过的数据(时间局部性)、以及使用它旁边的地址(空间局部性),那就把这样的数据圈进一小片 SRAM 里,多数访问在圈内解决,少数访问才下潜到主存。
工作流程三步走。CPU 发出地址后,Cache 先查"这个地址的拷贝在不在":在,命中,一两个时钟内交货;不在,缺失,启动 2.2 节讲过的完整总线周期去主存取,取回数据交给 CPU 的同时顺手把整行装进 Cache——下一拍大概率有人要访问它的邻居,这就是空间局部性的兑现方式。整行搬运的粒度叫缓存行,典型大小十六到六十四字节。
映射方式:住在哪个房间
主存远大于 Cache,"哪一行主存可以住进 Cache 的哪个房间"必须有规则,否则查找等于翻遍全楼。三种规则对应三种性格:
图 3-2:三种映射方式的房间分配规则
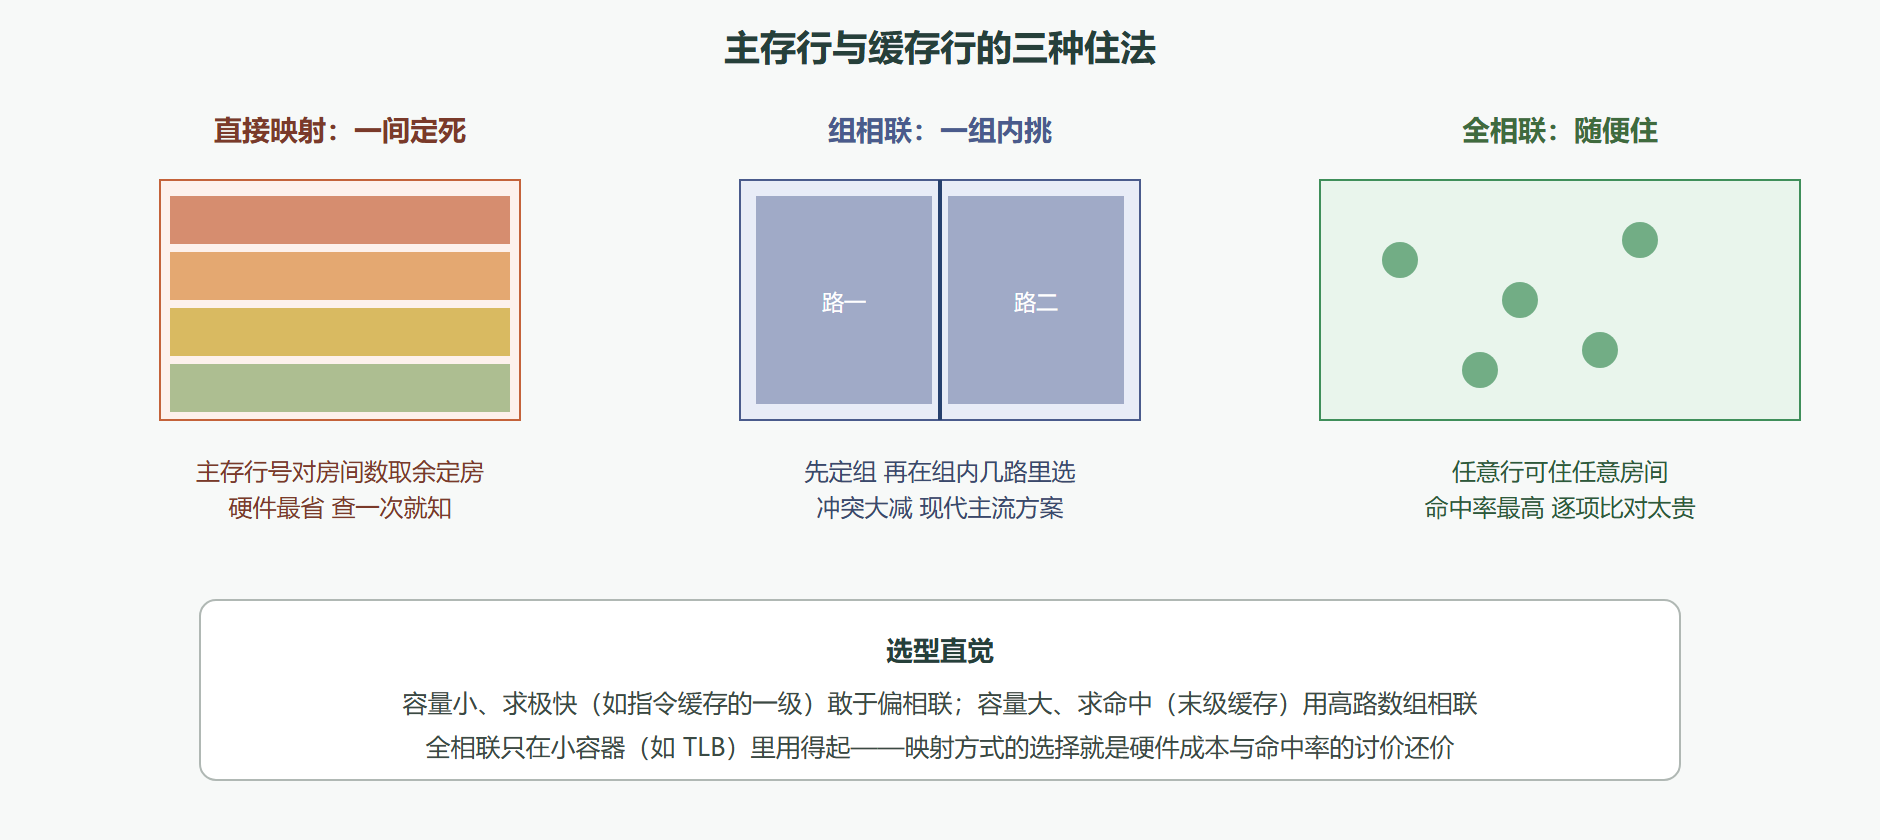
把规则落到算术上。设 Cache 容量 16KB、行大小 16 字节,则共 1024 行。直接映射下地址切成三段:低 4 位是行内偏移,中间 10 位是房间号(索引),剩下的是标签。一次访问到来,硬件拿索引找到唯一房间,比对标签:相符则命中,不符则腾房换人。二路组相联把 1024 行并成 512 组、每组两路,地址少切一位作索引、多留一位进标签,组内两路并行比对。全相联不设索引,标签就是整个高位地址,逐行比对——查找电路的规模随容量平方增长,只有几十行的容器(比如页表缓存)用得起。
写策略与替换:圈子里的事务规则
命中写怎么办,有两条路线。写穿:数据同时写进 Cache 与主存,一致性简单可靠,但每次写都霸占总线,写密集程序把总线堵成停车场。写回:只改 Cache,行上立一块"脏牌";被替换时若带脏牌才回写主存。它省总线却引入了悬空期——Cache 与主存暂时不等,DMA 设备绕过 Cache 读主存会读到旧数据,这个坑到第 6 章会正面撞上。
替换策略只对"组内几路都满"的场景有意义。最常用的是近期最少使用(LRU):每次命中给该路记一笔新鲜账,腾房时驱逐最久没被宠幸的那路。硬件用几位计数就能近似实现,命中率接近理论最优。
案例展开:一步之差的命中率悬崖
背景:图像处理同事反馈两段功能相同的代码性能相差悬殊——按列遍历比按行遍历慢了近一个数量级。操作:审查两段循环后确认算法等价,唯一差异是遍历方向。计算暴露机关:行大小 16 字节、二维数组每行 512 字节,按行访问时 32 个元素共享一次主存搬运,空间局部性拉满;按列访问时相邻两次访问的地址相距一行,每次都踩新的缓存行,而且当数组总大小超过 Cache 容量时,行还没焐热就被换出去了。结果:把外内层循环对调,耗时降至原来的九分之一,测量一次通过。解读:Cache 对程序透明,但绝不中立——访问模式决定它是助推器还是绞肉机。变式:并非所有"慢"都能靠换方向修,若数据结构本身按列存储(如列式数据库),按列遍历反而是对的——先问存储布局,再定遍历方向。
一次完整的手工查址
把映射规则演成算术。设 Cache 容量 16KB、行大小 16 字节、采用二路组相联,访问地址 0A8BCH。第一步,地址换二进制,低四位是行内偏移(0 到 15 字节),接着九位是组号(共五百一十二组),其余高位是标签。第二步,拿组号找到对应组,组内两路的标签同时与地址标签比对。第三步,比对相符且有效位为真,命中,读出行内对应字节;两路都不符,缺失,去主存取回整行,按 LRU 挑一路装入。整个过程硬件在半拍内并行完成,但每一步你都必须能在纸上重演——重演得出,调试 Cache 相关的性能问题才有抓手。
值得多说一句的是有效位与脏位。有效位标注"这一行装的是有效数据",上电清零,防止拿随机内容冒充缓存;脏位标注"这一行改过还没回写",写回策略的回写依据全在它身上。两位看似不起眼,缺了任何一个,一致性故事立刻崩盘。
映射方式的敏感性也值得做一次思想实验。同样的容量,直接映射下两组"热门"数据若恰好映射到同一行,就会反复互相驱逐——命中率被布局钉死;换成二路组相联,同一行的两个位置能同时收留这对冤家,冲突缺失大幅缓解;再往上加路数,收益递减,成本照涨。所以现实产品的路数普遍停在四到十六之间——映射方式的进化不是越高越好,而是在"冤家相撞的概率"与"比对电路的价格"之间找均衡点,这同样是 1.3 节意义上的取舍。
高频追问两则
问:为什么 Cache 不做得更大、映射不做得更灵活? 都在做,也都在付代价:容量翻倍,查找电路与功耗跟着翻倍,命中时间反而可能被拖长——一级缓存的命门是快,因此永远克制容量;灵活性同理,全相联的逐项比对只在小容器里用得起。分层分级正是对这些代价的回应。
问:多核时代每核一个 Cache,数据怎么保持一致? 靠一致性协议:每个缓存行带状态标记,某个核要改数据时,先让其他核手里的副本失效或转交。这套机制对程序员透明,但它的存在解释了两个现象——共享数据在核间"乒乓"时性能骤降,以及 3.3 节要讲的伪共享陷阱。
本节要点回顾
- 局部性是燃料:时间局部性兑现于命中,空间局部性兑现于整行填充。
- 映射三性格:直接映射省硬件但易冲突,组相联是主流折中,全相联只配小容器。
- 地址三段切分:偏移、索引、标签——手工能算,面试能考,调试能用。
- 写回与写穿的取舍:前者省总线但留悬空期,后者简单却堵路。
- 程序可以激怒 Cache:步长与行大小冲突时,命中率能掉到零。
机关看清了,下一站把视角拉回整座金字塔:命中率怎么算、平均访问时间怎么优化、程序员手里有哪些实打实的调节旋钮。